 P3T
딥시크 같은 공개 AI, 격차는 얼마나 줄었을까요
시험 점수로는 가까워졌지만 어려운 과제에서는 격차가 남았다는 평가가 나옵니다
- 무슨 일
- 공개 AI 와 폐쇄형 AI 의 격차를 점수표와 어려운 과제로 나눠 살펴봅니다.
- 확인된 것
- 몇 달 차이까지 따라왔다는 평가와 어려운 시험에서 격차가 남았다는 평가가 함께 나옵니다.
- 왜 중요한가
- 무엇을 보느냐에 따라 같은 질문에도 다른 결론이 나올 수 있습니다.
- 오늘 할 일
- 자주 하는 일 하나로 두 AI 의 결과를 나란히 비교합니다.
정리하면, 점수표로는 공개 AI 가 몇 달 차이까지 따라왔다는 평가가 나오지만 어려운 시험에서는 격차가 남았다는 평가도 있고, 내 일의 결과는 아직 확인되지 않았습니다.
딥시크(DeepSeek)처럼 학습 결과인 숫자값(가중치)을 공개한 AI 가 있습니다. 요금을 내고 쓰는 폐쇄형 AI 와 얼마나 가까워졌을까요. 시험 점수로 보면 몇 달 차이까지 따라왔다는 평가가 나옵니다1. 반면 가장 어려운 시험에서는 격차가 넓게 남아 있다는 평가도 있습니다2. 무엇을 보느냐에 따라 같은 질문에도 다른 결론이 나올 수 있습니다. 제 해석으로는 점수표 기준으로는 공개 AI 가 많이 따라온 편입니다. 기관별 평가와 한계를 차례로 보겠습니다.
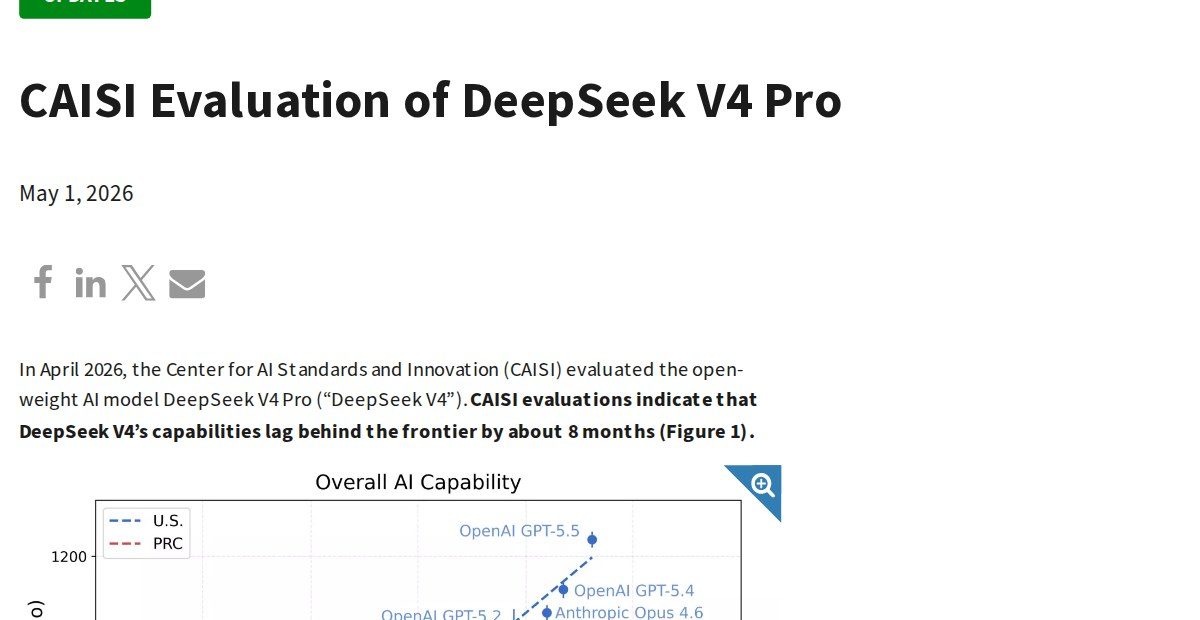
- 기관마다 격차를 4개월, 4~7개월, 약 8개월로 다르게 평가했습니다1.
- 가장 어려운 시험에서는 격차가 넓게 남아 있다는 평가가 있습니다2.
- CAISI 평가에서 딥시크 V4 는 딥시크가 직접 발표한 점수보다 낮게 나왔습니다3.
점수표로 보면 몇 달 차이까지 따라왔습니다
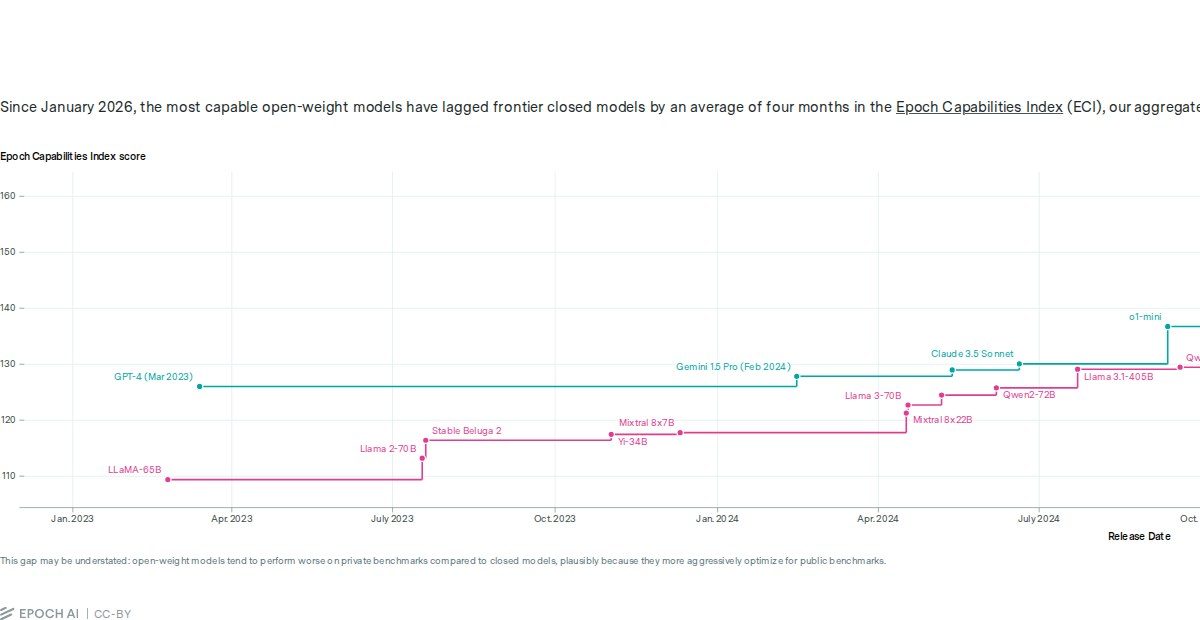
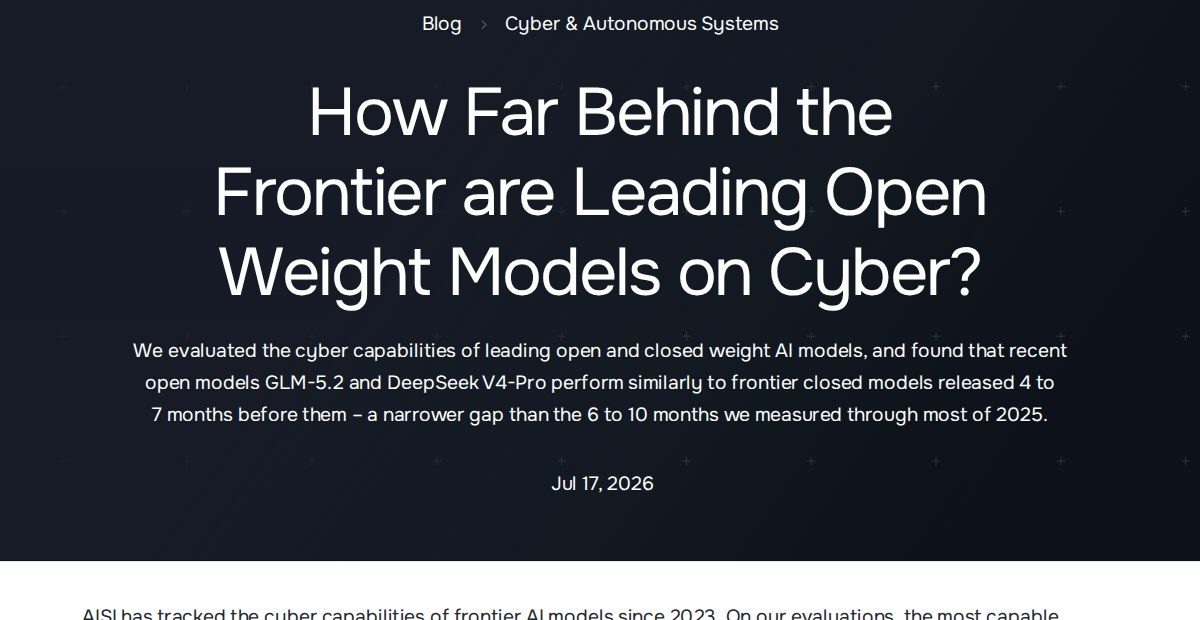
개월 단위로 격차를 평가한 기관은 셋입니다. Epoch AI 는 2026년 1월 이후 공개 가중치 모델 중 가장 뛰어난 모델이 폐쇄형 선두 모델보다 평균 4개월 뒤처진다고 평가했습니다1. 영국 AI안보연구소(AISI)는 사이버 능력 격차를 4~7개월로 평가했습니다1. 미국 CAISI 는 딥시크 V4 가 약 8개월 뒤처진다고 평가했습니다1.
대상과 시험이 달라 숫자도 다릅니다. Epoch AI 는 가장 뛰어난 공개 모델들을 봤습니다1. AISI 는 사이버 능력 격차를 평가했습니다1. CAISI 는 딥시크 V4 를 평가했습니다1.
AISI 는 사이버 능력의 공개·폐쇄형 격차가 2025년 대부분 기간보다 좁아졌다고 썼습니다4. 다만 AISI 는 가상 해킹 훈련장(사이버 레인지) 시험으로 비교한 결과를 더 약한 증거로 본다고 밝혔습니다5.
4월 30일 평가에서는 가장 어려운 과제의 공개 모델과 폐쇄형 모델 격차가 넓게 남아 있었습니다
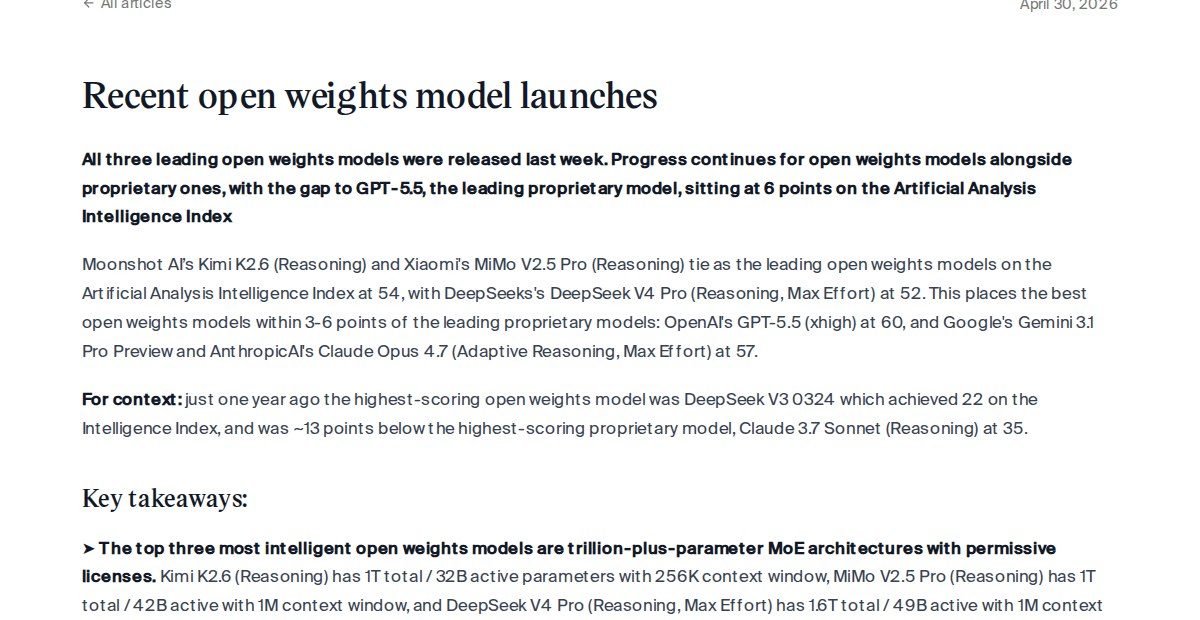
Artificial Analysis 는 가장 어려운 추론 시험과 에이전트형 코딩 시험에서 공개 모델과 폐쇄형 모델의 격차가 넓게 남아 있다고 썼습니다2. Artificial Analysis 의 이 글은 4월 30일에 나온 것이라 지금의 평가와는 다를 수 있습니다6.
점수를 누가 냈는지도 봐야 합니다. 미국 CAISI 는 딥시크 V4 점수가 CAISI 의 평가에서보다 딥시크 자체 평가에서 더 높게 나온다고 적었습니다3. Epoch AI 는 비공개 시험에서는 공개 모델의 성적이 더 나쁜 경향이 있다고 적었습니다7. 누구나 볼 수 있는 시험 문제에 공개 모델이 더 잘 맞춰져 있기 때문일 수 있다는 설명입니다7. 제 추론으로는 이 설명이 맞다면 4개월이라는 격차가 실제보다 작게 보이는 것일 수 있습니다.
제 해석으로는 점수표를 볼 때 제작사가 낸 점수인지 제3자가 잰 점수인지 먼저 봐야 합니다.
공개 AI 가 내 컴퓨터에서 폐쇄형 AI 만큼 해내는지는, 제가 찾은 범위에서는 확인된 자료가 없습니다
엔비디아는 Bolt 74B-A9B 24GB 모델을 RTX·DGX Spark 같은 자사 장비에서 직접(로컬로) 돌리도록 설계했다고 밝혔습니다8. 모델 안 숫자의 정밀도를 낮춰 크기를 줄이는 방식(양자화)으로 24GB 메모리에 맞췄다고 했습니다8. 이는 엔비디아의 회사 발표 내용입니다. 제가 찾아본 범위에서는 제3자가 측정한 자료가 없었습니다. 그래서 일반 그래픽카드에서 얼마나 빠르고 정확한지는 알 수 없습니다.
제 해석으로 정리하면 시험 점수로는 공개 AI 가 몇 달 차이까지 가까워졌습니다. 다만 내 일을 맡겼을 때 폐쇄형 AI 와 같은 결과가 나오는지는 아직 확인되지 않았습니다. 자주 하는 일 하나로 직접 비교해 보는 것이 가장 믿을 만한 방법입니다.
읽고 나서 해 볼 것
자주 하는 일 하나로 공개 모델과 쓰던 AI 의 결과를 나란히 비교해 보세요.
출처
각주 8개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- Epoch AI 는 가장 뛰어난 공개 가중치 모델이 폐쇄형 선두보다 평균 4개월, 영국 AI안보연구소(AISI)는 사이버 능력에서 4~7개월, 미국 CAISI 는 딥시크 V4 가 약 8개월 뒤처진다고 평가했다Since January 2026, the most capable open-weight models have lagged frontier closed models by an average of four monthshttps://epoch.ai/data-insights/open-closed-eci-gap확인 2026-10-21recent open weight models lag frontier closed models' cyber capabilities by 4 to 7 months.https://www.aisi.gov.uk/blog/how-far-behind-the-frontier-are-leading-open-weight-models-on-cyber확인 2026-10-21CAISI evaluations indicate that DeepSeek V4's capabilities lag behind the frontier by about 8 months (Figure 1).https://www.nist.gov/news-events/news/2026/05/caisi-evaluation-deepseek-v4-pro확인 2026-10-21↩
- Artificial Analysis 는 가장 어려운 추론과 에이전트형 코딩 시험에서 공개 모델과 폐쇄형 모델의 격차가 넓게 남아 있다고 썼다The gap to proprietary remains wide on the hardest reasoning and agentic coding evaluations.https://artificialanalysis.ai/articles/recent-open-weights-model-launches확인 2026-10-21↩
- CAISI 는 딥시크 V4 가 딥시크 자체 보고 평가에서 CAISI 평가보다 점수가 높게 나온다고 적었다DeepSeek V4 scores better on DeepSeek's self-reported evaluations than on CAISI evaluations.https://www.nist.gov/news-events/news/2026/05/caisi-evaluation-deepseek-v4-pro확인 2026-10-21↩
- AISI 는 사이버 영역의 이 격차가 2025년 대부분 기간에 측정한 값보다 좁아졌다고 썼다a narrower gap than the 6 to 10 months we measured through most of 2025.https://www.aisi.gov.uk/blog/how-far-behind-the-frontier-are-leading-open-weight-models-on-cyber확인 2026-10-21↩
- AISI 는 사이버 레인지 시험으로 비교한 결과를 더 약한 증거로 본다고 밝혔다we treat the comparison from our ranges as weaker evidencehttps://www.aisi.gov.uk/blog/how-far-behind-the-frontier-are-leading-open-weight-models-on-cyber확인 2026-10-21↩
- Artificial Analysis 의 이 글은 2026년 4월 30일에 올라왔다April 30, 2026https://artificialanalysis.ai/articles/recent-open-weights-model-launches확인 2026-10-21↩
- Epoch AI 는 비공개 시험에서는 공개 모델이 폐쇄형 모델보다 성적이 나쁜 경향이 있고, 공개 시험에 더 적극적으로 맞춰 최적화하기 때문일 수 있다고 적었다First, evidence suggests that open-weight models tend to perform worse on private benchmarks compared to closed models, plausibly because they more aggressively hillclimb on public benchmarks.https://epoch.ai/data-insights/open-closed-eci-gap확인 2026-10-21↩
- 엔비디아는 Bolt 74B-A9B 24GB 모델을 로컬에서 돌리도록 설계했고 2비트 양자화로 24GB 메모리에 맞췄다고 밝혔다Bolt 74B-A9B 24GB is designed to run everyday agentic tasks locally on NVIDIA RTX/DGX Spark, using a native 2-bit quantization to fit in 24GB of memory and run alongside other applications.https://blogs.nvidia.com/blog/nemotron-3-5-super-vl/확인 2026-10-21↩