 P3T
AI 토큰 요금, 대화가 길면 비싸지는 이유 셋
토큰이 두 배가 되면 비교할 쌍은 네 배가 됩니다 — 느려지는 자리가 여기입니다
- 무슨 일
- 긴 글을 넣으면 답이 늦게 시작되고 사용량이 빠르게 늡니다.
- 확인된 것
- 셀프 어텐션은 길이의 제곱으로 늘고, 캐시된 입력은 정가의 10분의 1입니다.
- 왜 중요한가
- 대화를 이어 갈수록 앞의 대화가 매번 다시 요금에 실립니다.
- 오늘 할 일
- 주제가 바뀌면 새 창을 열고 필요한 부분만 다시 붙입니다.
긴 입력은 어텐션 계산과 메모리 사용을 늘리고, API 요금과 한도는 주로 오간 토큰 수에 따라 커집니다.
AI에 긴 문서를 넣으면 답이 늦게 시작됩니다. 대화가 길어지면 사용량도 빠르게 늘어납니다. 함께 나타나는 현상이지만 원인은 하나가 아닙니다.
입력을 읽을 때는 어텐션 계산이 늘고, 답을 한 토큰씩 만들 때는 저장된 값을 옮기는 속도가 중요해집니다. API 요금과 사용 한도는 주로 처리한 토큰 수에 따라 정해집니다. 오늘은 이 세 가지를 나눠 살펴봅니다.
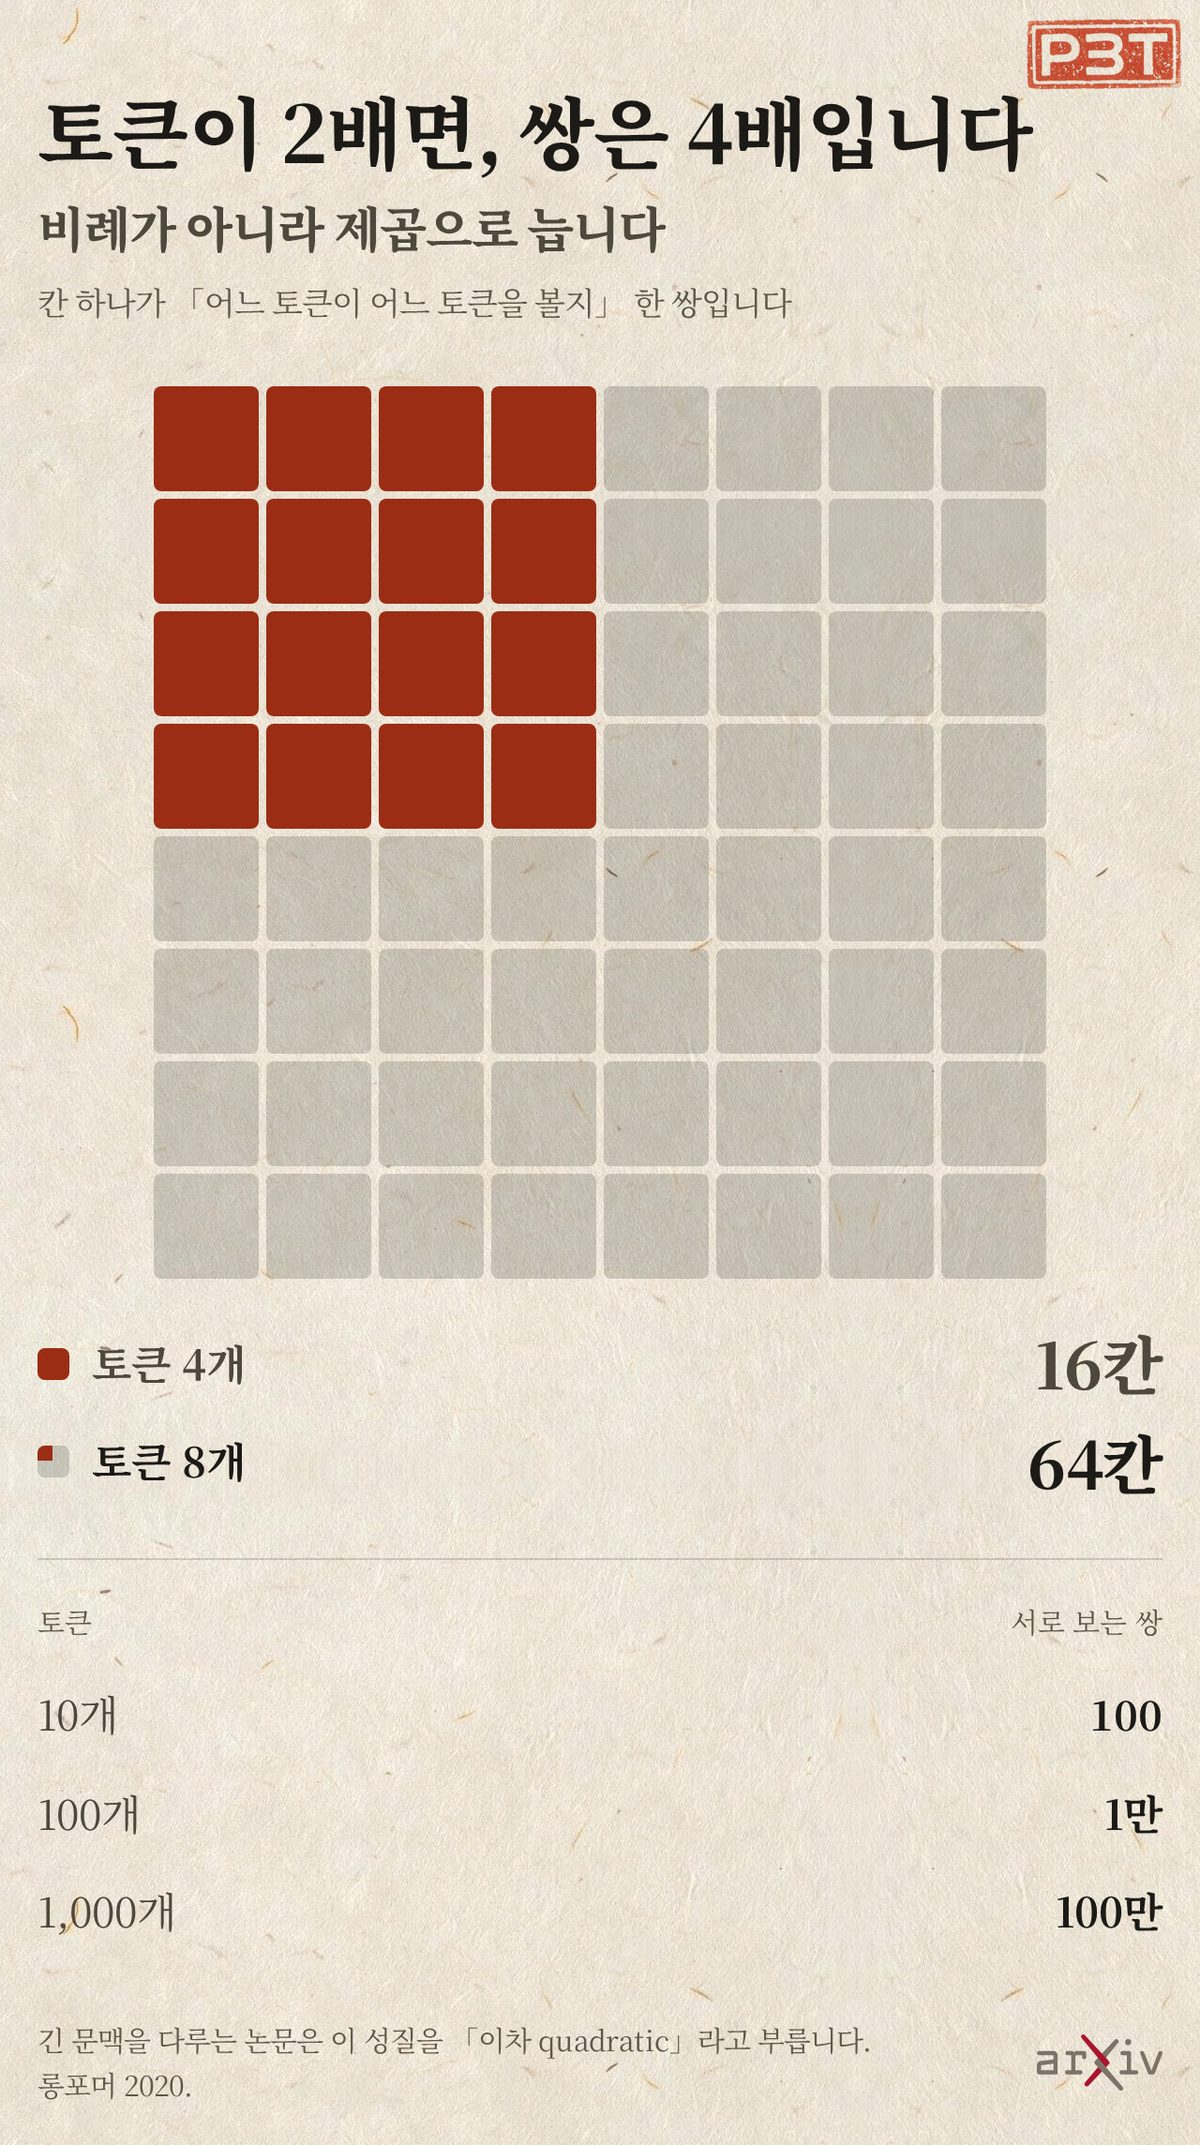
토큰이 2배가 되면 비교는 4배가 됩니다
기본적인 셀프 어텐션은 토큰을 다른 토큰들과 비교합니다. 토큰이 10개면 토큰 한 개당 다른 10개와 비교해야 하니 10 x 10이 되어 비교할 쌍은 100개, 100개면 100 x 100으로 1만 개, 1,000개면 1,000 x 1,000으로 100만 개가 됩니다. 길이에 비례해서 느는 게 아니라 제곱으로 늡니다.
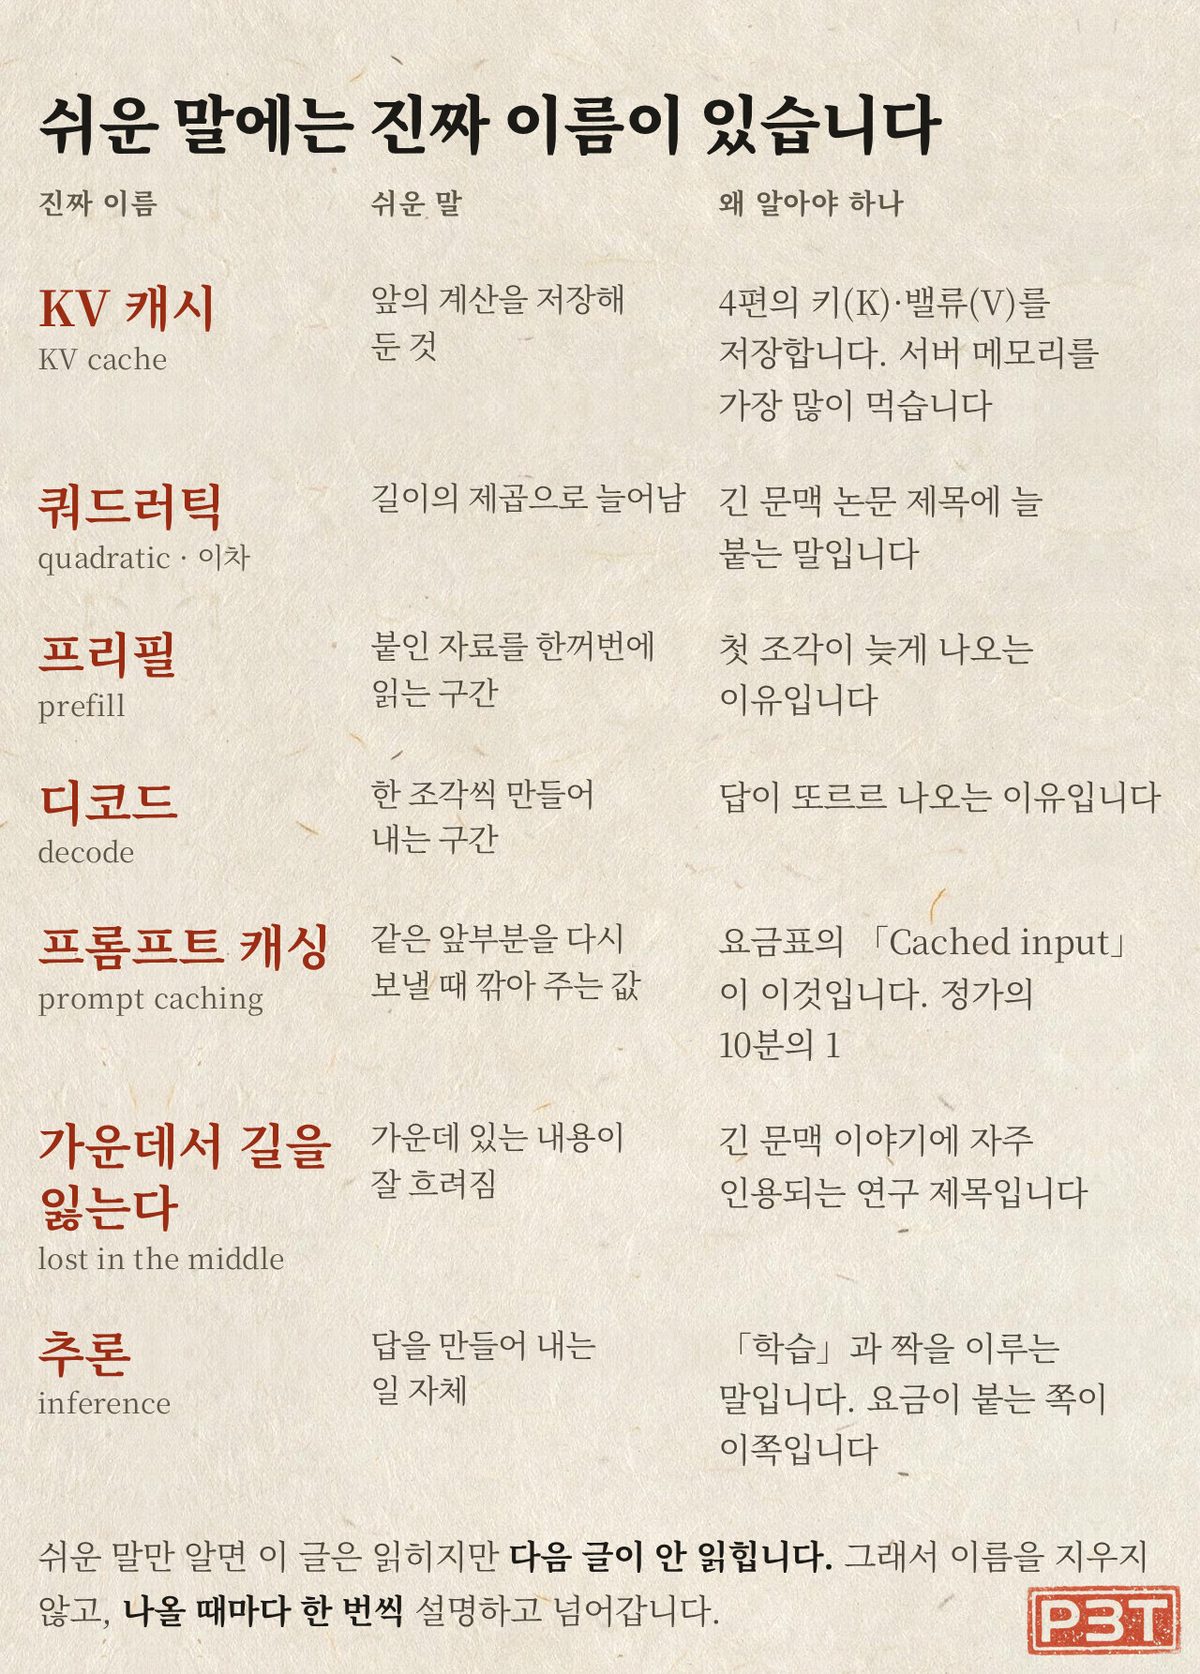
이를 이차적 증가(quadratic)라고 합니다. 2020년 롱포머 논문도 기본 셀프 어텐션의 계산량이 입력 길이의 제곱에 비례해 증가한다고 설명했습니다1.
이 계산량은 긴 자료를 넣었을 때 첫 답이 늦게 나오는 이유 중 하나입니다. 답을 만들기 전에 입력 전체의 관계를 계산해야 하기 때문입니다. 다만 최신 모델은 모든 토큰을 비교하지 않고 일부 토큰만 보거나 계산을 줄이는 방식을 쓰기도 하므로 모든 모델이 정확히 같은 비용을 내는 것은 아닙니다.
그래서 앞의 계산을 저장해 둡니다
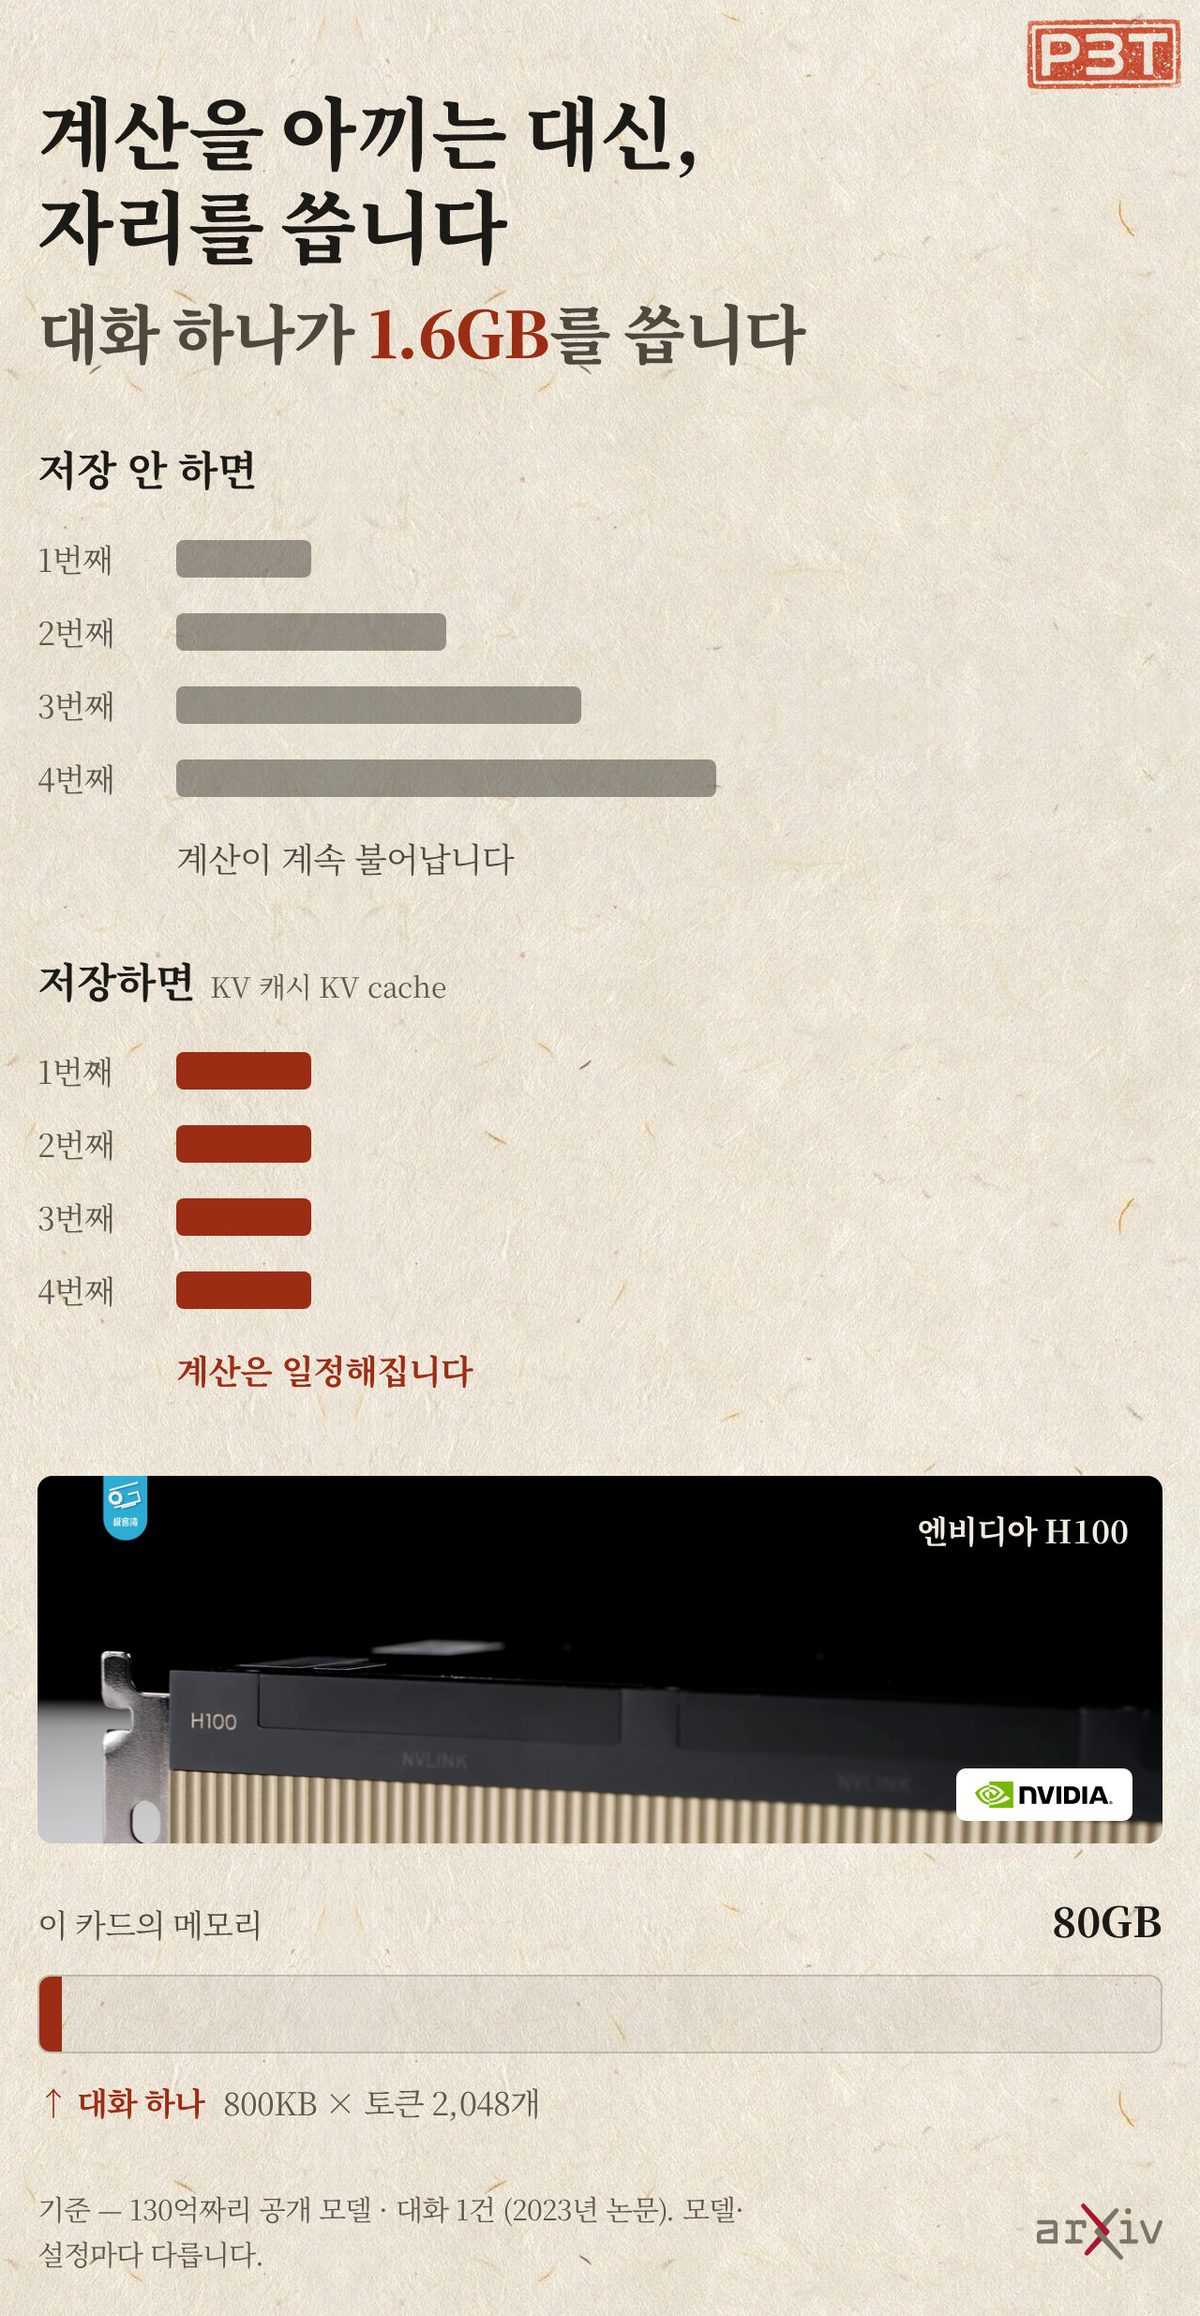
답을 한 토큰 만들 때마다 앞부분을 처음부터 다시 계산하면 낭비가 큽니다. 그래서 모델은 이미 계산한 키(key)와 밸류(value)를 저장해 다시 사용합니다. 이를 KV 캐시(KV cache)라고 합니다2.
이름 때문에 오해하기 쉽지만 웹 브라우저 캐시처럼 「본 것을 그대로 넣어 둔 것」이 아닙니다. 각 토큰에서 계산한 어텐션용 숫자 묶음을 저장합니다. 덕분에 다음 토큰을 만들 때는 이전 토큰의 키와 밸류를 다시 계산하지 않아도 됩니다.
대신 KV 캐시는 GPU 메모리를 차지합니다. 2023년 vLLM 논문이 예로 든 OPT-13B 모델에서는 토큰 하나의 KV 캐시에 약 800KB가 필요했습니다. 2,048토큰을 채우면 요청 하나의 KV 캐시가 약 1.6GB에 이릅니다3. 이는 당시 특정 모델과 정밀도를 기준으로 한 값이며, 실제 크기는 모델 구조와 설정에 따라 달라집니다.
컨텍스트 윈도우(context window)라는 모델이 한 번에 참고할 수 있는 제한된 토큰 범위 안에 입력과 출력이 함께 들어갑니다. 대화가 길어질수록 KV 캐시도 커지고, 동시에 처리할 수 있는 요청 수는 줄어들 수 있습니다.
KV 캐시는 계산을 줄이는 대신 메모리를 사용하는 맞바꿈입니다.
읽을 때와 쓸 때는 하는 일이 다릅니다
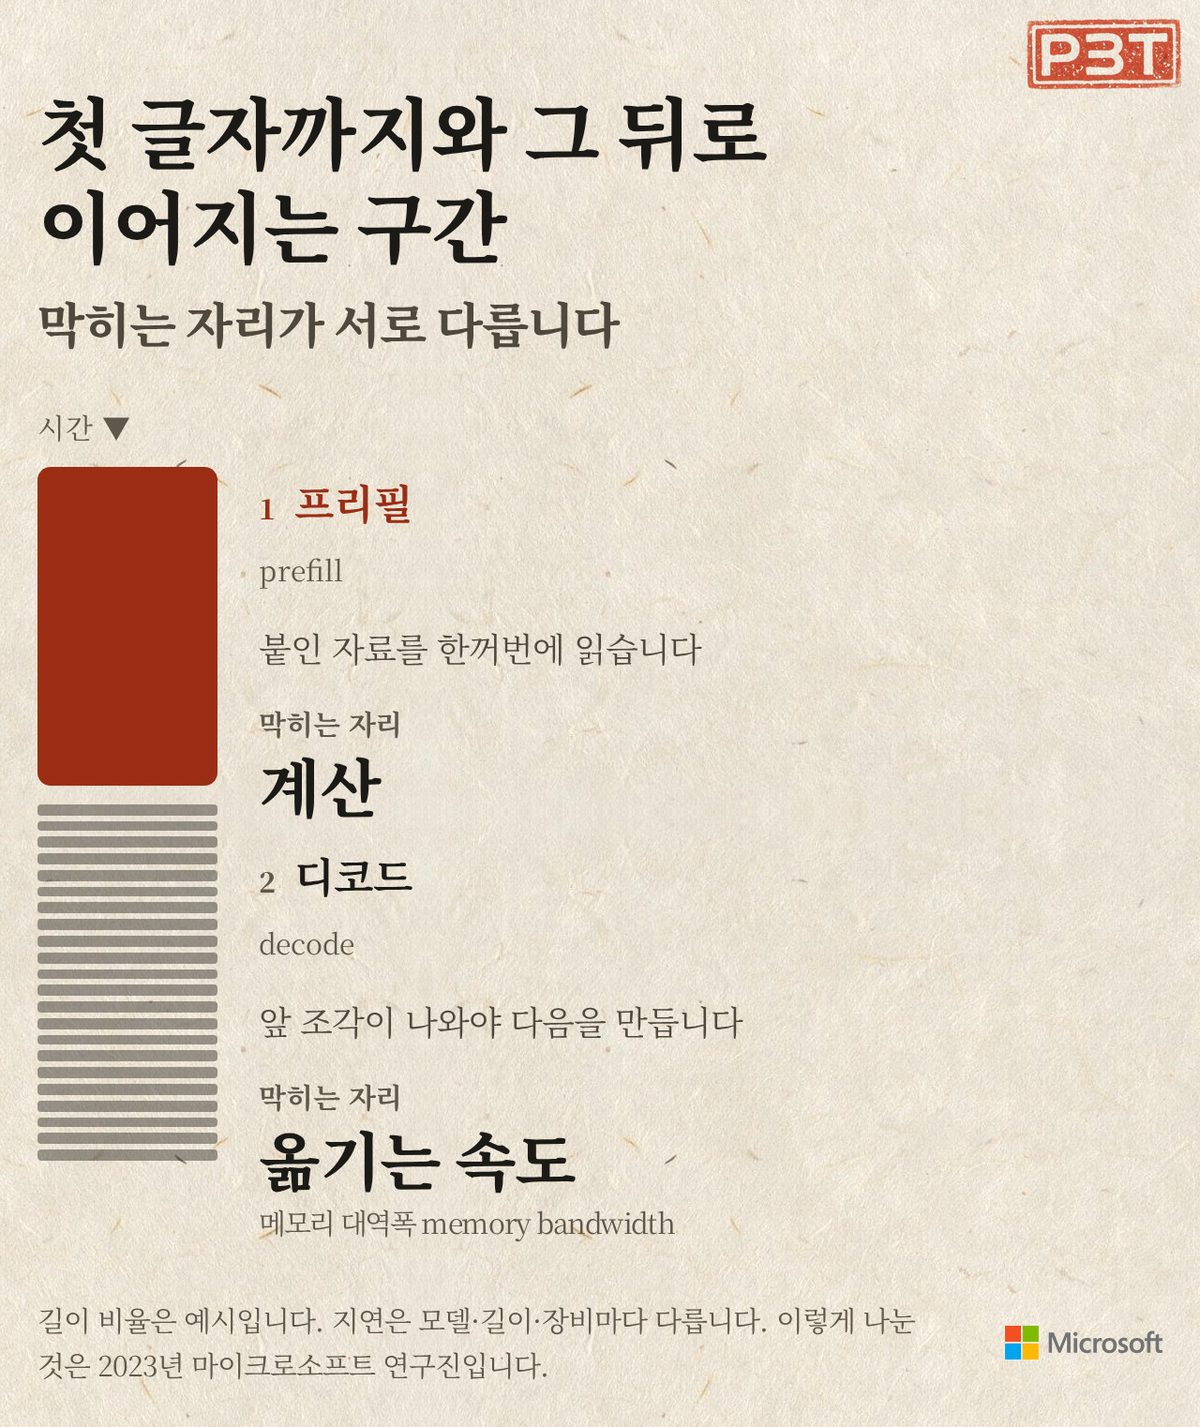
AI는 답을 시작하기 전 잠시 뜸을 들이다가, 그 뒤로는 한 토큰씩 글을 이어 갑니다. 두 구간이 하는 일이 다르기 때문입니다.
먼저 입력된 글 전체를 처리하는 구간을 프리필(prefill)이라고 합니다. 여러 입력 토큰을 한꺼번에 계산할 수 있지만, 긴 자료일수록 계산량이 많아집니다.
그다음 답을 한 토큰씩 만드는 구간을 디코드(decode)라고 합니다. 앞 토큰이 나와야 다음 토큰을 만들 수 있어 순서대로 진행됩니다.
2023년 마이크로소프트 연구진은 프리필을 계산 성능의 영향을 많이 받고, 디코드는 저장된 값을 불러오는 메모리 속도에 막히기 쉽다고 설명했습니다4. 2019년 연구도 같은 점을 짚었습니다. 학습은 여러 위치를 한꺼번에 계산할 수 있지만, 한 토큰씩 만들어 내는 추론은 키·밸류 데이터를 반복해 읽어야 합니다. 그래서 저장된 값을 옮기는 통로의 속도, 즉 메모리 대역폭의 영향을 크게 받는다고 설명했습니다5.
다만 실제 속도에는 모델 크기, 서버의 요청량, 네트워크와 서비스 설정도 영향을 줍니다. AI가 느린 이유를 어텐션이나 메모리 하나로만 단정할 수는 없습니다.
대화가 길어지면 사용량도 늘어납니다
모델은 이전 대화를 스스로 기억하지 않습니다. 대화를 이어 가려면 새 질문과 앞선 대화도 다시 전달해야 합니다. 사용자는 한 줄만 입력했지만, 모델은 그때까지의 대화 전체를 다시 받을 수 있습니다. 그래서 대화가 길어질수록 사용량도 늘어납니다. 앤트로픽 고객 지원 문서도 대화가 길어지면 사용량 한도를 더 쓴다고 적어 두었습니다6.
API 요금표는 보통 입력 토큰, 출력 토큰, 캐시된 입력 토큰으로 나뉩니다. 실제 계산량과 정확히 비례하기보다 처리한 토큰 수를 기준으로 매겨집니다.
캐시된 입력이 흥미롭습니다. 같은 앞부분을 다시 읽을 때 값을 크게 깎아 줍니다. 앤트로픽과 오픈AI 모두 일부 모델에서 캐시된 입력에 일반 입력 가격의 10%를 적용합니다7. 서로 다른 회사가 같은 가격 정책을 운영하고 있습니다.
다만 캐시에 처음 저장할 때는 추가 비용이 들 수 있습니다. 앤트로픽은 5분 저장에 일반 입력의 1.25배, 1시간 저장에 2배를 받습니다7. 따라서 한 번만 사용할 자료라면 캐시가 이득이 아닐 수 있습니다. 가격은 바뀔 수 있으므로 실제 모델의 최신 요금표를 확인해야 합니다.
긴 자료를 많이 넣는다고 답이 항상 좋아지는 것도 아닙니다. 2023년 연구에서는 필요한 정보가 긴 입력의 앞이나 끝에 있을 때보다 가운데 있을 때 성능이 낮아지는 현상이 나타났습니다8.
최신 요금은 오픈AI의 developers.openai.com과 앤트로픽의 platform.claude.com에서 확인할 수 있습니다. 일반 채팅 구독 상품은 API와 요금 체계가 다르므로 구분해서 봐야 합니다.
다음 편에서는 지금까지 본 것들을 개인 컴퓨터에서 직접 확인하는 방법을 살펴봅니다.
읽고 나서 해 볼 것
긴 대화에서 앞부분이 더는 필요 없다면 새 대화를 열고 핵심만 요약해 옮겨 보세요. 중요한 근거는 질문 가까이에 두고, 필요 없는 기록은 덜어 내는 편이 속도·비용·정확도에 모두 도움이 됩니다.
출처
각주 8개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 2020년 롱포머 논문은 트랜스포머 기반 모델이 긴 문서를 처리하지 못하는 이유로 셀프 어텐션이 시퀀스 길이에 대해 이차적으로 증가한다는 점을 든다Transformer-based models are unable to process long sequences due to their self-attention operation, which scales quadratically with the sequence length.https://arxiv.org/abs/2004.05150확인 2026-09-02↩
- 2023년 논문은 KV 캐시를 어텐션 메커니즘에 딸린 키·밸류 텐서이며 흔히 그렇게 불린다고 적는다the key and value tensors associated with the attention mechanism, commonly referred to as KV cachehttps://arxiv.org/abs/2309.06180확인 2026-09-02↩
- vLLM 논문(arXiv 2309.06180)은 130억 파라미터 OPT 모델에서 토큰 하나의 KV 캐시가 800킬로바이트이고 최대 2,048토큰 기준 요청 하나가 최대 1.6기가바이트에 이른다고 적는다For the 13B parameter OPT model...the KV cache of a single token demands 800 KB of space...Since OPT can generate sequences up to 2048 tokens, the memory required to store the KV cache of one request can be as much as 1.6 GB.https://arxiv.org/abs/2309.06180확인 2026-09-02↩
- 2023년 마이크로소프트 연구진의 논문은 프롬프트 계산이 계산 집약적이고 토큰 생성이 메모리 집약적이며 둘의 지연·처리량·메모리·전력 특성이 다르다고 적었다a compute-intensive prompt computation, and a memory-intensive token generation, each with distinct latency, throughput, memory, and power characteristics.https://arxiv.org/abs/2311.18677확인 2026-09-02↩
- 2019년 구글 연구자의 논문은 학습은 시퀀스 길이 방향 병렬화로 빠른 반면 병렬화가 불가능한 점진적 추론은 크고 무거운 키·밸류 텐서를 반복해 불러오는 메모리 대역폭 비용 때문에 느린 경우가 많다고 적었다While training these layers is generally fast and simple, due to parallelizability across the length of the sequence, incremental inference (where such paralleization is impossible) is often slow, due to the memory-bandwidth cost of repeatedly loading the large "keys" and "values" tensors.https://arxiv.org/abs/1911.02150확인 2026-09-02↩
- 앤트로픽 고객 지원 문서는 자동 문맥 관리가 걸릴 만큼 긴 대화가 사용량 한도를 더 소모한다고 적는다Longer conversations that trigger automatic context management consume more of your usage limit.https://support.claude.com/en/articles/11647753-how-do-usage-and-length-limits-work확인 2026-09-08↩
- 오픈AI와 앤트로픽은 주력 모델의 캐시된 입력 토큰 값을 표준 입력 가격의 10분의 1로 매긴다A cache hit costs 10% of the standard input price, which means caching pays off after one cache read for the 5-minute duration (1.25x write), or after two cache reads for the 1-hour duration (2x write).https://platform.claude.com/docs/en/about-claude/pricing확인 2026-09-02gpt-5.6-terra ... Input $2.00 | Cached input $0.20 | Output $12.00https://developers.openai.com/api/docs/pricing확인 2026-09-02↩
- 2023년 연구는 관련 정보가 입력의 앞이나 끝에 있을 때 성능이 가장 높고 긴 문맥의 가운데에 있을 때 크게 떨어지며 긴 문맥용 모델에서도 그렇다고 보고했다we observe that performance is often highest when relevant information occurs at the beginning or end of the input context, and significantly degrades when models must access relevant information in the middle of long contexts, even for explicitly long-context models.https://arxiv.org/abs/2307.03172확인 2026-09-02↩