 P3T
AI 할루시네이션, 「모른다」 대신 지어내는 이유
정답률만으로 채점하면 「모른다」는 답이 손해가 됩니다 — 그래서 환각이 남습니다
- 무슨 일
- AI 가 없는 판례와 자료를 태연한 말투로 인용합니다.
- 확인된 것
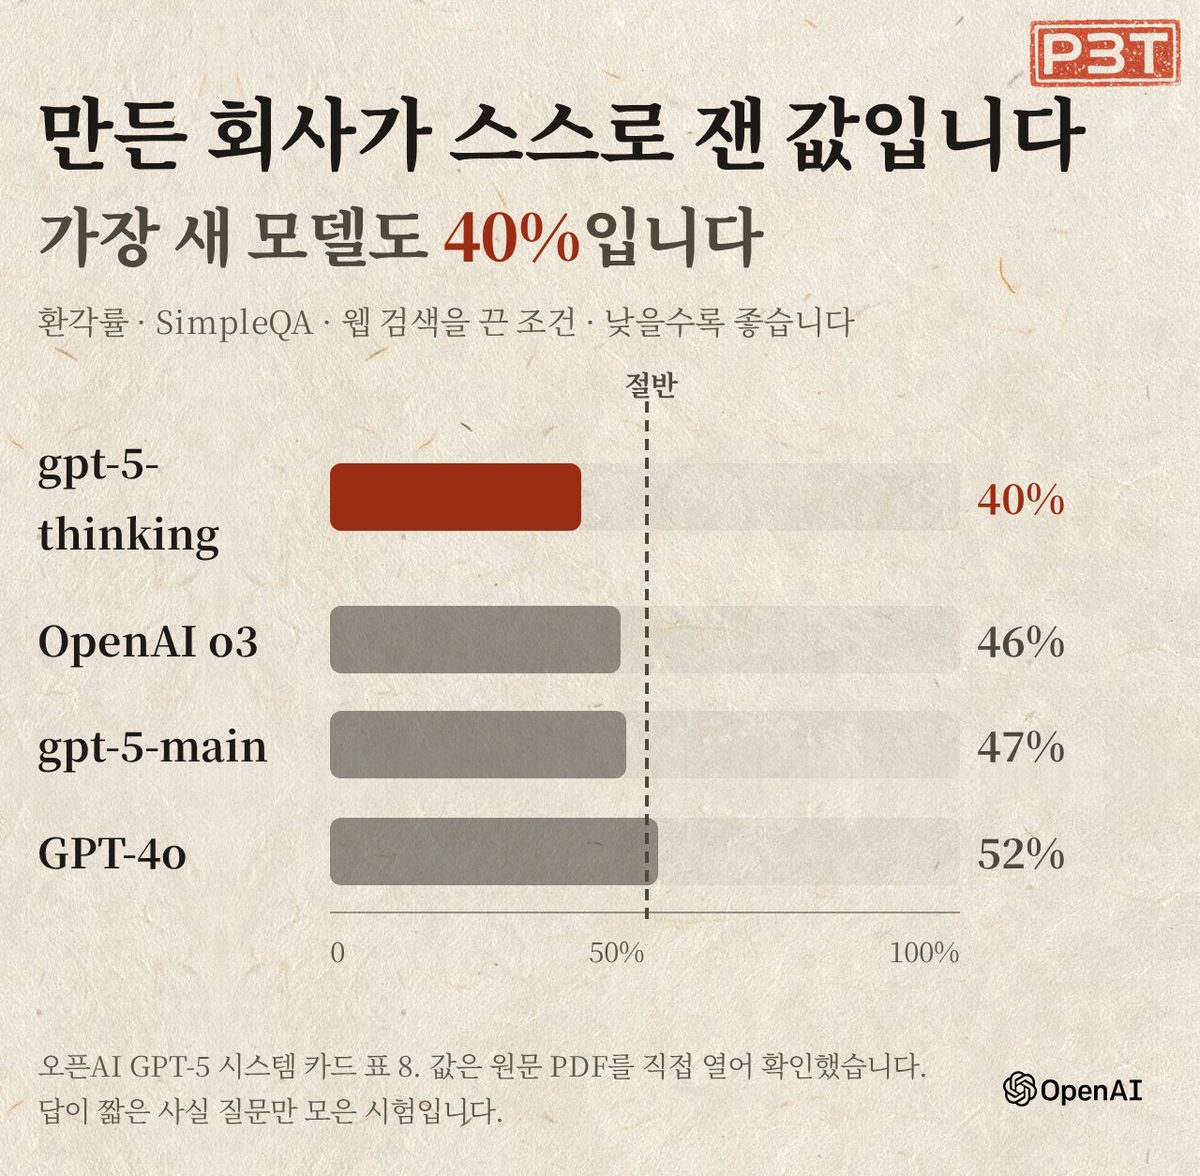
- 오픈AI 자체 측정에서 gpt-5-thinking 의 환각률은 40% 입니다.
- 왜 중요한가
- 모른다고 답하면 0점이라, 지어내는 쪽이 채점표에서 유리합니다.
- 오늘 할 일
- 인용된 판례·논문은 제목을 그대로 검색해 봅니다.
AI 환각은 그럴듯한 말을 배우며 생기고, 추측에 유리한 평가 때문에 남습니다.
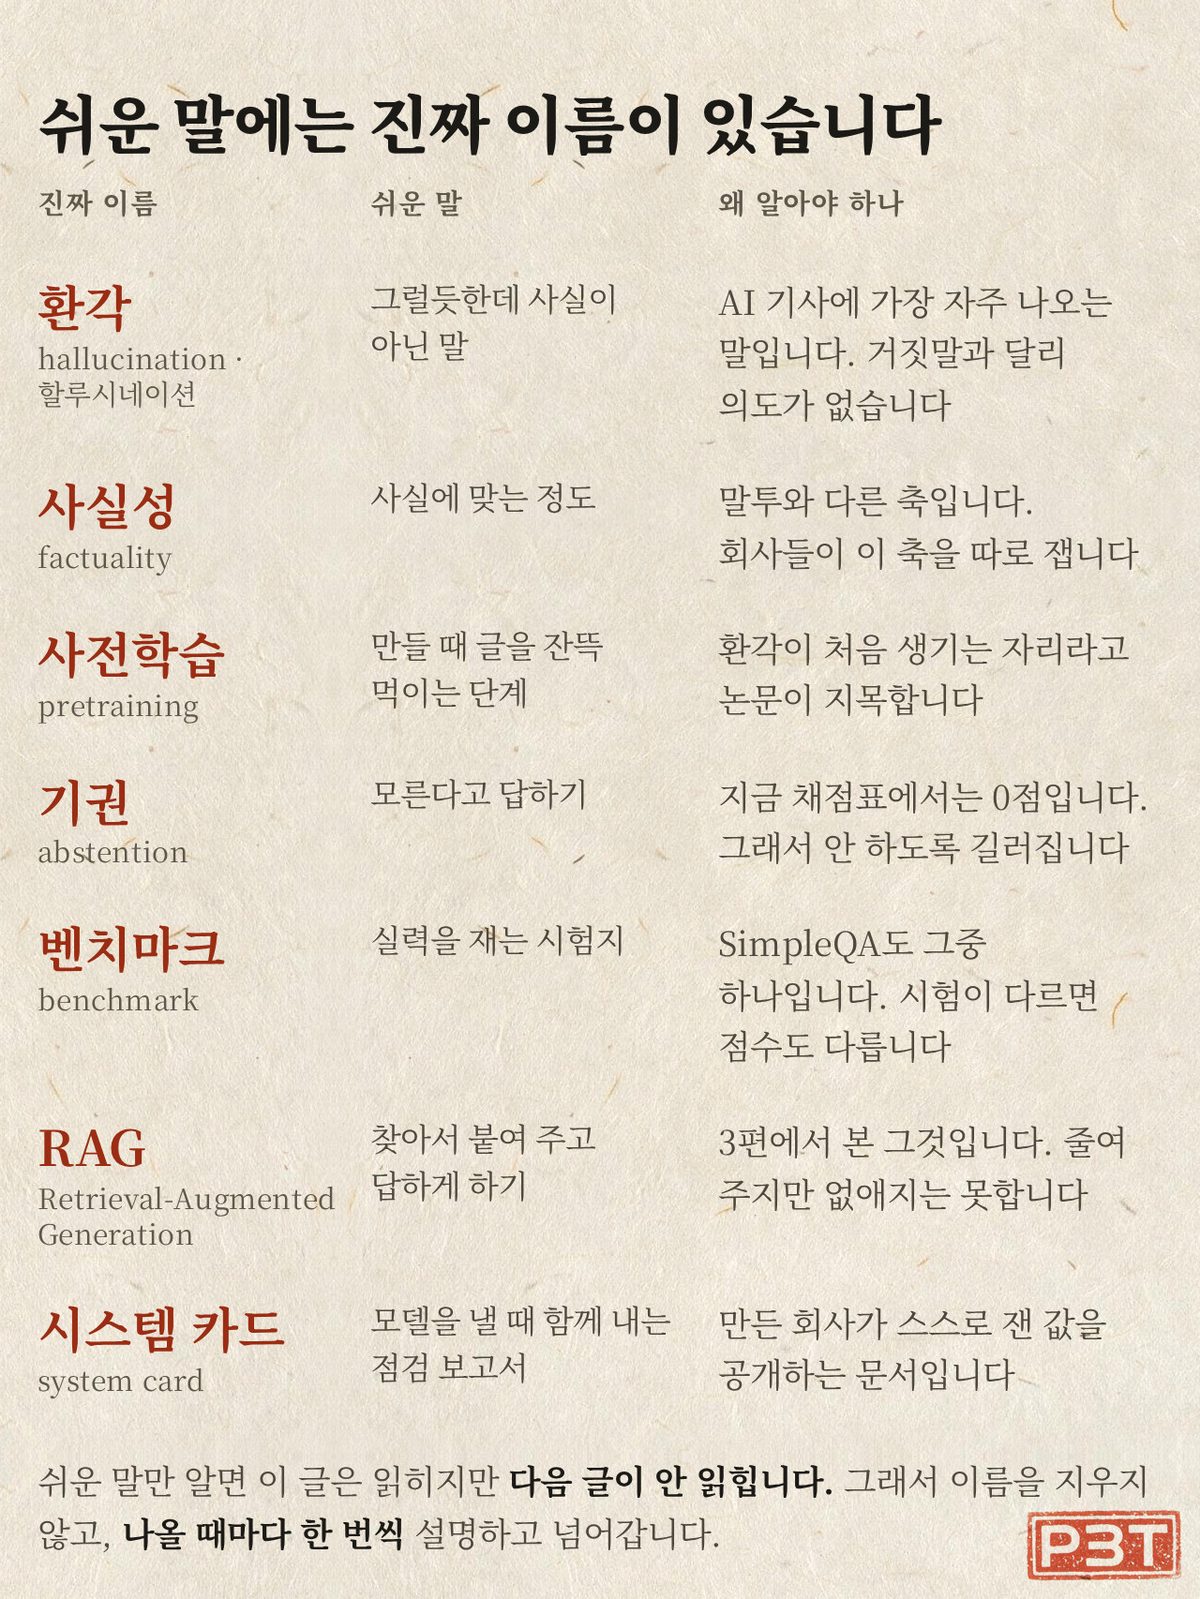
AI는 존재하지 않는 판례나 자료를 인용하기도 합니다. 그런데 말투는 태연합니다. 이런 현상을 환각(hallucination)이라고 합니다. 왜 모르는 내용을 지어내고도 「모르겠습니다」라고 하지 않을까요?
오픈AI 연구진은 원인을 두 층으로 나눕니다. 환각이 처음 생기는 이유와, 학습을 거친 뒤에도 사라지지 않는 이유입니다.
환각은 사람의 거짓말과 다릅니다
오픈AI는 환각을 언어 모델이 만드는 그럴듯하지만 거짓인 진술이라고 정의합니다1. 앤트로픽도 뛰어난 모델조차 사실과 다르거나 주어진 문맥에 어긋나는 내용을 만들 수 있다고 설명합니다2.
이를 사람의 거짓말과 똑같이 보기는 어렵습니다. 거짓말에는 사실을 알면서 감추려는 의도가 필요하지만, 언어 모델은 문맥에 이어질 가장 자연스러울 다음 토큰을 계산해 문장을 만듭니다.
지난 글에서 본 확률표를 떠올려 보세요. 후보마다 점수는 있지만, 사실인지 확인하는 별도의 칸은 없습니다. 모델은 학습한 사실을 활용할 수는 있어도, 마지막 토큰을 고르는 과정 자체가 사실 검증인 것은 아닙니다. 자연스러운 문맥 생성과 팩트 체크는 서로 다른 문제입니다.
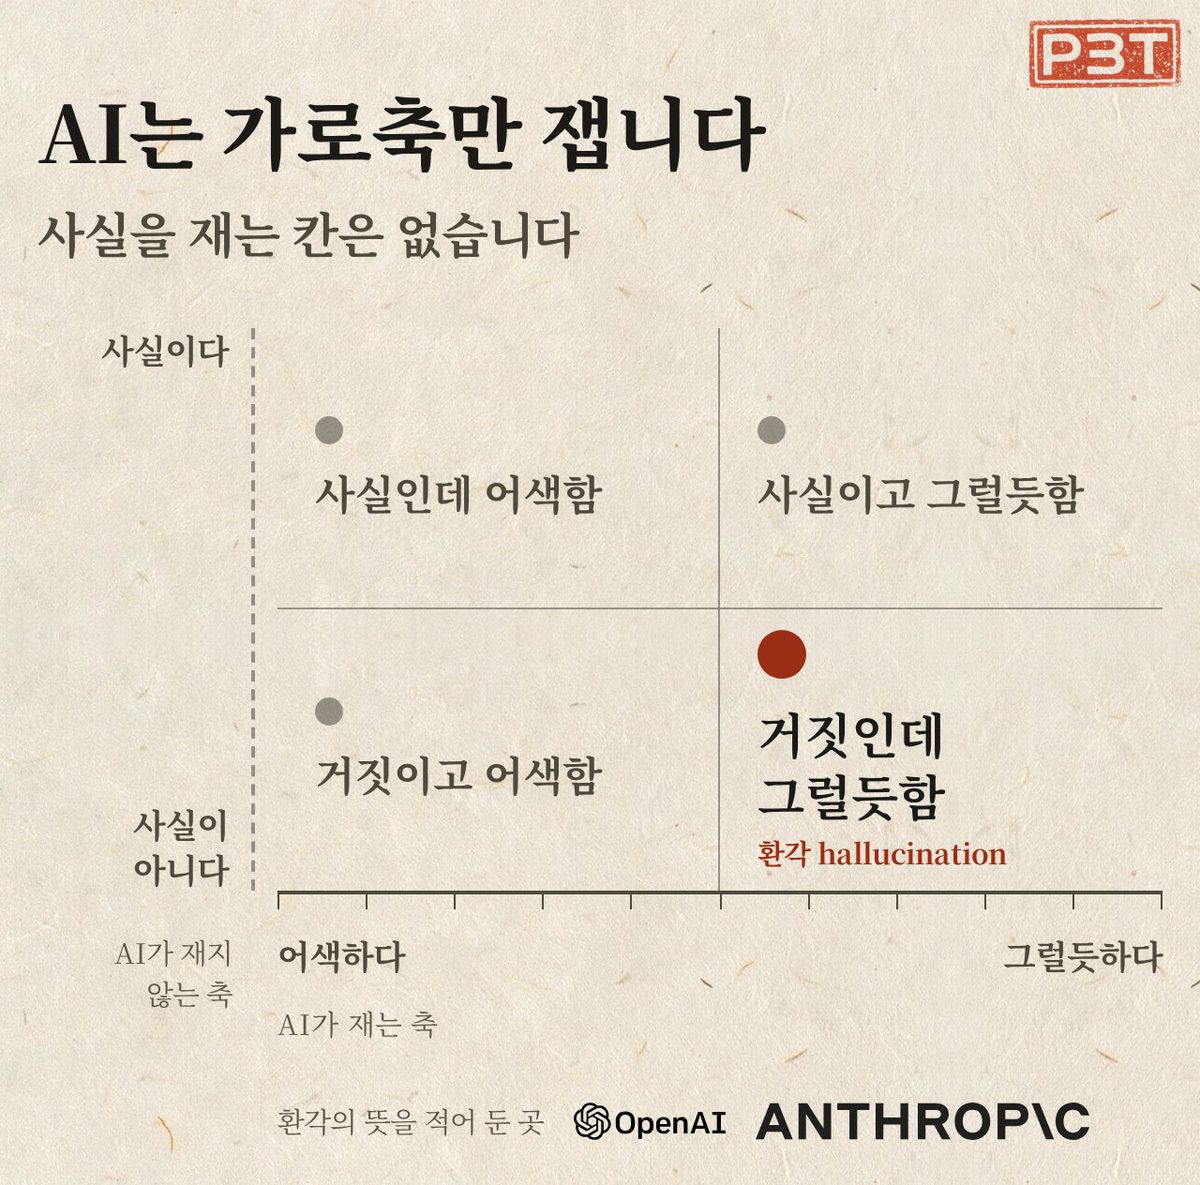
환각이 생기는 이유와 남는 이유는 다릅니다
2025년 오픈AI 연구진의 논문은 환각이 처음 생기는 이유와, 학습 뒤에도 계속 남는 이유를 나누어 설명합니다.
첫 번째는 만들 때의 학습, 곧 사전학습(pre-training)입니다. 학습 자료에는 자주 반복되는 정보도 있지만, 드물게 나오거나 일정한 규칙이 없는 정보도 있습니다. 모델이 이런 정보의 참과 거짓을 충분히 구분하지 못하면 통계적으로 그럴듯한 오답을 만들 수 있습니다3.
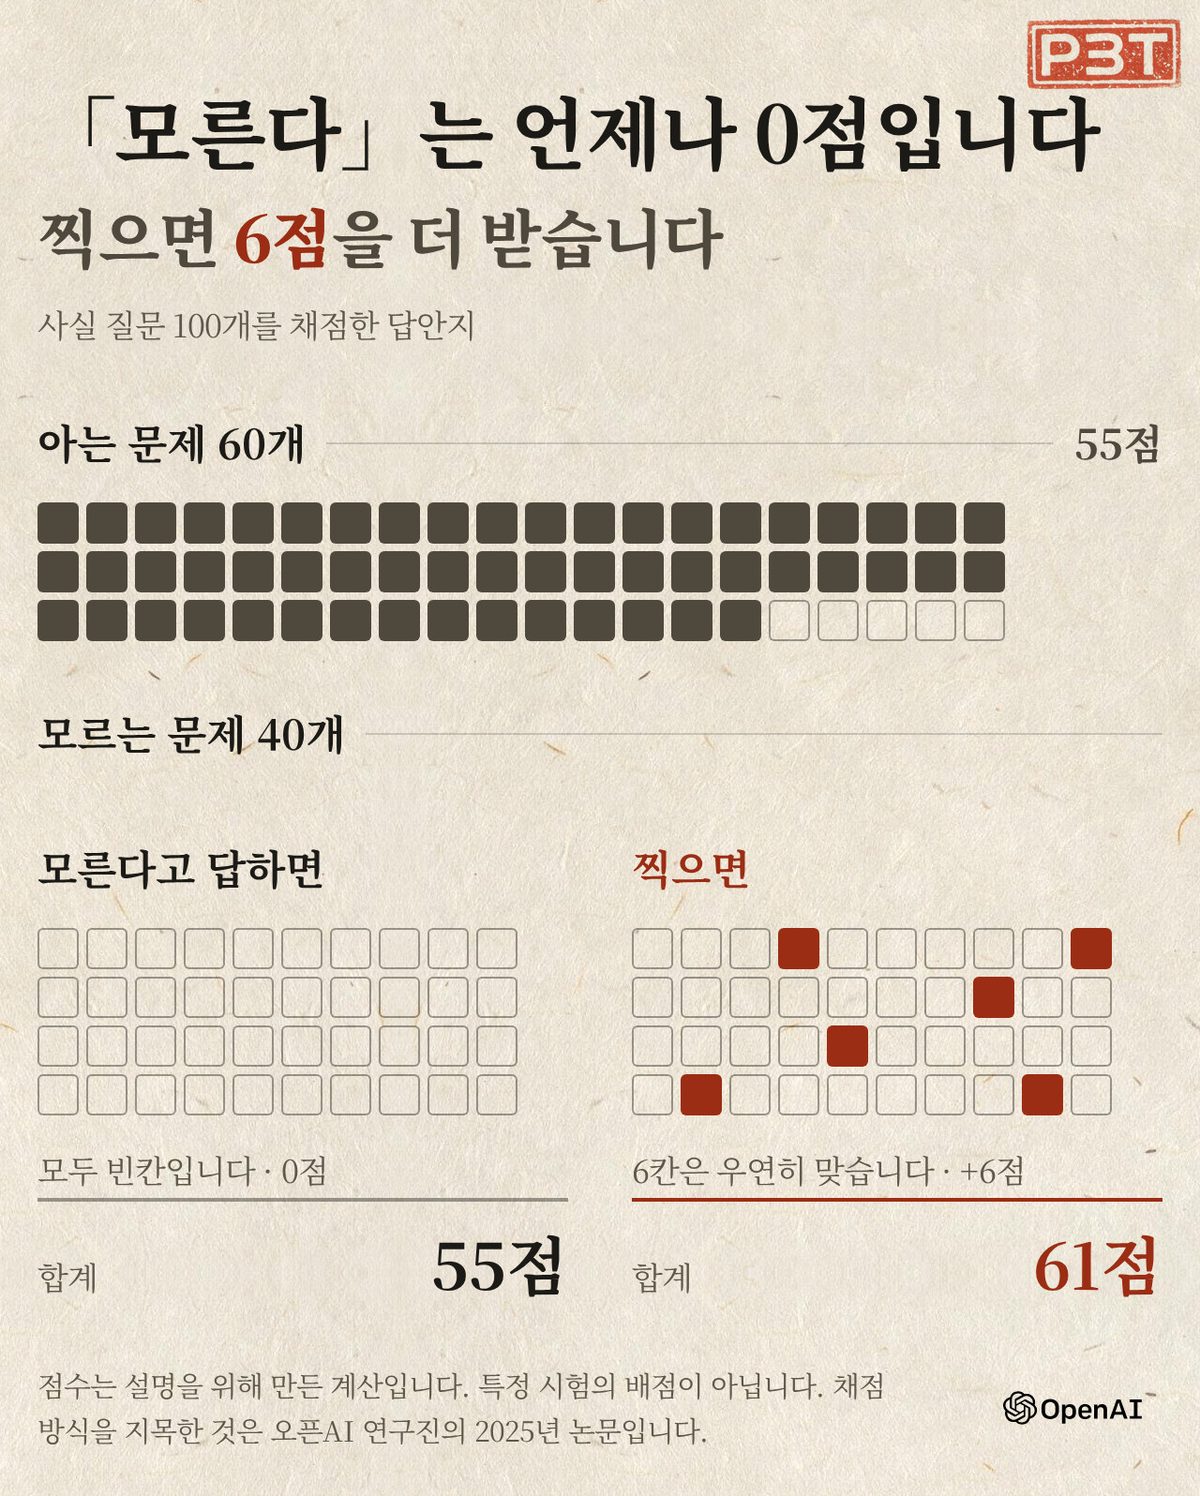
두 번째는 평가 방식입니다. 오픈AI는 정답을 맞힌 비율만으로 모델을 평가하면 「모르겠다」고 답하기보다 추측하는 쪽이 유리해진다고 설명합니다4.
틀려도 추가 감점이 없는 객관식 시험을 떠올리면 쉽습니다. 빈칸은 언제나 0점이지만, 찍으면 가끔 점수를 얻습니다. 이런 평가에서는 불확실하다고 말하는 모델보다 무엇이든 답하는 모델이 높은 점수를 받을 수 있습니다.
연구진은 평가 기준을 바꿔 불확실성을 알맞게 표현한 답에도 점수를 줄 필요가 있다고 제안합니다5.
다만 이것은 환각을 설명하는 여러 연구 가운데 하나입니다. 모든 환각이 이 두가지 이유만으로 생기는 것은 아닙니다.
회사가 직접 측정한 환각률
감이 아니라 숫자로 보겠습니다. 오픈AI의 GPT-5 시스템 카드에는 SimpleQA라는 사실 질문 시험의 결과가 실려 있습니다. 웹 검색을 끈 상태에서 측정한 환각률은 다음과 같습니다.
gpt-5-thinking 40%
OpenAI o3 46%
gpt-5-main 47%
GPT-4o 52%6.
다만 이 숫자를 일상 대화 전체의 오답률로 읽어서는 안 됩니다. SimpleQA는 짧은 사실 질문을 묻는 특정 시험입니다. 질문의 종류와 모델 설정, 검색 사용 여부, 평가 기준이 달라지면 결과도 달라집니다.
그래도 한 가지는 분명합니다. 최신 모델도 검색이나 외부 검증 없이 내부 지식만으로 답하면 사실 질문에서 상당한 오류를 낼 수 있습니다.
검색을 붙이면 줄어들지만, 사라지지는 않습니다
환각을 줄이는 대표적인 방법은 답하기 전에 관련 자료를 찾는 것입니다. 3편에서 본 RAG가 이런 방식입니다.
2020년 RAG 논문은 외부 자료를 검색해 사용하는 모델이 검색하지 않는 비교 모델보다 더 구체적이고 다양하며 사실에 가까운 글을 만들었다고 보고했습니다7.
하지만 검색을 붙인다고 환각이 사라지지는 않습니다. 검색 결과가 틀릴 수도 있고, 관련 없는 자료를 가져올 수도 있습니다. 올바른 자료를 찾고도 모델이 내용을 잘못 읽거나, 자료에 없는 내용을 덧붙일 수도 있습니다.
스탠퍼드 연구진은 2024년 렉시스넥시스와 톰슨로이터의 유료 법률 리서치 도구를 직접 시험해 봤습니다. 그 결과 도구에 따라 답변의 17%~33% 사이의 비율로 환각을 일으켰다고 보고했습니다8. 법률 자료를 검색하는 유료 전문 도구에서도 오류가 사라지지 않은 것입니다.
검색은 환각을 줄이는 장치이지, 정답을 보장하는 장치는 아닙니다.
앞서 소개한 오픈AI 논문 원문은 openai.com에서 「Why language models hallucinate」를 검색하면 볼 수 있습니다. 모델 내부의 정보 처리 과정을 살펴본 앤트로픽 연구는 anthropic.com의 「Tracing the thoughts of a large language model」에 공개돼 있습니다.
다음 편에서는 대화가 길어질수록 왜 느려지고 비용이 늘어나는지 살펴봅니다.
읽고 나서 해 볼 것
AI 답변에 사람 이름·숫자·날짜·인용문·출처가 들어 있다면 하나만이라도 원문에서 확인해 보세요. 「확실하지 않으면 모른다고 말해」라고 미리 요청하는 것도 도움이 되지만 오류를 막아 주지는 않습니다. 태연한 말투는 사실이라는 증거가 아닙니다.
출처
각주 8개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 오픈AI 공식 글은 환각을 언어 모델이 만들어 내는 그럴듯하지만 거짓인 진술이라고 정의한다Hallucinations are plausible but false statements generated by language models.https://openai.com/index/why-language-models-hallucinate/확인 2026-09-02↩
- 앤트로픽 공식 문서는 최고 수준의 모델도 사실과 다르거나 주어진 맥락과 어긋나는 글을 만들 수 있으며 이를 환각이라 부른다고 적는다Even the most advanced language models, like Claude, can sometimes generate text that is factually incorrect or inconsistent with the given context.https://platform.claude.com/docs/en/test-and-evaluate/strengthen-guardrails/reduce-hallucinations확인 2026-09-02↩
- 2025년 오픈AI 논문은 틀린 진술을 사실과 구별할 수 없다면 사전학습된 언어 모델에서 환각이 자연스러운 통계적 압력을 통해 발생한다고 적는다If incorrect statements cannot be distinguished from facts, then hallucinations in pretrained language models will arise through natural statistical pressures.https://arxiv.org/abs/2509.04664확인 2026-09-02↩
- 오픈AI 공식 글은 정확히 맞힌 문제의 비율만으로 채점하면 모델이 모른다고 말하기보다 찍도록 부추겨진다고 적는다when models are graded only on accuracy, the percentage of questions they get exactly right, they are encouraged to guess rather than say 'I don't know.'https://openai.com/index/why-language-models-hallucinate/확인 2026-09-02↩
- 같은 논문은 주류 평가 방식을 조금만 바꾸어도 유인을 다시 맞출 수 있으며 불확실성의 적절한 표현을 벌하는 대신 보상할 수 있다고 적는다Simple modifications of mainstream evaluations can realign incentives, rewarding appropriate expressions of uncertainty rather than penalizing them.https://arxiv.org/html/2509.04664v1확인 2026-09-02↩
- 오픈AI 는 GPT-5 시스템 카드 표 8 에 웹 검색을 끈 SimpleQA 환각률을 gpt-5-thinking 0.40, OpenAI o3 0.46, gpt-5-main 0.47, GPT-4o 0.52 로 적었다Table 8: SimpleQA evaluations | columns: gpt-5-thinking, o3, gpt-5-thinking-mini, gpt-5-thinking-nano, gpt-5-main, 4o | SimpleQA (no web) hallucination rate (lower is better) 0.40 0.46 0.26 0.75 0.31 0.47 0.52 | We find that gpt-5-thinking shows slight improvement in hallucination rate over OpenAI o3https://cdn.openai.com/gpt-5-system-card.pdf확인 2026-09-08↩
- 2020년 RAG 원논문은 언어 생성 과제에서 검색을 붙인 모델이 검색 없는 기존 모델보다 더 구체적이고 다양하며 사실에 부합하는 글을 만든다는 것을 확인했다고 적었다For language generation tasks, we find that RAG models generate more specific, diverse and factual language than a state-of-the-art parametric-only seq2seq baseline.https://arxiv.org/abs/2005.11401확인 2026-09-02↩
- 스탠퍼드 연구진은 렉시스넥시스와 톰슨로이터의 상용 법률 리서치 도구들이 17% 가 넘는 비율로 환각을 일으켰다고 보고했다the AI research tools made by LexisNexis (Lexis+ AI) and Thomson Reuters (Westlaw AI-Assisted Research and Ask Practical Law AI) each hallucinate between 17% and 33% of the timehttps://arxiv.org/abs/2405.20362확인 2026-09-02the Lexis+ AI and Ask Practical Law AI systems produced incorrect information more than 17% of the timehttps://hai.stanford.edu/news/ai-trial-legal-models-hallucinate-1-out-6-or-more-benchmarking-queries확인 2026-09-02↩