 P3T
AI 코딩 실력, 같은 클로드가 29.8%p 갈렸습니다
AI 를 모델 이름으로만 비교하면 놓치는 것이 있습니다. 그 모델을 감싼 도구, 하네스입니다
- 무슨 일
- 같은 클로드 모델이 점수판에 스캐폴드 아홉 개로 올라 있고 점수 폭은 29.8퍼센트포인트였습니다.
- 확인된 것
- 한 논문의 실험에서 하네스를 바꾸면 8.5~13.0, 모델을 바꾸면 2.5~5.0퍼센트포인트 움직였습니다.
- 왜 중요한가
- 점수판 기록 20개를 회귀분석한 추정치에서는 모델 효과 범위(47.9)가 하네스(37.6)보다 컸습니다.
- 오늘 할 일
- 점수판을 볼 때 모델 이름 옆의 하네스·도구 이름도 함께 봅니다.
같은 모델도 하네스에 따라 점수가 크게 달라지지만, 회귀분석으로 추정한 모델 효과 범위도 그만큼 커서 어느 쪽이 더 큰지는 재는 방법에 달렸습니다.
AI 모델 클로드 3.5 소네트가 한 코딩 시험의 점수판에 아홉 번 올라 있습니다. 같은 모델인데 가장 높은 점수와 가장 낮은 점수가 29.8퍼센트포인트 벌어져 있습니다. 기록상 아홉 번 모두 모델은 같고, 모델을 감싼 도구(스캐폴드)는 달랐습니다1. 새 AI 가 나오면 우리는 모델 이름으로 실력을 견줍니다. 그런데 AI 의 점수는 모델 혼자 내는 것이 아닙니다. 모델에 무엇을 보여 주고 어떤 도구를 쥐여 줄지 정하는 바깥 장치가 있습니다. 업계는 이것을 하네스라고 부릅니다. 그렇다면 AI 답의 품질은 모델보다 하네스에서 더 갈릴까요? 올해 나온 논문과 공개 점수판을 바탕으로, 두 쪽이 점수를 얼마나 움직이는지 봅니다.
- 같은 모델이라도 감싸는 하네스가 다르면 점수가 크게 달라집니다. 한 논문이 코딩 시험 점수판을 다시 분석했습니다. 모델 하나 안의 점수 폭(29.8퍼센트포인트)이 상위 30개 제출물 전체의 폭(8.8퍼센트포인트)보다 컸습니다.
- 그렇다고 하네스가 늘 모델보다 중요한 것은 아닙니다. 같은 논문은 모델과 스캐폴드 조합이 겹치는 점수판 기록 20개를 하나의 통계식(회귀분석)으로 풀었고, 추정된 모델 효과 범위가 스캐폴드 효과 범위보다 컸습니다. 점수판에 쌓인 기록으로 낸 추정치입니다. 어느 쪽이 크게 보이는지는 무엇을 고정하고 재느냐에 달려 있습니다.
- 그래서 AI 를 비교할 때는 모델 이름과 함께 그 모델을 어떤 도구로 돌렸는지 봐야 합니다. 둘은 서로 얽혀 있어서, 어떤 하네스가 좋은지도 모델에 따라 달라질 수 있습니다.
하네스는 모델을 감싼 나머지 전부입니다
「AI는 어떻게 작동하나」에서 봤듯이 AI 모델은 「이 도구를 이런 값으로 실행해 달라」는 요청까지만 만듭니다. 실제 실행은 모델 밖의 프로그램이 맡습니다. 이 바깥 부분을 통틀어 하네스(harness)라고 부릅니다. 모델을 둘러싸고 일을 시키는 소프트웨어 전체를 가리킵니다.
에이전트 개발 도구를 만드는 회사 랭체인은 이것을 한 줄로 정리했습니다. 에이전트는 모델과 하네스를 더한 것입니다. 하네스는 모델 자체가 아닌 모든 코드와 설정, 실행 논리입니다. 시스템 프롬프트와 도구, 파일을 다루는 작업 공간과 브라우저가 여기에 들어갑니다. 여러 하위 에이전트에 일을 나눠 맡기는 조율 논리도 들어갑니다. 랭체인은 「모델이 지능을 담고, 하네스가 그 지능을 쓸모 있게 만든다」고 적었습니다2.
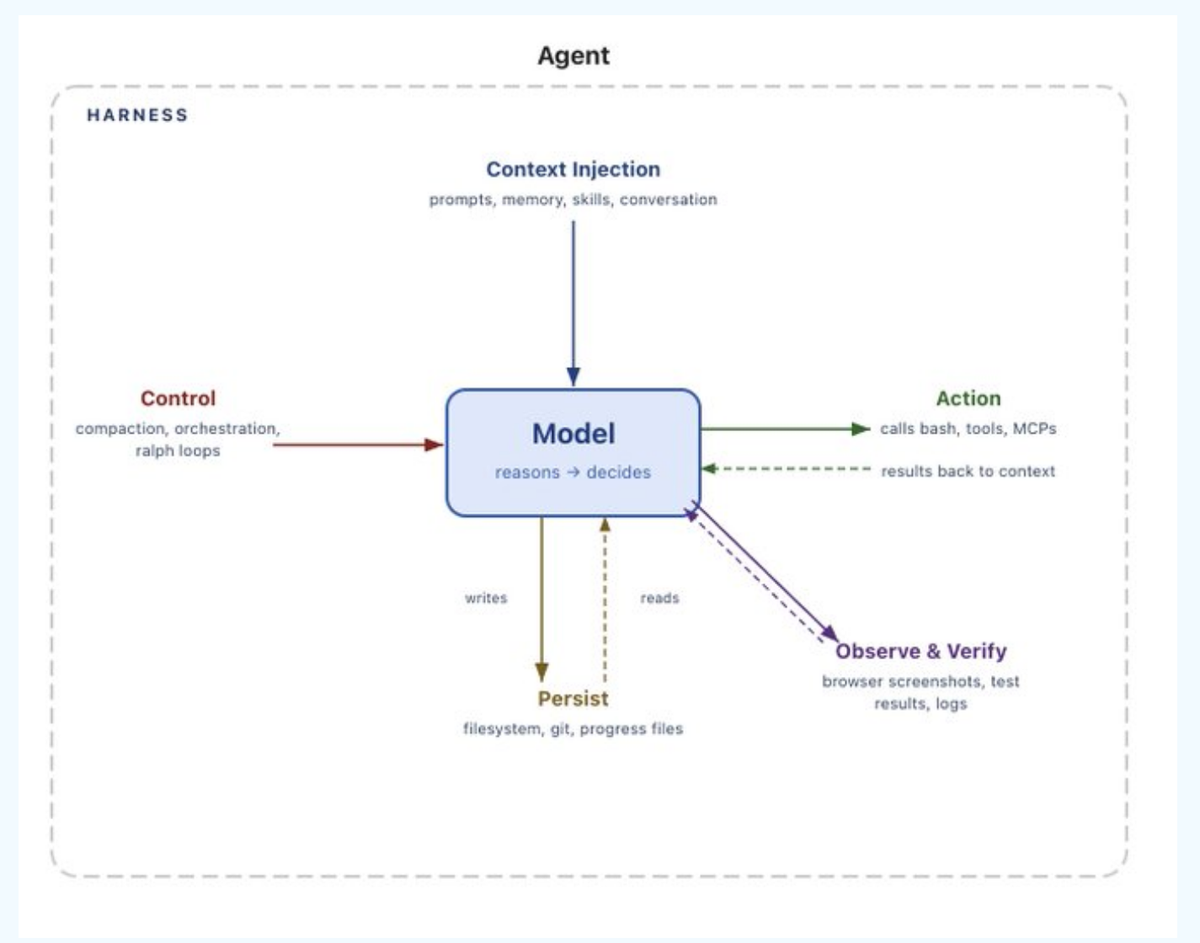
같은 것을 스캐폴딩(scaffolding)이라고도 부릅니다3. 아래 논문들이 쓰는 「스캐폴드」도 하네스와 같은 것입니다. 비유하자면 모델이 머리이고, 하네스는 그 머리가 일하는 책상과 연장, 작업 순서입니다.
같은 모델이 점수판에 아홉 번 올라 있습니다
AI 의 코딩 실력을 재는 SWE-bench 라는 시험이 있습니다. 올해 9월 한 논문이 이 시험의 공개 점수판을 다시 모아 분석했습니다. 논문은 먼저 점수판의 한 줄이 모델 하나가 아니라고 짚었습니다. 모델과 그 모델을 돌린 스캐폴드의 짝이라는 것입니다1.
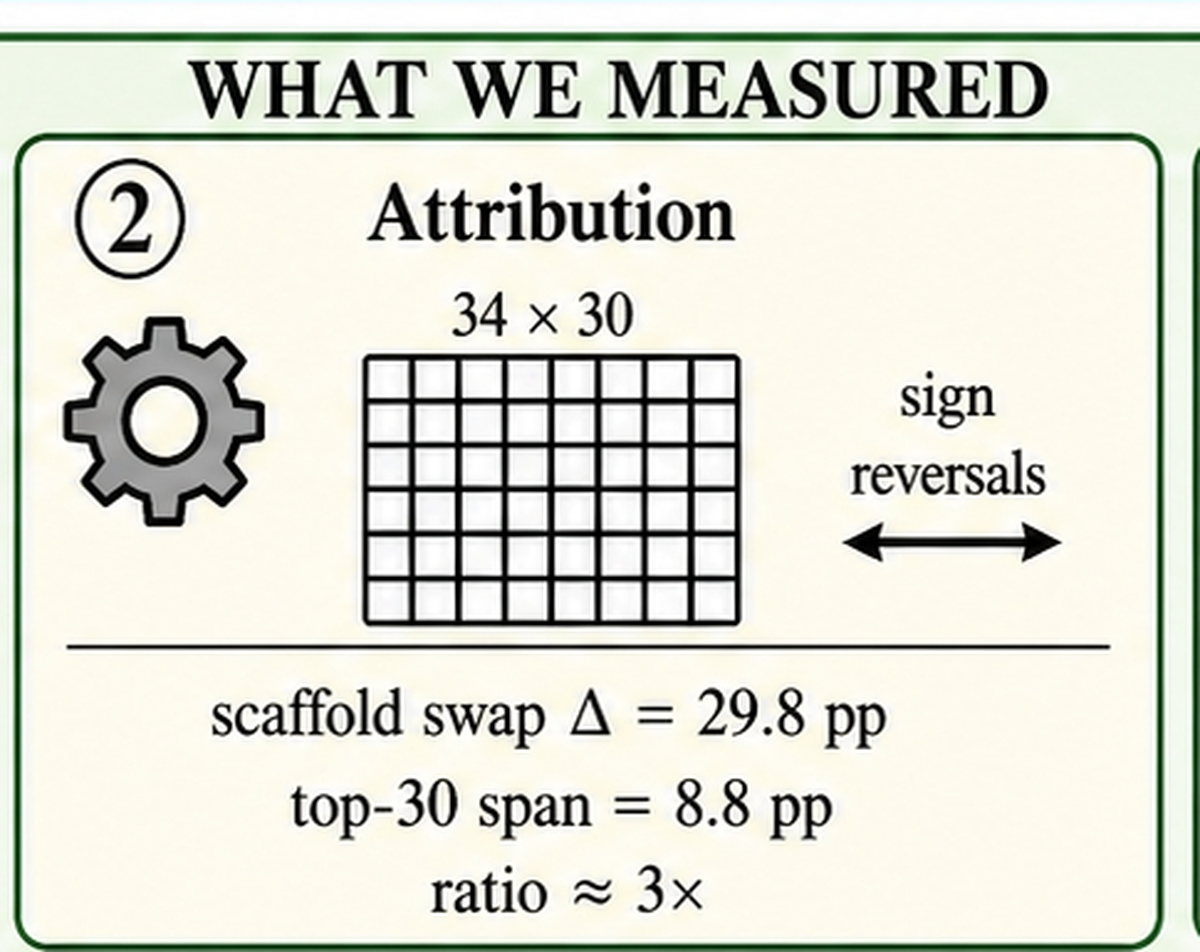
그 논문에 따르면 클로드 3.5 소네트는 스캐폴드 아홉 개와 짝을 지어 올라 있습니다. 아홉 개 점수 가운데 가장 높은 것과 가장 낮은 것의 차이가 29.8퍼센트포인트였습니다. 퍼센트포인트는 두 정답률(%) 사이의 차이를 뜻합니다. 같은 점수판에서 상위 30개 제출물 전체의 점수 폭은 8.8퍼센트포인트였습니다1. 모델 하나 안에서 벌어진 차이가 1등부터 30등까지의 차이보다 세 배 넘게 컸던 셈입니다. 다만 여러 팀이 낸 점수판 기록이라, 이 차이를 스캐폴드 하나로만 설명할 수는 없습니다.
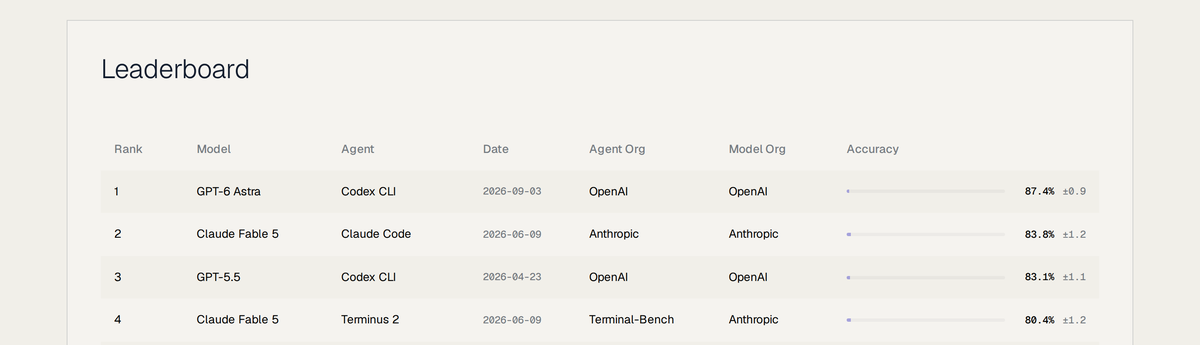
지금 점수판에서도 같은 모습이 보입니다. Snorkel AI 가 운영하는 터미널벤치 2.1 점수판을 9월 28일에 열어 봤습니다. 제미나이 3 프로는 같은 날 두 번 올라 있었습니다. Terminus 2 와 짝일 때 73.9%, Gemini CLI 와 짝일 때 65.8%입니다. 클로드 페이블 5 도 Claude Code 와 짝이면 83.8%, Terminus 2 와 짝이면 80.4%로 갈립니다4. 여기서는 차이가 3.4~8.1퍼센트포인트로 앞의 29.8퍼센트포인트보다 작습니다. 하네스가 점수를 얼마나 움직이는지는 시험과 모델에 따라 다릅니다.
조건을 맞춘 실험에서는 하네스가 더 크게 움직였습니다
점수판은 여러 팀이 제각각 낸 기록입니다. 그래서 점수 차이가 하네스 때문인지, 팀마다 다른 조건 때문인지 가르기 어렵습니다. 조건을 맞춰 직접 실험한 논문이 있는 이유입니다.
올해 5월 공개된 한 논문이 그런 실험을 했습니다. GLM-5.1, GPT-5.4, Kimi K2.6 세 모델에 하네스를 바꿔 끼우며 같은 코딩 과제를 풀게 한 것입니다. 하네스를 바꾸자 GLM-5.1 의 점수는 13.0퍼센트포인트 움직였습니다. GPT-5.4 와 Kimi K2.6 은 각각 8.5퍼센트포인트였습니다. 하네스를 고정하고 모델만 바꿨을 때의 점수 차이는 3.0, 2.5, 5.0퍼센트포인트였습니다. 점수가 흩어지는 정도로 따지면 하네스 쪽이 평균 7.8배 컸습니다. 다만 저자들은 이 7.8배가 어디서나 통하는 배율이라고 주장하지 않는다고 적었습니다5.
모델을 그대로 두고 하네스만 고쳐도 점수가 오를 수 있습니다. 한 연구팀은 GPT-5.4 는 그대로 두고 하네스만 열 차례 자동으로 고쳤습니다. 터미널벤치 2 통과율은 69.7%에서 77.0%가 됐습니다6.
5월 논문은 다른 곳의 측정도 모아 소개했습니다. 에이전트 점수판 HAL(Holistic Agent Leaderboard)의 측정에서 클로드 소네트 4.5 는 SWE-Agent 스캐폴드로 68%를 받았습니다. HAL Generalist 로는 34%에 그칩니다7. 같은 모델의 점수가 절반이 된 것입니다.
작은 모델에서는 차이가 더 벌어지기도 합니다. 올해 9월 나온 다른 논문은 웹사이트를 다루는 과제를 풀게 했습니다. 연구진이 설계한 하네스에서는 모델 크기와 관계없이 성공률이 44.7~45.3%로 유지됐습니다. 도구 호출(Tool-Calling) 방식의 에이전트는 40억 개 매개변수의 작은 모델에서 6.7%로 떨어졌습니다8.
그렇다고 모델이 덜 중요한 것은 아닙니다
그렇다면 모델은 덜 중요할까요? 앞에서 29.8퍼센트포인트를 계산한 논문은 반대쪽 숫자도 함께 내놓았습니다. 모델 일곱 개와 스캐폴드 열 개가 겹치는 기록 20개를 하나의 통계식(회귀분석)으로 풀어 본 것입니다. 회귀분석으로 추정한 스캐폴드 효과 범위는 37.6퍼센트포인트, 모델 효과 범위는 47.9퍼센트포인트로 모델 쪽이 컸습니다. 조건을 맞춘 실험값이 아니라 점수판에 쌓인 기록에서 낸 추정치입니다. 저자들은 이 결과를 스캐폴드가 모델보다 중요하다는 뜻으로 읽지 않았습니다. 둘의 크기가 같은 수준이라는 뜻으로 읽었습니다9.
두 논문의 결론이 달라 보이는 것은 재는 방법이 달라서라고 저는 봅니다. 한쪽은 모델 셋을 골라 조건을 맞춘 채 하네스와 모델을 하나씩 바꿔 봤습니다. 다른 쪽은 여러 팀이 낸 점수판 기록에서 모델과 스캐폴드의 몫을 나눴습니다. 무엇을 고정하고 무엇을 바꾸느냐에 따라 더 커 보이는 쪽이 달라집니다.
모델과 하네스는 서로 얽혀 있기도 합니다. 같은 분석에서는 두 스캐폴드의 우열이 모델에 따라 뒤집혔습니다. 클로드 3.5 소네트에서 나은 쪽이 GPT-4o 에서는 뒤처진 것입니다10. 좋은 하네스가 모델마다 다를 수 있다는 뜻입니다.
하네스가 맡던 일이 모델 쪽으로 옮겨 가기도 합니다. 올해 9월 공개된 한 논문을 보면, 기본 모델의 과제 성공률은 23.3%입니다. 전용 하네스를 붙이면 41.7%가 됩니다. 연구진의 방법 Harness-Zero 는 배포 때 그 하네스를 뗀 채로 기본 모델의 성공률을 44.3%까지 끌어올렸습니다. 하네스를 붙였을 때보다 높은 점수입니다11. 하네스가 해 주던 일을 모델이 스스로 하게 될 수 있다는 뜻으로 읽힙니다.
그래서 「모델이냐 하네스냐」보다 「이 점수는 어떤 모델을 어떤 하네스로 돌려 얻었느냐」를 묻는 편이 정확합니다. 새 AI 의 점수 소식을 보면 모델 이름뿐 아니라 그 옆에 적힌 도구 이름도 함께 보세요. Claude Code 나 Codex CLI 같은 도구 이름이 적혀 있다면, 그것이 하네스입니다.
읽고 나서 해 볼 것
다음에 「어느 AI 가 1등」이라는 소식을 보면, 그 점수를 어떤 도구로 잰 것인지부터 확인해 보세요. 같은 모델을 쓰는 앱 두 개에 같은 일을 시켜 결과를 견줘 보는 것도 방법입니다. 모델을 바꾸기 전에 도구를 바꿔 보는 쪽이 더 싸게 먹힐 때가 있습니다.
출처
각주 11개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- arXiv 2609.17394 는 SWE-bench 점수판(리더보드)의 한 항목이 모델과 스캐폴드(에이전트 루프·도구·검색·제어 방식)의 짝으로 만들어진다고 보고, 스캐폴드 아홉 개와 함께 올라 있는 claude-3-5-sonnet 의 점수 범위가 29.8퍼센트포인트, 상위 30개 제출물 전체의 점수 폭이 8.8퍼센트포인트라고 적었다A leaderboard entry is produced by a pair: a model, and the scaffold — the agent loop, tool set, retrieval and control policy — that drives it.https://arxiv.org/abs/2609.17394v1확인 2026-09-28For claude-3-5-sonnet, which appears with nine scaffolds, the range is 168 to 317 — 149 instances, or 29.8pp.https://arxiv.org/abs/2609.17394v1확인 2026-09-28For scale, the entire spread of the top thirty submissions is 8.8pp.https://arxiv.org/abs/2609.17394v1확인 2026-09-28↩
- 랭체인(LangChain)은 에이전트를 모델과 하네스의 합으로 보고, 하네스를 모델 자체가 아닌 모든 코드·설정·실행 로직으로 정의하며, 그 예로 시스템 프롬프트·도구·스킬·MCP·파일시스템·샌드박스·브라우저·하위 에이전트 생성 같은 조율 로직·훅을 든다. 모델은 지능을 담고 하네스는 그 지능을 쓸모 있게 만든다고 적었다Agent = Model + Harnesshttps://www.langchain.com/blog/the-anatomy-of-an-agent-harness확인 2026-09-28A harness is every piece of code, configuration, and execution logic that isn't the model itself.https://www.langchain.com/blog/the-anatomy-of-an-agent-harness확인 2026-09-28System Prompts, Tools, Skills, MCPs + and their descriptions, Bundled Infrastructure (filesystem, sandbox, browser), Orchestration Logic (subagent spawning, handoffs, model routing), Hooks/Middleware for deterministic executionhttps://www.langchain.com/blog/the-anatomy-of-an-agent-harness확인 2026-09-28The model contains the intelligence and the harness makes that intelligence useful.https://www.langchain.com/blog/the-anatomy-of-an-agent-harness확인 2026-09-28↩
- 위키백과(Wikipedia)는 에이전트 하네스를 에이전트 스캐폴딩이라고도 부르며, 대규모 언어 모델이 AI 에이전트로 작동하게 하는 주변 소프트웨어 인프라라고 설명한다An agent harness, also known as agent scaffolding, is the software infrastructure surrounding a large language model (LLM) that enables it to operate as an AI agent.https://en.wikipedia.org/wiki/Agent_harness확인 2026-09-28↩
- Snorkel AI 의 터미널벤치 2.1 리더보드(2026-09-28 확인)에는 같은 모델이 같은 날짜에 다른 하네스로 올라 있다 — 제미나이 3 프로(Gemini 3 Pro)는 Terminus 2 73.9%·Gemini CLI 65.8%, GPT-5.5 는 Codex CLI 83.1%·Terminus 2 78%, 클로드 페이블 5(Claude Fable 5)는 Claude Code 83.8%·Terminus 2 80.4%Gemini 3 Pro — Terminus 2 73.9% vs Gemini CLI 65.8% (동일 날짜 2025-11-18)https://snorkel.ai/leaderboard/terminal-bench-2-1/확인 2026-09-28GPT-5.5 — Codex CLI 83.1% vs Terminus 2 78% (동일 날짜 2026-04-23)https://snorkel.ai/leaderboard/terminal-bench-2-1/확인 2026-09-28Claude Fable 5 — Claude Code 83.8% vs Terminus 2 80.4% (동일 날짜 2026-06-09)https://snorkel.ai/leaderboard/terminal-bench-2-1/확인 2026-09-28↩
- arXiv 2605.23950 저자들의 직접 실험에서 하네스를 바꾸면 GLM-5.1 의 점수가 13.0퍼센트포인트, GPT-5.4 와 Kimi K2.6 이 각각 8.5퍼센트포인트 움직였고, 하네스를 고정한 채 모델을 바꾸면 3.0·2.5·5.0퍼센트포인트 움직였다. 하네스가 만든 분산은 모델이 만든 분산의 평균 7.80배였고, 저자들은 이 배율이 보편적이라고 주장하지 않는다Average HV is 18.48 pp2 versus average MV of 2.37 pp2, a ratio of 7.80×. Changing the harness moves GLM-5.1 by 13.0 percentage points and GPT-5.4 and Kimi K2.6 by 8.5 points each. Changing the model within a fixed harness moves scores by only 3.0, 2.5, and 5.0 pointshttps://arxiv.org/abs/2605.23950v1확인 2026-09-28We do not claim that the 7.80× ratio is universal.https://arxiv.org/abs/2605.23950v1확인 2026-09-28↩
- GPT-5.4 를 고정한 채 AHE(Agentic Harness Engineering)로 하네스를 열 차례 자동 개선하자 터미널벤치 2 통과율(pass@1)이 69.7%에서 77.0%로 올랐다Across ten evaluate → analyze → improve iterations, AHE (Agentic Harness Engineering) lifts Terminal-Bench 2 pass@1 from 69.7% to 77.0% on GPT-5.4https://github.com/china-qijizhifeng/agentic-harness-engineering확인 2026-09-28Empirically, ten AHE iterations lift pass@1 on Terminal-Bench 2 from 69.7% to 77.0%, surpassing the human-designed harness Codex-CLI (71.9%) and the self-evolving baselines ACE and TF-GRPO.https://arxiv.org/abs/2604.25850확인 2026-09-28holding the model fixed while changing only the harness raises Terminal-Bench 2 pass@1 from 69.7% to 77.0% [17], and independent third-party benchmark monitoring reports up to 15 percentage points of scaffold-only variation on SWE-bench Verifiedhttps://arxiv.org/abs/2605.23950v1확인 2026-09-28↩
- arXiv 2605.23950 은 HAL 의 보고를 인용해 SWE-Agent 와 HAL Generalist 사이에서 Claude Sonnet 4.5 의 점수가 68%와 34%로 34포인트 차이가 났다고 적었다HAL reports double-digit cross-scaffold gaps under SWE-Agent versus HAL Generalist, of 34 points for Claude Sonnet 4.5 (68% to 34%), 34 points for GPT-5 Medium (46% to 12%), and nearly 48 points for o4-minihttps://arxiv.org/abs/2605.23950v1확인 2026-09-28↩
- arXiv 2609.26760 에서 WebArena-Verified 과제 성공률은 Growing Harness 가 모델 규모와 관계없이 44.7~45.3%였고, 도구 호출(Tool-Calling) 에이전트는 4B 모델에서 6.7%로 떨어졌다On WebArena-Verified, its success remains 44.7–45.3% across model scales, whereas Tool-Calling falls to 6.7% with the 4B model.https://arxiv.org/abs/2609.26760v1확인 2026-09-28↩
- arXiv 2609.17394 는 모델 7개·스캐폴드 10개가 연결된 20칸에 가법 모형을 맞춘 결과 스캐폴드 효과 범위 37.6퍼센트포인트, 모델 효과 범위 47.9퍼센트포인트(비율 0.78)를 얻었고, 이를 스캐폴드가 모델보다 중요하다는 뜻이 아니라 둘이 같은 규모라는 뜻으로 읽었다A least-squares additive fit y = µ + αscaffold + βmodel on the connected core (20 cells, 10 scaffolds, 7 models) gives R2 = 0.989 with a fitted scaffold-effect range of 37.6pp against 47.9pp for models, a ratio of 0.78. The reading is not that scaffolds matter more than models, but that the fitted ranges are of the same order.https://arxiv.org/abs/2609.17394v1확인 2026-09-28↩
- arXiv 2609.17394 에서 agentless 와 epam-ai-run 두 스캐폴드의 우열은 claude-3-5-sonnet 과 gpt-4o 사이에서 뒤집혔다agentless versus epam-ai-run reverses sign between claude-3-5-sonnet and gpt-4o. The interaction is −75.5 instances (−15.1pp).https://arxiv.org/abs/2609.17394v1확인 2026-09-28↩
- arXiv 2609.24974(Harness-Zero)에서 에이전트 하네스는 성능을 크게 높일 수 있지만 그 이득은 배포 때 하네스에 묶여 있다고 보고, 기본 모델의 매크로 평균 과제 성공률 23.3%가 전용 하네스를 붙이면 41.7%였고, 하네스를 떼고 배포한 Harness-Zero 는 44.3%였다고 적었다Agent harnesses, the external systems that mediate model-environment interaction, can substantially improve agent performance, but their gains remain tied to the harness at deployment.https://arxiv.org/abs/2609.24974v1확인 2026-09-28With the specialized harness removed at deployment, Harness-Zero improves the base model's macro-average task success from 23.3% to 44.3%, even exceeding the 41.7% it reaches with that harness still attached.https://arxiv.org/abs/2609.24974v1확인 2026-09-28↩