 P3T
AI 성능 순위 1위, 같은 클로드가 58점도 54점도
1위 점수는 가장 비싼 설정에서 나오기도 하고, 시험지 자체가 결함 판정을 받기도 합니다
- 무슨 일
- 클로드 오퍼스 5.5 는 같은 지수에서 설정에 따라 58점도 54점도 받았습니다.
- 확인된 것
- 에포크 AI 는 벤치마크 15개를 검토해 9개를 결함으로 판정했습니다.
- 왜 중요한가
- 앤트로픽도 이 수준에서는 점수 차이가 덜 믿을 만한 길잡이라고 적었습니다.
- 오늘 할 일
- 점수를 보면 설정과 시험지 판정, 격차 크기를 먼저 확인합니다.
벤치마크 1위 점수는 가장 비싼 설정에서 나오기도 하고 시험지 자체가 결함 판정을 받기도 하니, 설정과 시험지부터 확인해야 합니다.
새 AI 가 나오면 「벤치마크 1위」 소식이 먼저 돕니다. 새로 나온 클로드 오퍼스 5.5 도 그랬습니다. AI 개발 도구 회사 벨럼(Vellum)은 이 모델이 한 성능 지수에서 58점으로 1위라고 정리했습니다1. 그런데 그 지수를 운영하는 회사 페이지에서는 같은 모델이 54점입니다2. 둘 다 틀린 숫자는 아닙니다. 적어도 추론 강도라는 설정이 다릅니다. 이 글은 그 4점에서 출발합니다. AI 성능 점수는 실제 성능을 얼마나 보여 줄까요? 점수를 발표하는 회사와 점수를 매기는 회사, 시험지를 검사하는 기관의 말을 차례로 듣습니다. 끝에는 점수를 볼 때 확인할 세 가지를 적었습니다.
- 벤치마크 1위 점수는 가장 비싼 설정에서 나오기도 합니다. 클로드 오퍼스 5.5 는 같은 지수에서 max 로 58점, high 로 54점을 받았습니다.
- 시험지도 검사를 받습니다. 에포크 AI 는 벤치마크 15개 중 9개를 결함으로 판정했습니다. 코딩 시험 SWE-bench Verified 도 결함 판정을 받았습니다.
- 점수를 앞세운 앤트로픽도 이 수준에서는 점수 차이가 덜 믿을 만한 길잡이라고 적었습니다. 격차가 작으면 내 일로 직접 비교하는 편이 낫습니다.
58점과 54점, 같은 클로드가 받은 두 점수입니다
58점은 아티피셜 애널리시스(Artificial Analysis)의 지능 지수에서 나온 점수입니다. 아티피셜 애널리시스는 여러 AI 모델에 같은 시험을 치르게 하고, 그 결과를 한 숫자로 모으는 회사입니다. 벨럼은 오퍼스 5.5 가 이 지수 1위라고 적으면서 단서를 하나 달았습니다1. max 추론 강도에서 받은 58점이라는 것입니다1.
추론 강도는 AI 가 답하기 전에 얼마나 오래 따져 보게 할지 정하는 손잡이입니다. 아티피셜 애널리시스 페이지에는 추론 강도를 high 로 둔 오퍼스 5.5 가 있습니다. 그 점수는 54점입니다2. 모델도 같고 지수도 같은데, 추론 강도가 다른 두 설정에서 4점이 벌어집니다.
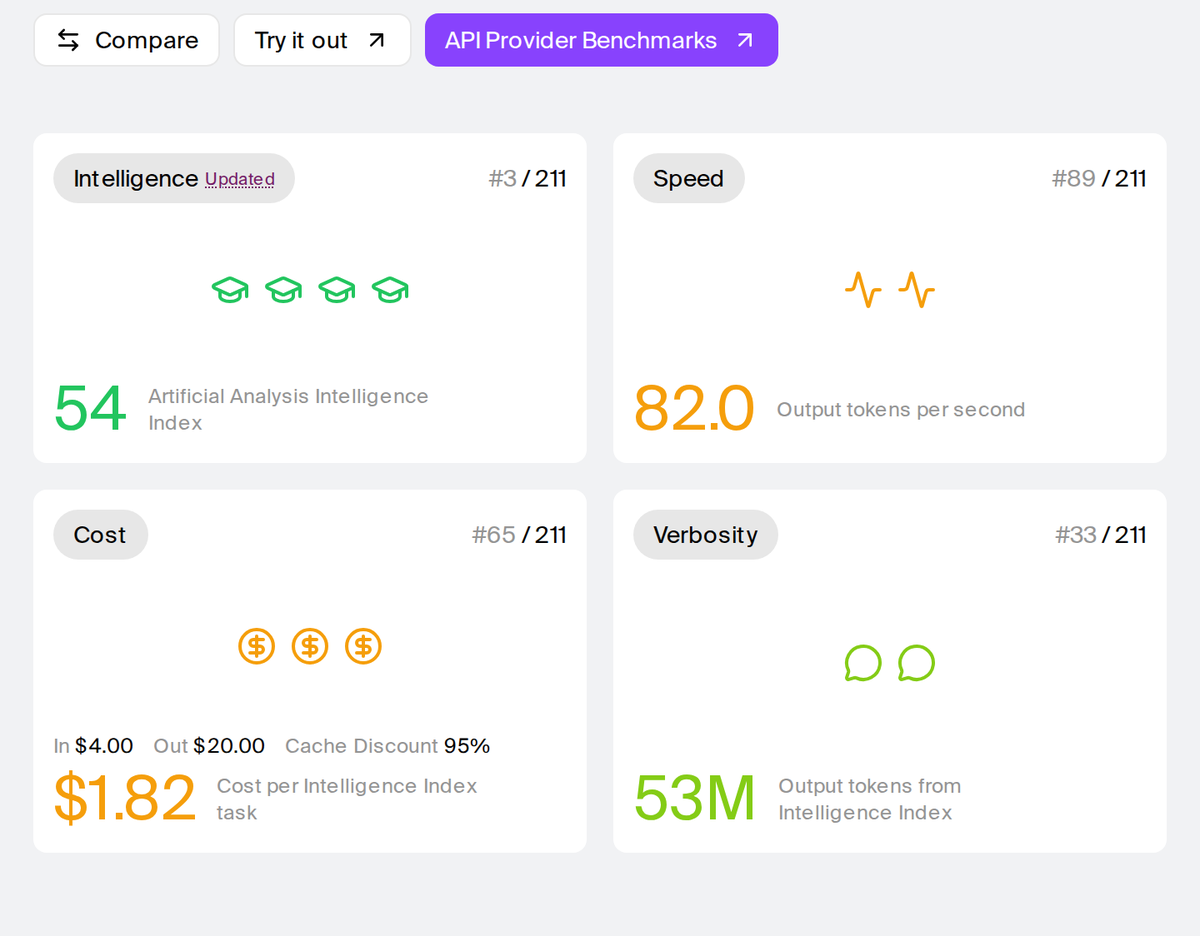
두 숫자는 원래 아티피셜 애널리시스 한 곳의 데이터에서 나왔습니다. 54점은 아티피셜 애널리시스 페이지에서 직접 확인했습니다2. 58점은 그 데이터를 옮긴 벨럼과 긱뉴스의 글에서 확인했습니다1. 긱뉴스는 한국 개발자 커뮤니티입니다. 두 기관이 각자 재서 같은 값이 나온 것은 아니라는 점을 밝혀 둡니다.
긱뉴스 글은 이 지수를 추론 강도 다섯 단계로 옮겨 놓았습니다. 다섯 단계 중 비용이 가장 높은 것이 max 였습니다1. 같은 글에 따르면 high 에서 max 로 올리면 지수는 4점 오르고, 비용은 약 3.3배가 됩니다3. 1위 타이틀이 가장 비싼 설정에서 나온 셈입니다.
설정은 점수가 무엇을 재는지도 바꿉니다. 벨럼은 앤트로픽의 설명을 옮겨 재피어(Zapier) 사례를 전했습니다. 업무 자동화 회사 재피어는 대체 모델(fallback)을 켜지 않은 채 오퍼스 5.5 를 평가했습니다4. 복잡한 업무 과제에서 보안 안전장치가 끼어들면 그 과제는 실패로 셌습니다4. 같은 모델이라도 이런 과제를 어떻게 세느냐에 따라 점수가 달라질 수 있습니다.
시험지도 검사를 받았습니다 — 15개 중 9개가 결함 판정
점수를 믿으려면 시험지부터 멀쩡해야 합니다. 벤치마크는 AI 성능을 재려고 만든 공통 시험 문제 묶음입니다. AI 연구 기관 에포크 AI(Epoch AI)가 이 시험지를 검사했습니다. 국내외 보도에 따르면 에포크 AI 는 벤치마크 15개를 검토해 9개를 결함으로 판정했습니다5.
판정 기준은 에포크 AI 문서에 있습니다. 「검증됨」은 그 벤치마크를 설명된 대로 대체로 해석할 수 있다는 뜻입니다6. 「결함」은 실질적인 결함이 하나 이상 있다는 뜻입니다6.
AI 의 코딩 실력을 재는 SWE-bench Verified 도 결함 판정을 받았습니다7. 에포크 AI 는 여기서 오픈AI 의 자체 감사를 인용합니다7. 오픈AI 는 이 시험의 작업 27.6%를 감사했고, 그중 59.4%에서 제대로 작동하는 답을 틀렸다고 처리하는 테스트를 찾았습니다7. 감사 대상은 자주 풀리지 않던 문제들이었습니다7. 에포크 AI 는 이 결과를 전체 작업으로 환산하면 최소 16.4%가 망가진 것이라고 적었습니다7. 수치의 출처는 오픈AI 감사이고, 저는 그 감사 원문까지는 열어 보지 못했습니다.
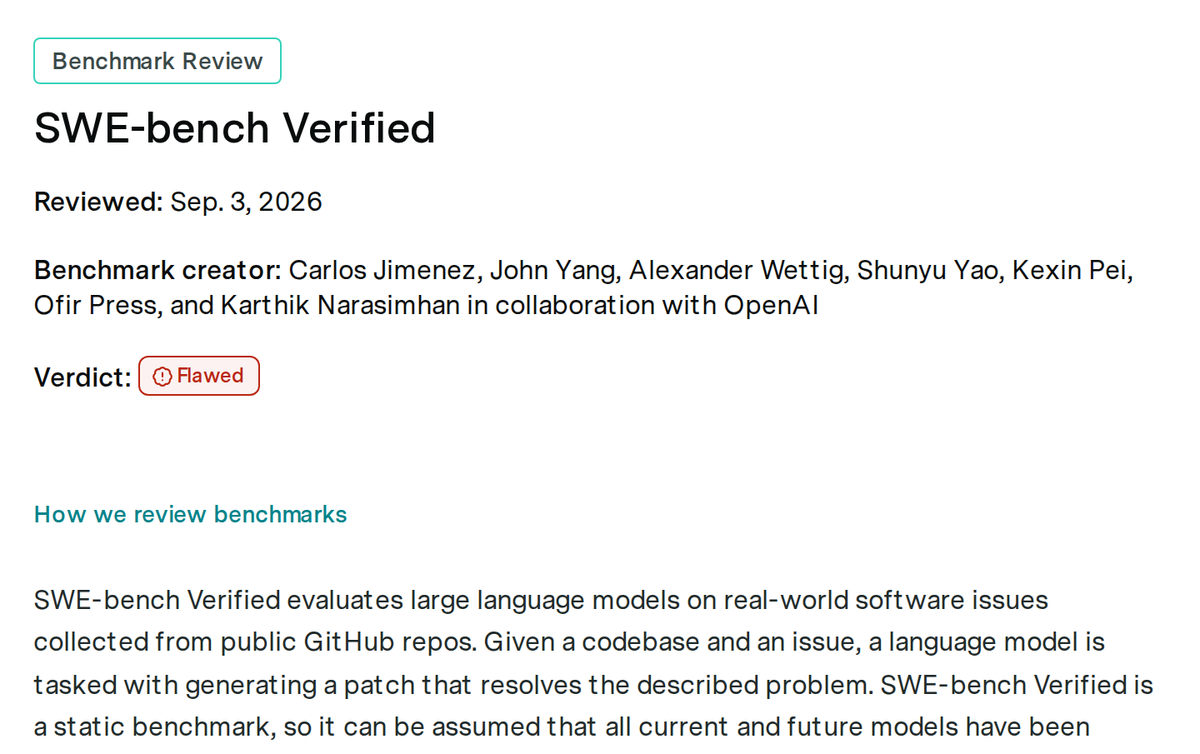
같은 리뷰는 오픈AI 분석의 다른 대목도 옮깁니다. 오픈AI 가 시험한 프런티어 모델(가장 앞선 모델)은 모두 훈련 중에 이 시험의 문제와 해결책을 일부라도 접했다는 것입니다8. 시험 문제와 답을 미리 본 학생의 점수를 떠올리면 됩니다.
시험 문제가 훈련 데이터에 섞여 들어가는 일을 오염이라고 부릅니다. 2023년 10월 arXiv 에 처음 올라온 한 오염 보고서가 이것을 쟀습니다. 15개가 넘는 인기 AI 모델을 객관식 벤치마크 6개로 살폈습니다9. 오염 수준은 벤치마크마다 달라 1%에서 45%까지였습니다9. 다만 같은 보고서는 오염됐다고 점수가 꼭 오르지는 않았다고도 적었습니다9. 시중 모델이 모두 그만큼 오염됐다는 뜻도 아닙니다.
1위를 발표한 회사가 스스로 단 단서
앤트로픽의 오퍼스 5.5 공식 발표문은 벤치마크 점수를 여럿 앞세웁니다. 그런데 같은 발표문에 이런 문장이 있습니다. 이 정도 능력 수준에서는 점수 차이가 실제 차이를 알려 주는 길잡이로서 덜 믿을 만해졌다는 것입니다10. 자기들이 직접 써 보면 오퍼스 5.5 와 클로드 페이블 5.1 의 차이가 점수보다 좁다는 말도 덧붙였습니다10.
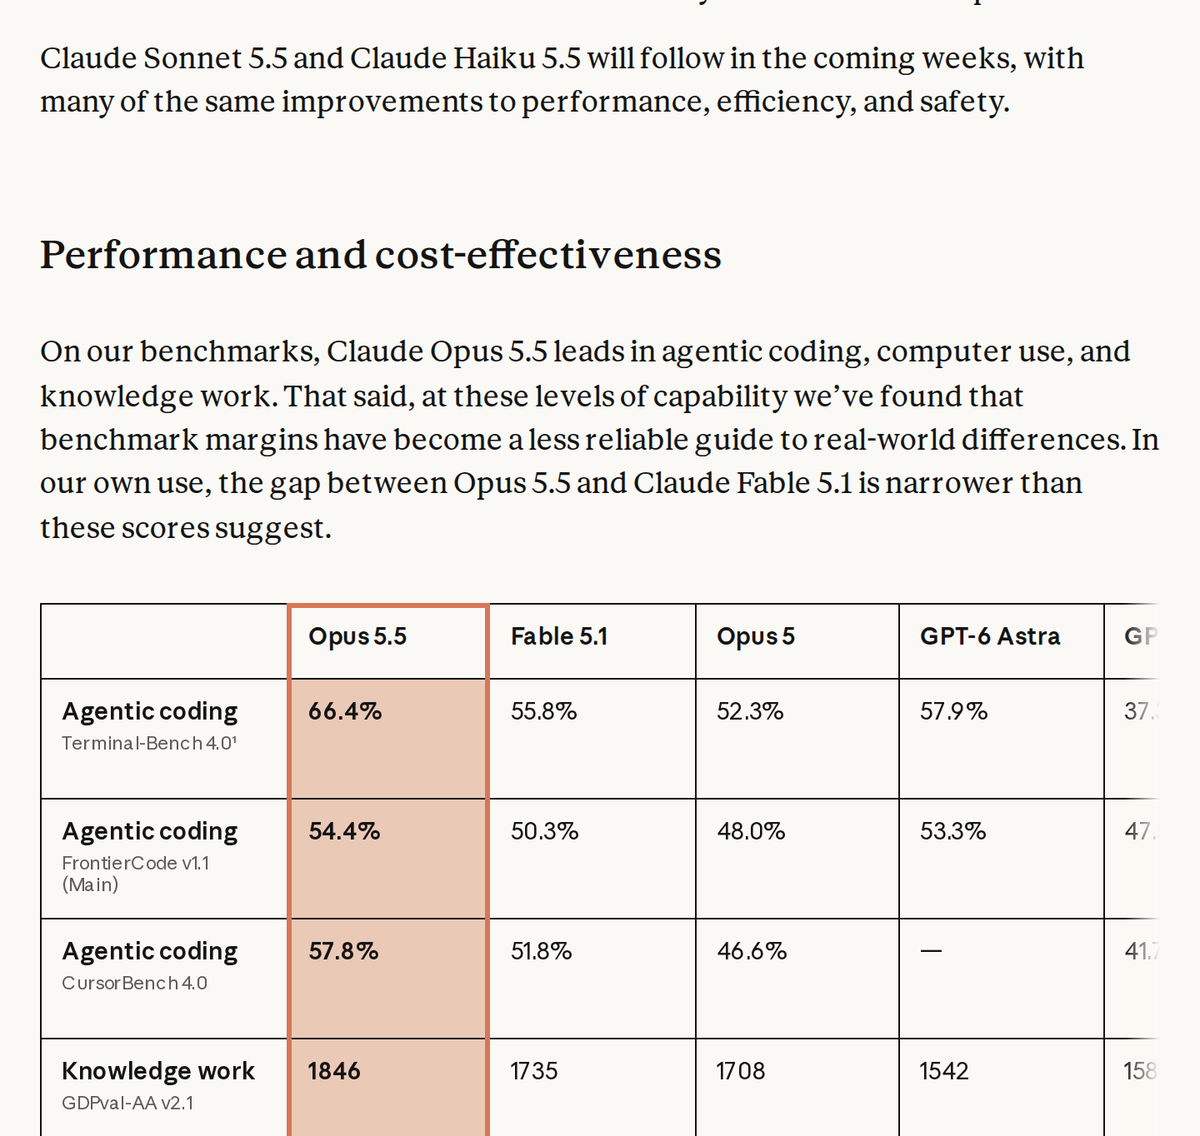
점수로 새 모델을 소개하는 회사가 같은 자리에 단서를 단 셈입니다. 점수 차이를 곧이곧대로 읽지 말라는 단서죠. 발표하는 쪽은 1위를 말하고 검사하는 쪽은 결함을 센다는 구도만으로는 이 단서를 설명할 수 없습니다.
직접 써 본 곳의 평가도 같은 결론으로 모이지 않습니다. 코드 리뷰 도구 회사 코드래빗(CodeRabbit)은 자체 평가를 냈습니다11. 오퍼스 5.5 를 써 볼 가장 큰 이유는 찾아내는 버그의 조합이 다르다는 점이라고 합니다11. 효율은 아직 열린 질문이라며, 낮아진 토큰 가격이 리뷰 비용을 줄이는지 팀마다 확인하라고 권했습니다11. 이것은 벤치마크가 아니라 이 회사의 실무 평가입니다.
AI타임스도 오퍼스 5.5 와 오픈AI 의 GPT-5.6 솔에게 각각 3D 장면을 만들게 해 비교했습니다12. 기사 제목은 오퍼스 5.5 에 「디테일」, GPT-5.6 에 「비용·속도」를 붙였습니다12. 본문은 결과물의 품질과 비용이 엇갈렸다고 적었습니다12. 1위 점수와 내 일에 맞는 선택은 다른 질문입니다.
그래서 점수를 볼 때 확인할 세 가지
첫째, 점수 옆에 적힌 설정을 봅니다. 같은 클로드 오퍼스 5.5 가 max 에서 58점, high 에서 54점이었습니다12. 1위 소식이 어느 설정의 값인지, 내가 쓰는 설정은 무엇인지 맞춰 봐야 합니다.
둘째, 그 시험지가 검사를 통과했는지 봅니다. 에포크 AI 는 벤치마크마다 「검증됨」이나 「결함」 같은 판정을 붙입니다6. 결함 판정을 받은 시험이라면 몇 점 차이에 큰 의미를 두지 않는 편이 낫습니다.
셋째, 격차가 작으면 내 일로 직접 비교합니다. 만든 회사도 이 수준에서는 점수 차이가 덜 믿을 만한 길잡이라고 했습니다10. 자주 하는 작업 두세 개를 두 모델에 똑같이 맡겨 보세요. 결과와 비용을 같이 보면 됩니다.
하나 더 있습니다. 숫자가 어디서 왔는지 따라가 보는 일입니다. 저는 이 글을 준비하며 커뮤니티 게시물 제목 하나를 확인하려 했습니다. 클로드 오퍼스 5.5 가 심플벤치라는 벤치마크에서 88.4%로 1위에 올랐다는 제목입니다. 심플벤치 공식 사이트는 점수표를 자바스크립트로 그립니다. 그래서 제가 쓴 텍스트 추출 도구로는 모델별 점수가 보이지 않았습니다. 그 숫자는 여러 점수를 모아 보여 주는 집계 사이트 한 곳에서만 확인됐습니다. 그래서 이 글은 88.4%를 사실로 적지 않습니다.
벤치마크 점수 하나에는 모델 실력만 들어 있지 않습니다. 설정과 시험지, 세는 방식이 함께 들어 있습니다. 다음에 1위 소식을 보면 그 세 가지를 먼저 풀어 보세요.
읽고 나서 해 볼 것
다음에 「벤치마크 1위」 소식을 보면 세 가지를 확인해 보세요. 어떤 설정에서 나온 점수인지, 그 시험이 에포크 AI 의 검사에서 어떤 판정을 받았는지, 격차가 몇 점인지입니다. 격차가 작으면 자주 하는 작업 두세 개를 두 모델에 똑같이 맡겨 비교해 보세요.
출처
각주 12개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 클로드 오퍼스 5.5 는 max 추론 강도에서 아티피셜 애널리시스 지능 지수 58점을 받았고, 벨럼은 이를 1위로 적었다 (원 데이터는 아티피셜 애널리시스 한 곳 · 다섯 단계 설정 중 max 가 가장 비싸다)Opus 5.5 took the top spot on the Artificial Analysis Intelligence Index with an index score of 58 at max efforthttps://www.vellum.ai/blog/claude-opus-5-5-benchmarks-explained확인 2026-09-28Low: 42점, $0.55 / Medium: 51점, $1.34 / High: 54점, $1.82 / Xhigh: 56점, $3.46 / Max: 58점, $5.98https://news.hada.io/topic?id=34142확인 2026-09-28↩
- 아티피셜 애널리시스 지능 지수에서 클로드 오퍼스 5.5 는 추론 강도 High 설정으로 54점을 받았다Claude Opus 5.5 (Adaptive Reasoning, High Effort, Default Fallback) scores 54 on the Artificial Analysis Intelligence Indexhttps://artificialanalysis.ai/models/claude-opus-5-5-high확인 2026-09-28Low: 42점, $0.55 / Medium: 51점, $1.34 / High: 54점, $1.82 / Xhigh: 56점, $3.46 / Max: 58점, $5.98https://news.hada.io/topic?id=34142확인 2026-09-28↩
- 긱뉴스 정리 글은 클로드 오퍼스 5.5 의 추론 강도를 high 에서 max 로 올리면 지수는 4점 오르고 비용은 약 3.3배가 된다고 적었다high에서 max로 높이면 지능 지수는 4점 상승하지만 비용은 약 3.3배https://news.hada.io/topic?id=34142확인 2026-09-28↩
- 재피어는 오퍼스 5.5 를 대체 모델 없이 평가했고, 복잡한 업무 과제에서 보안 안전장치가 개입하면 그 과제를 실패로 셌다고 앤트로픽이 밝혔다 (벨럼 전언)Anthropic notes that Zapier evaluated Opus 5.5 without fallback models enabled; whenever security safeguards intervened on complex workflow tasks, the task was counted as a failure.https://www.vellum.ai/blog/claude-opus-5-5-benchmarks-explained확인 2026-09-28↩
- 에포크 AI 는 벤치마크 15개를 검토해 9개를 결함으로 판정했다에포크 AI, 벤치마크 검증 착수..."15개 중 9개 결함"https://aitimes.com/news/articleView.html?idxno=215568확인 2026-09-28Epoch AI Flags Nine Major Benchmarks as Flawedhttps://www.theneuron.ai/news/epoch-ai-benchmark-reviews-nine-flawed/확인 2026-09-28↩
- 에포크 AI 는 「검증됨」을 벤치마크를 설명된 대로 대체로 해석할 수 있다는 뜻으로, 「결함」을 실질적인 결함이 하나 이상 있다는 뜻으로 정의한다The benchmark can broadly be interpreted as describedhttps://epoch.ai/data/benchmark-reviews-documentation확인 2026-09-28The benchmark has one or more substantive flawshttps://epoch.ai/data/benchmark-reviews-documentation확인 2026-09-28↩
- 에포크 AI 는 SWE-bench Verified 를 결함으로 판정했고, 오픈AI 감사를 인용해 — 오픈AI 가 모델들이 자주 풀지 못한 작업 27.6%를 감사해 그중 59.4%에서 기능적으로 올바른 제출을 거부하는 결함 테스트 케이스를 찾았고, 이는 전체 작업의 최소 16.4%에 해당한다고 적었다They audited 27.6% of the tasks, finding that 59.4% had flawed test cases that rejected functionally correct submissions (floor of 16.4% of tasks broken).https://epoch.ai/benchmarks/swe-bench-verified/review확인 2026-09-28An audit by OpenAI found that over half of commonly unsolved questions had test cases that rejected functionally correct submissions. This audit gives us reasonable confidence that over 20% of questions have scoring-based issues and informs our Flawed designation.https://epoch.ai/benchmarks/swe-bench-verified/review확인 2026-09-28↩
- 에포크 AI 의 SWE-bench Verified 리뷰는 오픈AI 분석을 옮겨, 오픈AI 가 시험한 프런티어 모델 모두가 훈련 중에 적어도 일부 문제와 해결책을 접했다고 적었다OpenAI’s analysis further revealed that all frontier models tested “have seen at least some of the problems and solutions during training,”https://epoch.ai/benchmarks/swe-bench-verified/review확인 2026-09-28↩
- 2023년 10월 arXiv 에 처음 올라온 리(Li) 등의 오염 보고서는 15개가 넘는 인기 LLM 을 객관식 벤치마크 6개로 분석해 오염 수준이 1%에서 45%까지라고 보고했고, 오염이 곧 점수 상승으로 이어지지는 않는다고 적었다This paper presents an extensive data contamination report for over 15 popular large language models across six popular multiple-choice QA benchmarks.https://arxiv.org/abs/2310.17589확인 2026-09-28Our experiments reveal varying contamination levels ranging from 1\% to 45\% across benchmarkshttps://arxiv.org/abs/2310.17589확인 2026-09-28data contamination does not necessarily lead to increased model metricshttps://arxiv.org/abs/2310.17589확인 2026-09-28↩
- 앤트로픽은 오퍼스 5.5 공식 발표문에서 이 능력 수준에서는 벤치마크 점수 차이가 실제 쓰임의 차이를 보여 주는 길잡이로서 덜 믿을 만해졌고, 자사 사용에서는 오퍼스 5.5 와 클로드 페이블 5.1 의 차이가 점수가 보여 주는 것보다 좁다고 적었다at these levels of capability we've found that benchmark margins have become a less reliable guide to real-world differenceshttps://www.anthropic.com/claude-opus-5-5확인 2026-09-28In our own use, the gap between Opus 5.5 and Claude Fable 5.1 is narrower than these scores suggesthttps://www.anthropic.com/claude-opus-5-5확인 2026-09-28↩
- 코드래빗은 자체 평가에서 오퍼스 5.5 를 써 볼 가장 큰 이유가 찾아내는 버그의 조합이 다르다는 것이라 적었고, 효율은 열린 질문이라 낮은 토큰 가격이 실제 리뷰 비용 절감으로 이어지는지 팀이 확인해야 한다고 적었다The strongest reason to try Opus 5.5 is that it finds a different mix of bugs.https://coderabbit.ai/blog/opus-5-5-model-review확인 2026-09-28Its efficiency remains an open question, so teams should verify whether its lower token prices actually translate into lower production-review costs.https://coderabbit.ai/blog/opus-5-5-model-review확인 2026-09-28↩
- AI타임스의 3D 코딩 비교에서 오퍼스 5.5 는 디테일, GPT-5.6 은 비용·속도로 갈렸고 결과물의 퀄리티와 비용은 엇갈렸다3D 코딩 대결...클로드 오퍼스 5.5 "디테일" vs GPT-5.6 "비용·속도"https://aitimes.com/news/articleView.html?idxno=215618확인 2026-09-28결과물의 퀄리티와 비용은 엇갈렸다https://aitimes.com/news/articleView.html?idxno=215618확인 2026-09-28↩