 P3T
생성형 AI 원리, 답 대신 다음 한 조각을 고릅니다
지금까지의 글을 보고 다음 한 조각을 확률로 고르는 일을 반복합니다
- 무슨 일
- AI 가 자신 있게 틀리고, 어제 알려준 것을 오늘 모릅니다.
- 확인된 것
- 모델이 하는 일은 다음 토큰 후보에 확률을 매겨 하나를 고르는 것입니다.
- 왜 중요한가
- 그래서 겪는 문제 셋이 따로가 아니라 한 구조에서 나옵니다.
- 오늘 할 일
- AI 에 물을 때 필요한 자료를 대화창에 같이 넣습니다.
AI는 다음 한 조각을 확률로 고르는 계산기이고, 우리가 겪는 문제 상당수가 그 구조와 맞물려 있습니다.
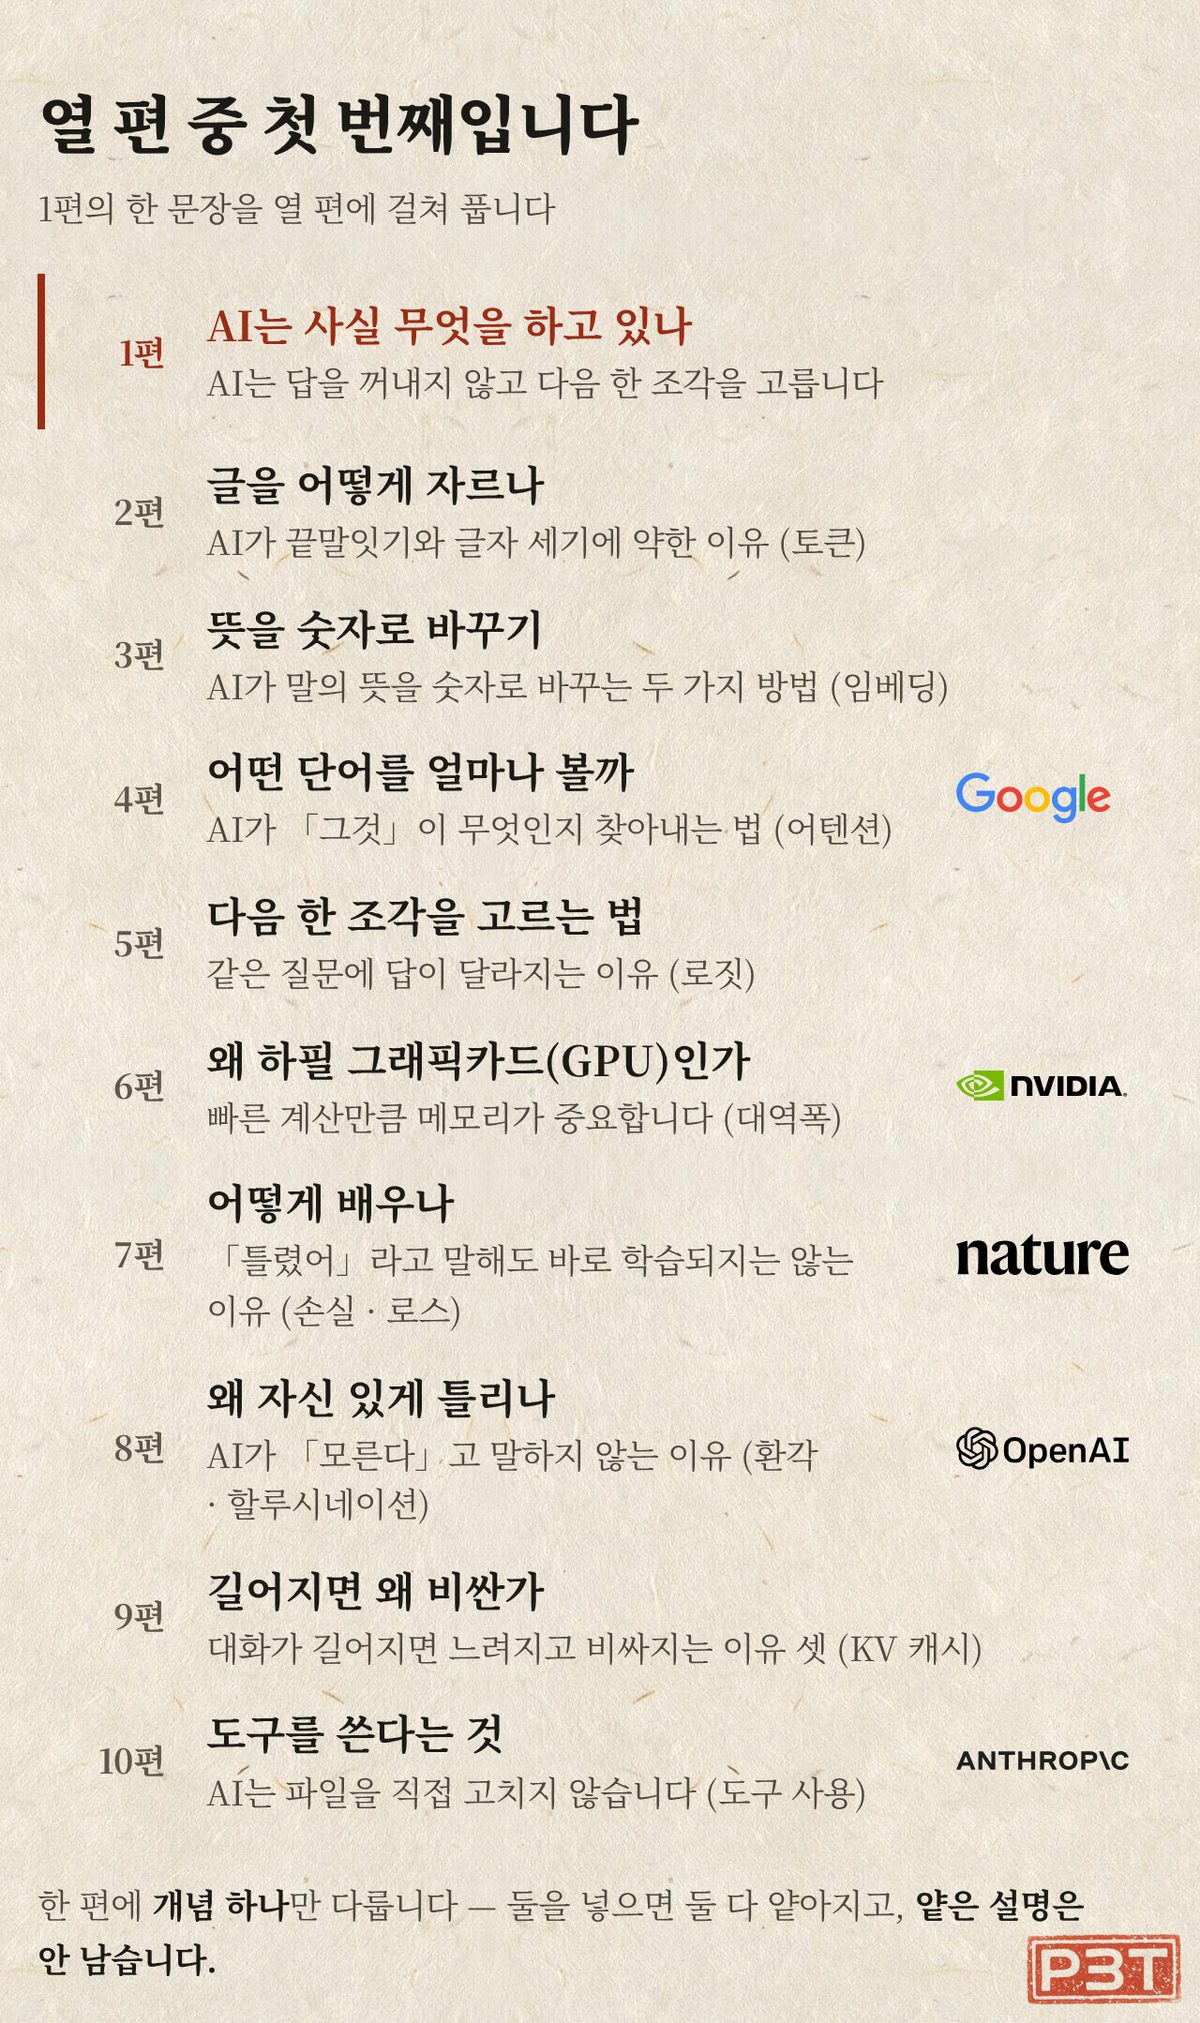
AI를 쓰다 보면 비슷한 일을 자주 겪습니다. 자신 있게 틀린 말을 하고, 어제 알려준 걸 오늘 모르고, 대화가 길어지면 답이 흐려집니다. 따로 생긴 문제 같지만, AI가 안에서 하는 일 하나를 알면 셋 다 훨씬 잘 보입니다. 이 시리즈는 생성형 AI 가운데 글을 다루는 쪽 이야기입니다. 그림을 그리는 AI는 여기서 다루지 않습니다.
하는 일은 딱 하나입니다. 다음 한 조각 찍기
먼저 비유 없이 한 문장으로 적겠습니다. AI는 지금까지의 글을 보고 다음에 올 한 조각을 확률로 고르는 일을 계속 반복하는 계산기입니다.
말로만 들으면 감이 잘 안 옵니다. 「아빠 손」까지 적어 놓고 다음 한 조각을 고른다고 해 봅시다. 사람은 「수건」을 그냥 떠올립니다. AI는 그냥 떠올리지 않습니다. AI가 들고 있는 단어 사전에 있는 모든 조각을 전부 후보로 놓고 아빠 손수건도, 아빠 손물결도, 아빠 손코끼리도 하나하나 따져 봅니다. 답을 아는 것과 후보를 전부 재 보는 것은 다른 일입니다.
예전에는 규칙을 하나하나 적어 줬습니다. 「이런 문장이 오면 이렇게 답해라」 하는 식입니다. 그런데 말은 경우의 수가 끝이 없어서 규칙을 다 적을 수가 없습니다. 그래서 규칙을 적는 대신 예문을 아주 많이 주고 스스로 규칙을 찾게 했습니다.
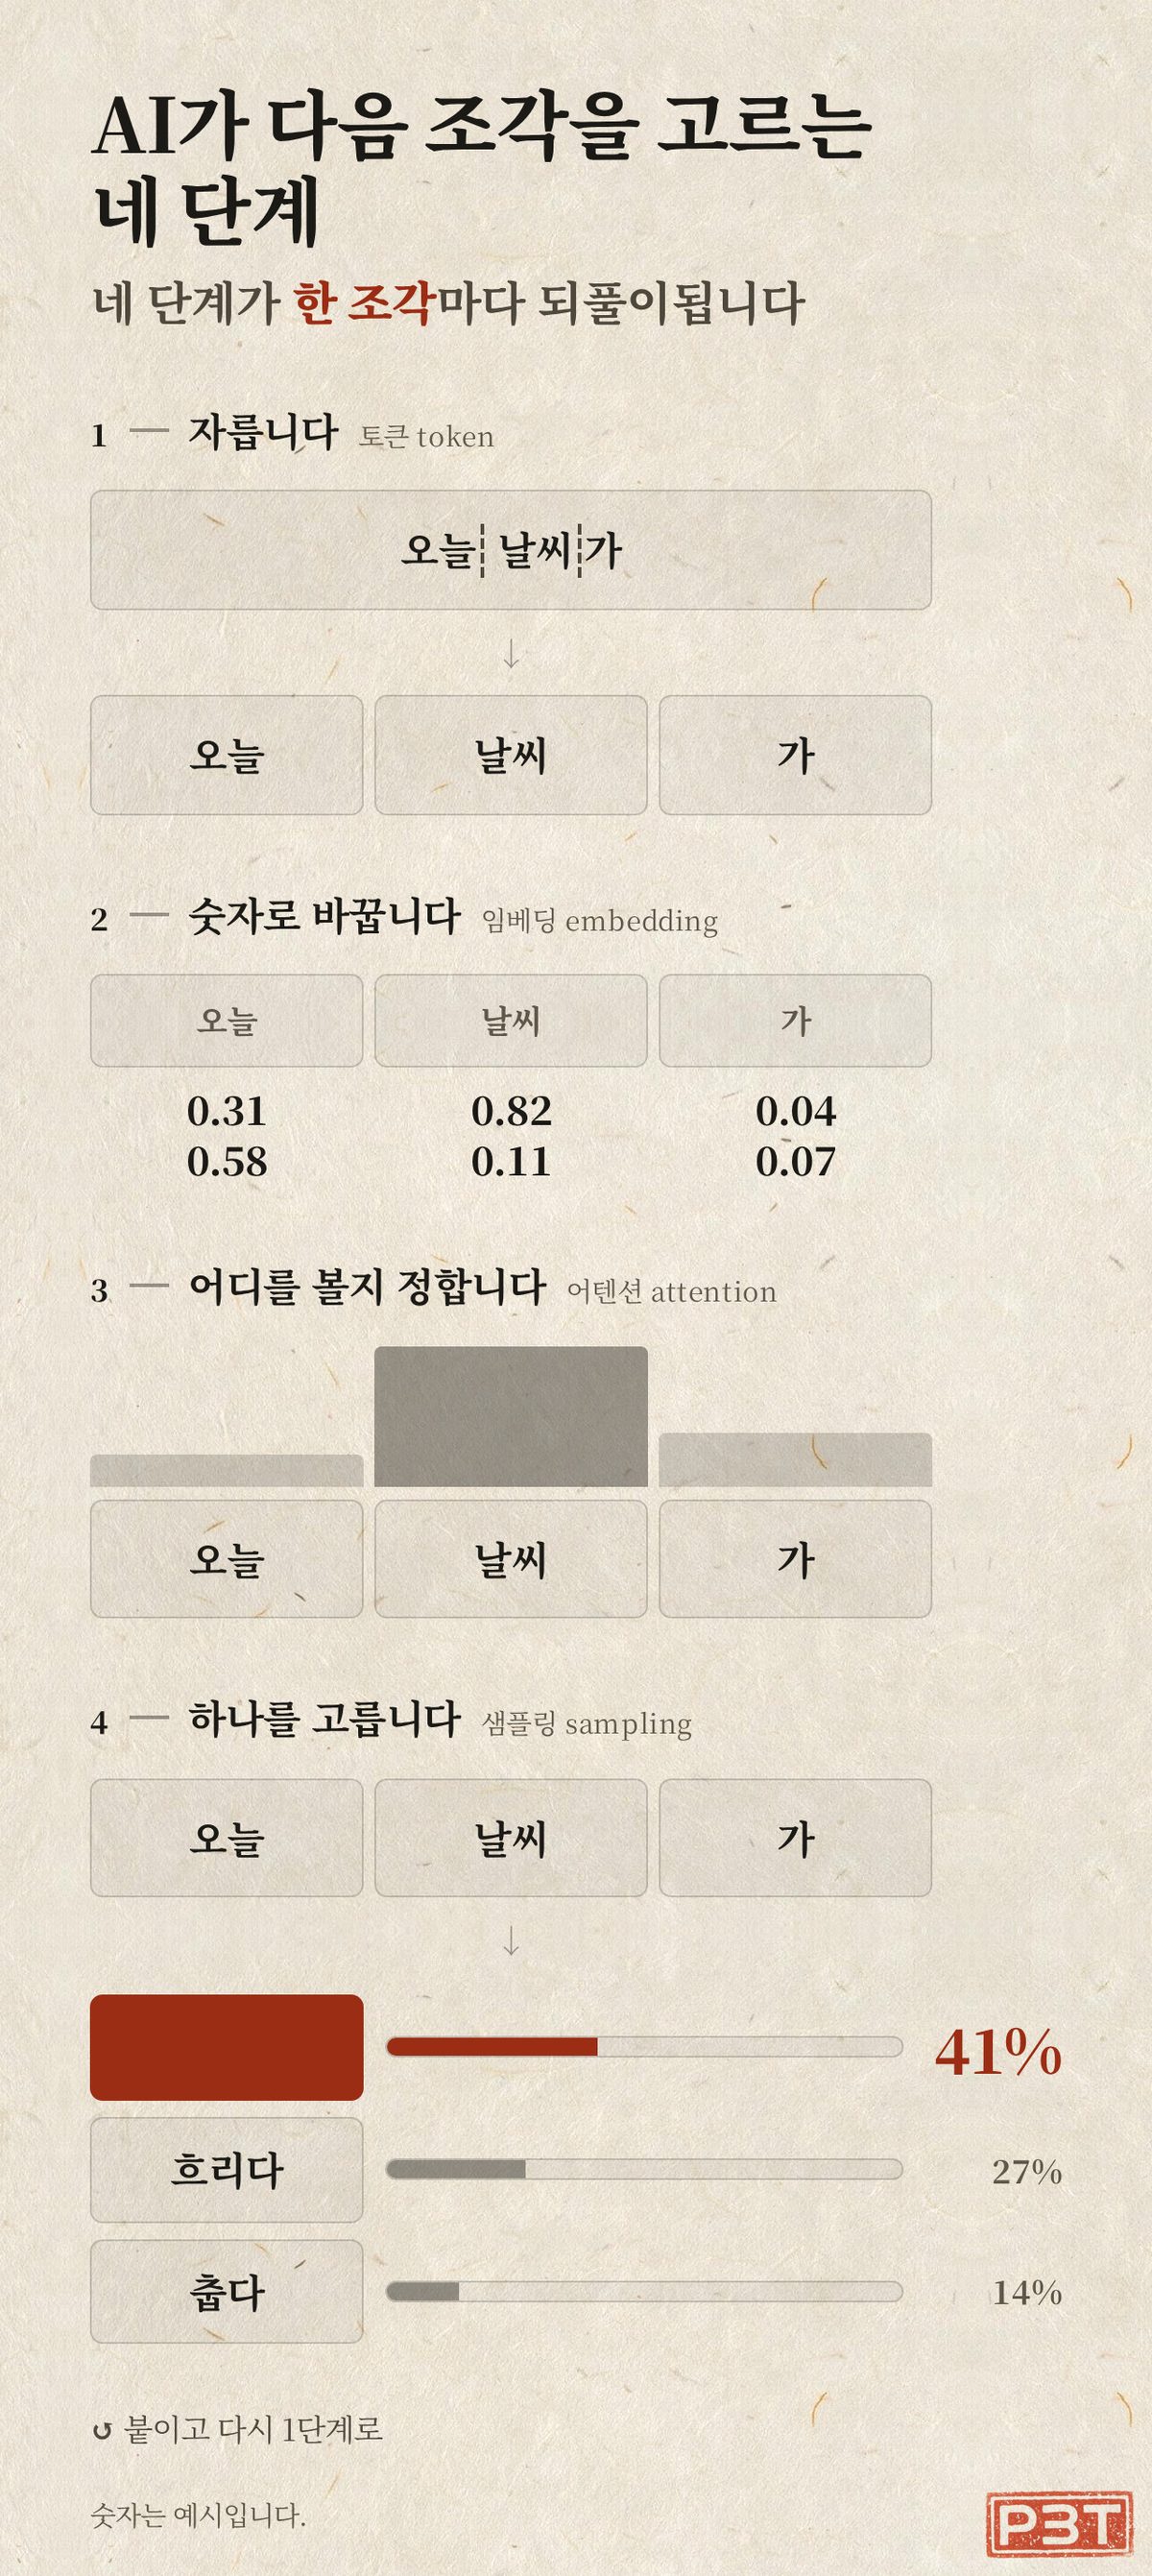
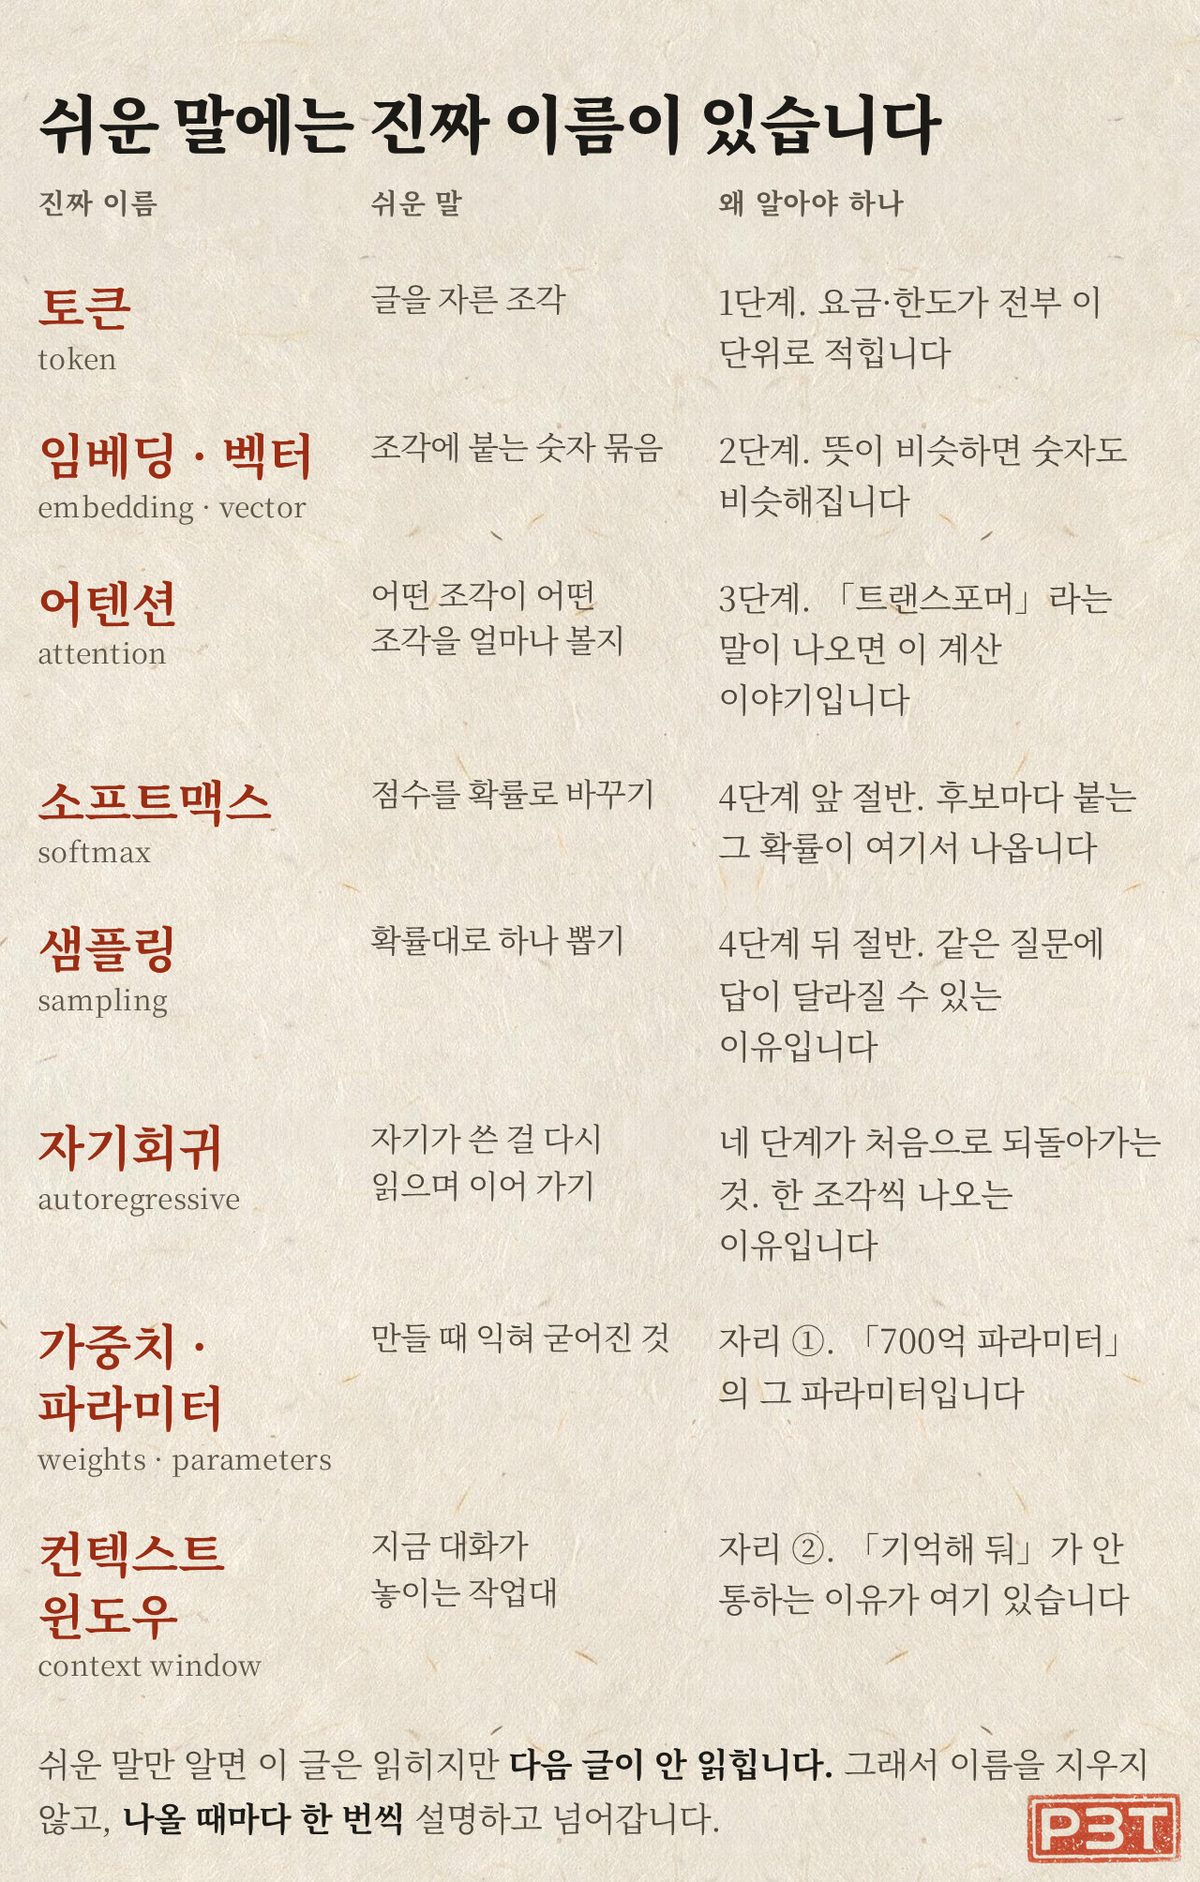
이때 AI 안에서는 네 단계가 돌아갑니다. 하나, 글을 조각으로 자릅니다. 이 조각을 토큰(token)이라고 부릅니다. 대개 단어보다 작습니다. 둘, 조각마다 숫자 묶음을 붙입니다. 뜻이 비슷하면 숫자도 비슷해집니다. 셋, 어떤 조각이 어떤 조각을 얼마나 참고할지 계산합니다. 이것이 어텐션(attention)이고, 요즘 AI에서 가장 중요한 계산 가운데 하나입니다. 넷, 다음에 올 후보마다 점수를 매겨 확률로 바꾸고 그중 하나를 뽑습니다.
그리고 다시 첫 단계로 갑니다. 방금 AI가 스스로 뽑은 조각을 뒤에 붙이고 그다음 조각을 다시 계산합니다. 자기가 쓴 걸 다시 읽으며 이어 가는 셈입니다. 다만 실제 제품은 앞서 해 둔 계산을 저장했다가 다시 씁니다. 그 이야기는 9편에서 다룹니다.
다만 다음 토큰 하나를 고르는 동안, 앞서 본 네 단계가 똑같이 반복되는 것은 아닙니다. 여러 층으로 쌓이는 핵심 부분은 세 번째 단계입니다. 각 층은 어텐션으로 문장 안의 관계를 살핀 뒤, 신경망으로 그 결과를 가공합니다. 이 계산 묶음을 여러 겹 쌓은 구조가 트랜스포머(Transformer)입니다. GPT라는 이름의 'T'도 여기서 왔습니다. 오늘날 글을 생성하는 주요 언어 모델 대부분은 이 구조를 바탕으로 만들어집니다.
왜 이렇게 만들게 됐을까요. 출발점이 된 논문이 있습니다
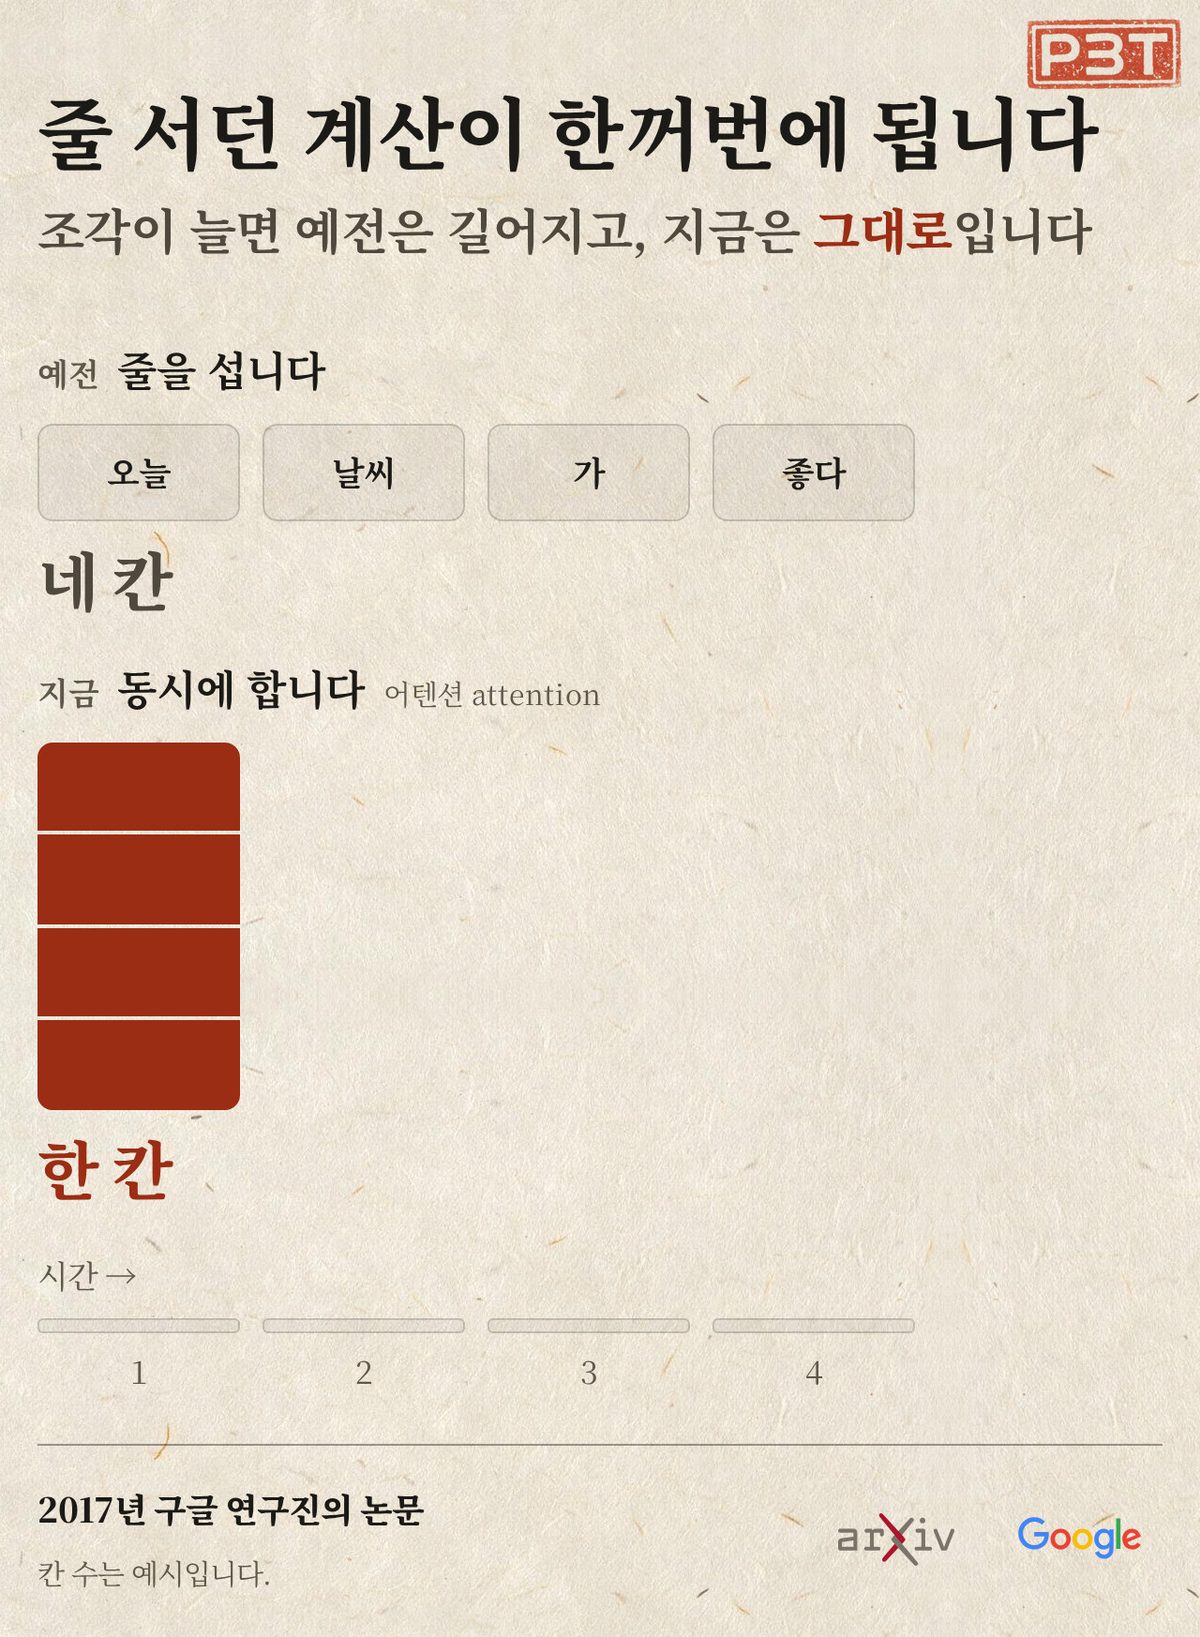
셋째 단계가 왜 판을 바꿨는지 봅니다. 예전 방식은 글을 앞에서부터 한 조각씩 읽으며 기억을 이어 갔습니다. 뒤로 갈수록 앞서 읽은 내용이 흐려졌고, 순서를 지켜야 하니 한꺼번에 계산할 수 없었습니다.
2017년, 구글 연구진은 「Attention Is All You Need」라는 논문에서 새로운 구조를 발표했습니다. 이전 모델은 문장을 앞에서부터 차례로 처리하는 순환 신경망이나, 가까운 정보부터 묶어 보는 합성곱 신경망을 주로 사용했습니다. 연구진은 이 두 방식을 걷어내고, 문장 안의 각 조각이 다른 조각을 얼마나 참고해야 하는지 계산하는 어텐션을 중심으로 모델을 만들었습니다. 이것이 트랜스포머입니다. 문장의 여러 조각을 한꺼번에 처리할 수 있어 계산을 나눠 수행하기 쉬웠고, 논문에 실린 번역 실험에서는 기존 모델보다 학습 시간도 크게 줄었습니다.1 2
여기서부터는 논문에 적힌 말이 아니라 제 설명입니다. 여러 계산을 한꺼번에 처리할 수 있다는 점은 GPU와 잘 맞았습니다. GPU는 원래 게임 화면의 수많은 픽셀을 동시에 계산하기 위해 만들어졌습니다. 이전 방식처럼 계산을 하나씩 순서대로 처리해야 할 때는 이런 장점을 충분히 살리기 어려웠지만, AI가 사용하는 대규모 행렬 계산은 많은 연산을 동시에 수행할 수 있었습니다. 게임 화면을 빠르게 그리던 GPU가 AI 계산의 핵심 장치로 떠오른 이유입니다. AI 이야기에서 엔비디아가 빠지지 않는 배경도 여기에 있습니다.
「확률로 고른다」는 이런 장면입니다
네 번째 단계를 더 봅니다.
「오늘 날씨가」까지 썼다고 합시다. AI는 다음에 올 후보 전부에 점수를 매깁니다. 좋다, 흐리다, 춥다. 점수를 전부 0과 1 사이로 옮기고 합이 1이 되게 만들면 확률이 됩니다. 오픈AI 문서는 이 값을 「주어진 문맥에서 각 토큰이 나올 가능성」이라고 적습니다3.
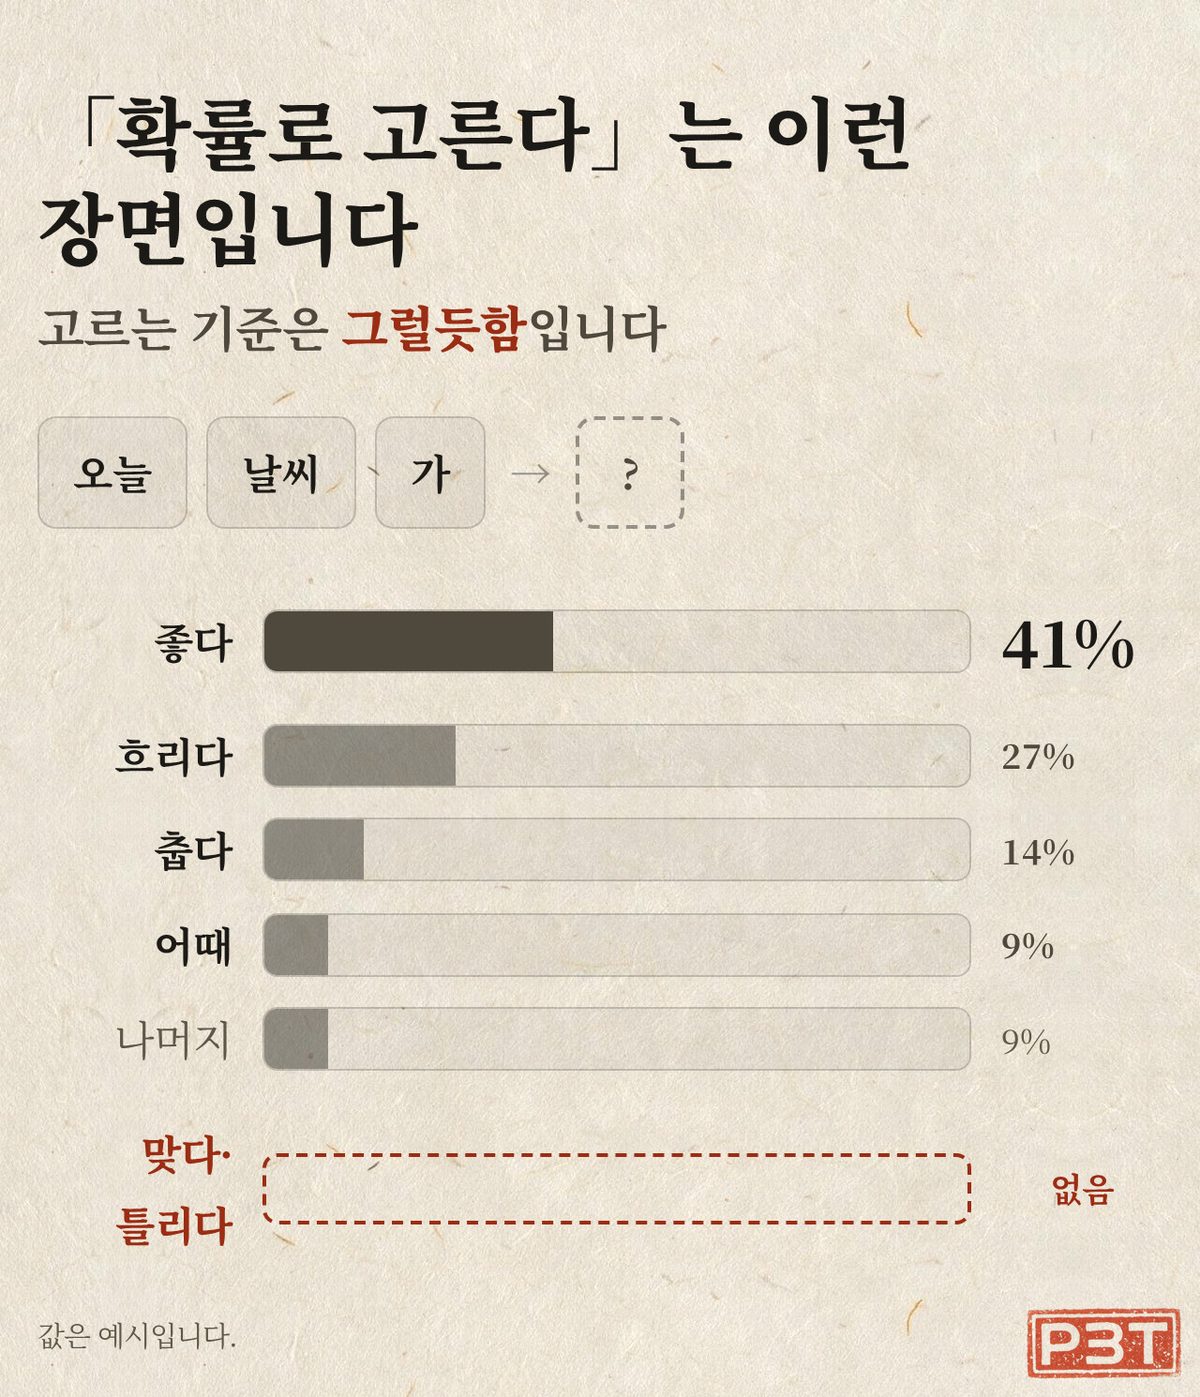
여기서 두 가지를 알 수 있습니다. 첫째, AI가 언제나 점수가 가장 높은 후보만 고르는 것은 아닙니다. 설정에 따라 여러 후보 가운데 하나를 확률적으로 선택하기에 같은 질문에도 다른 답이 나올 수 있습니다. 무작위성을 가장 낮게 설정하더라도 결과가 항상 똑같아지는 것은 아니라고 앤트로픽 문서도 설명합니다4.
둘째, 다음 토큰을 고르는 확률표에는 맞다·틀리다의 사실을 판정하는 항목이 따로 없습니다. 모델이 다음 토큰을 고르는 기준은 「그럴듯함」이고, 어떤 토큰이 자연스럽게 이어질 가능성이 높은가입니다. 즉, 모델이 계산하는 것은 사실 여부가 아닌 문맥의 자연스러움입니다.
다만 AI가 자신 있게 틀리는 이유가 이 구조 하나에 있는 것은 아닙니다. 무작위성을 0으로 낮춰도 틀린 말은 여전히 나올 수 있습니다. 오픈AI 연구진이 2025년에 낸 논문은 훈련 이후의 평가 방식에도 원인이 있다고 지적합니다. 점수로만 성능을 평가하면, 모델은 확실하게 0점을 받는 「모른다」고 말하는 쪽보다 하나라도 맞힐 수 있는 「찍는」 쪽으로 답해 왔다는 것입니다5. 시험을 잘 보도록 길러 온 셈입니다.
AI의 기억은 두 군데로 나뉩니다
여기까지 알면 AI가 왜 이전 대화를 기억 못 하는지가 풀립니다. AI가 정보를 다루는 자리가 크게 두 군데로 나뉘기 때문입니다.
하나는 학습 과정에서 만들어진 가중치입니다. AI는 수많은 예문을 보면서 내부의 숫자들을 조정하고, 학습이 끝난 뒤에는 이 값을 고정해 놓고 사용합니다. 대화 중에는 가중치가 바뀌지 않으므로 지금 나눈 이야기가 곧바로 모델의 새로운 지식으로 저장되지는 않습니다. 다른 하나는 현재의 대화 내용과 자료를 펼쳐두는 컨텍스트 윈도우입니다. AI가 지금 수행하는 작업에 사용하는 재료를 모아 놓는 일종의 작업대로서 앤트로픽 공식 문서도 이 둘을 나누어 설명합니다. 이 작업대는 학습한 데이터와 다르며 모델의 「작업 기억」에 해당한다고 적습니다6.
헷갈리기 쉬운 대목이라 비유를 하나 들겠습니다. 식당 주방을 떠올려 보세요. 요리사가 익혀 둔 조리법은 가게 문을 열기 전에 이미 정해져 있습니다. 요리사는 익혀 둔 조리법을 이용해 조리대 위의 재료들을 사용해 요리합니다. 조리대는 이번 주문에만 쓰이고, 주문이 끝나면 비웁니다. 앞에서 말한 작업대가 이 조리대입니다. 하지만 조리법을 안다고 조리대가 반드시 넓은 것은 아니고, 조리대가 넓다고 새로운 조리법을 더 많이 아는 것도 아닙니다. 둘은 서로 상관이 없습니다. 모델의 크기와 한 번에 처리할 수 있는 대화의 길이는 서로 구분해서 봐야 하는 별개의 특성입니다.
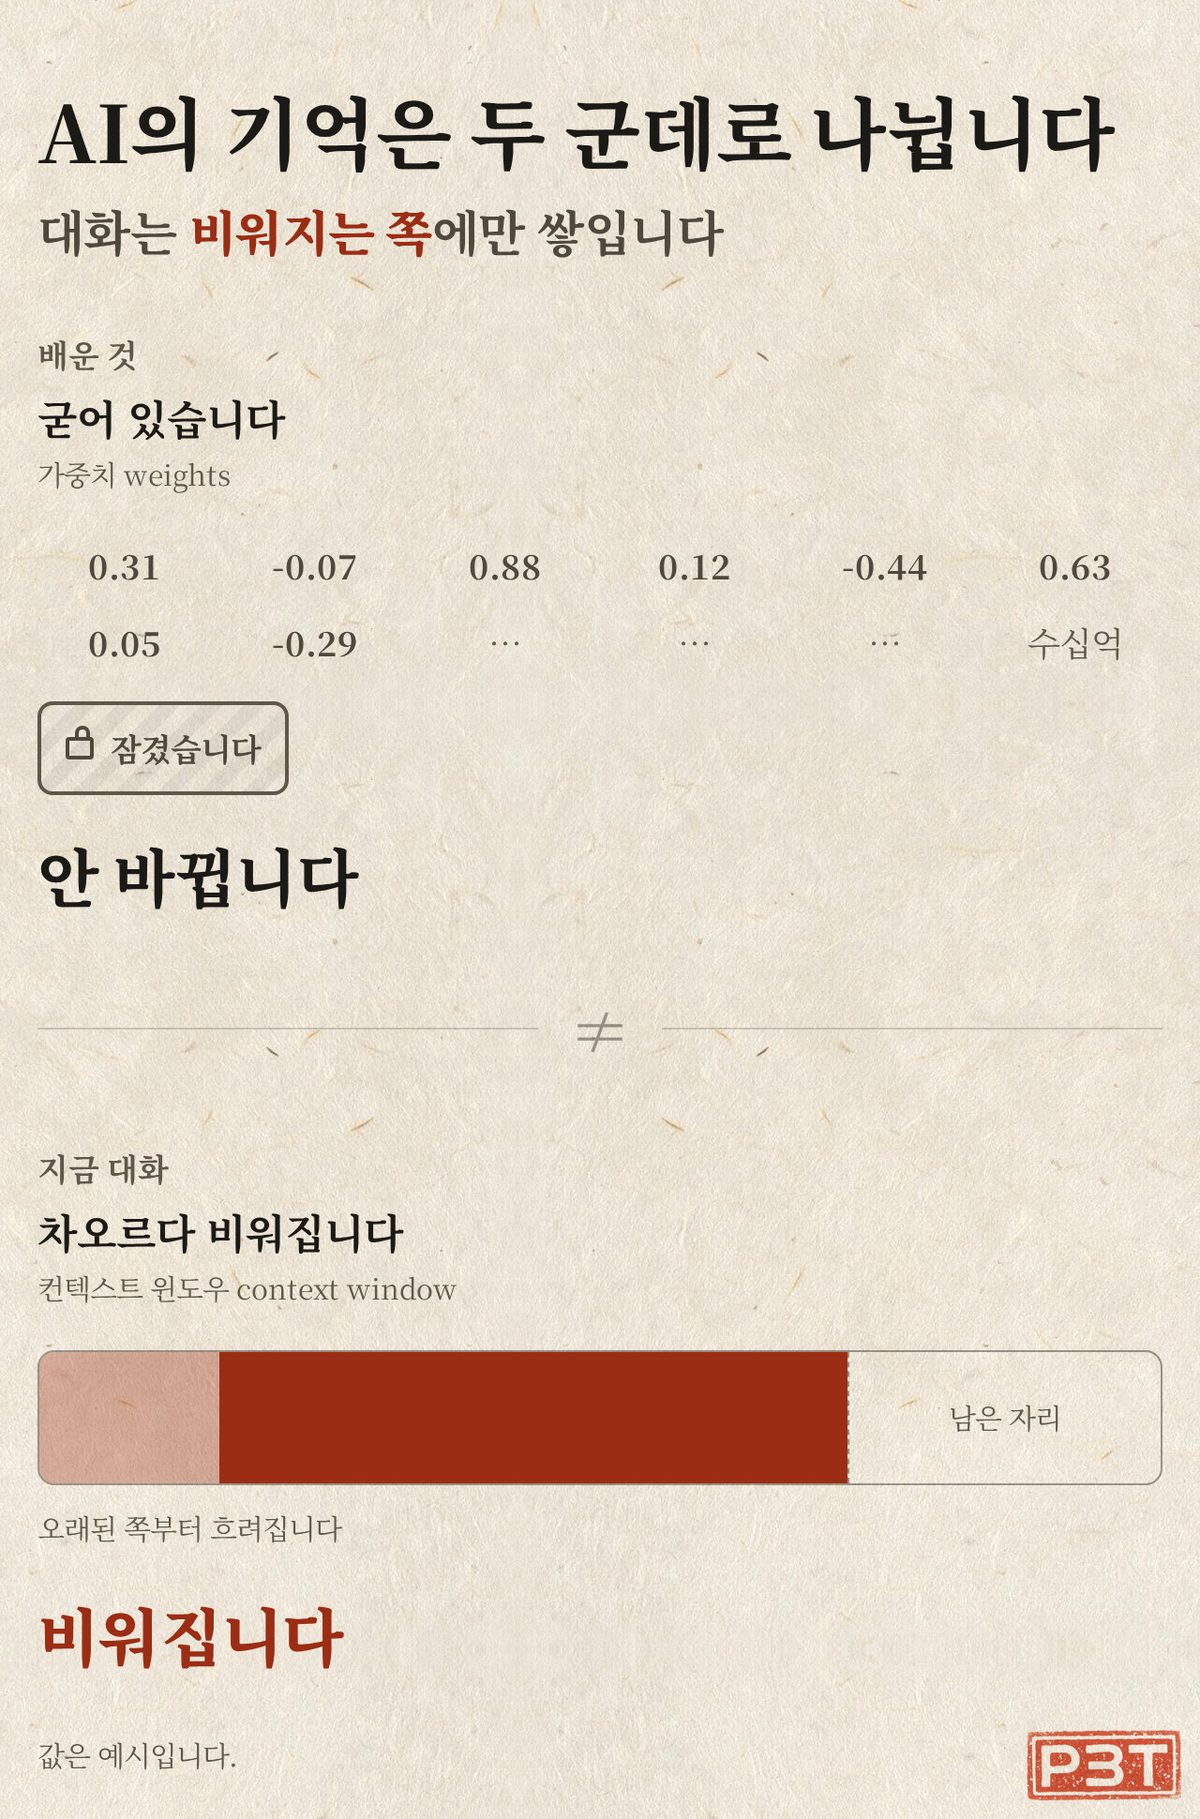
그래서 「기억해 둬」는 모델 쪽에 통하지 않습니다. 대화를 한다고 모델이 배운 값이 바뀌지는 않기 때문입니다.
참고로, 대화가 끝난 뒤에도 AI가 내용을 기억하는 것처럼 보일 때는, 서비스가 대화 내용이나 요약을 별도로 저장했다가 다음 요청에 다시 넣어 주는 경우가 있습니다. 이는 모델의 가중치가 대화하면서 바뀐 것과는 다른 방식입니다.
이 작업대는 넓힐수록 좋기만 한 것도 아닙니다. 앤트로픽 문서는 같은 자료를 넣어도 토큰이 늘수록 답이 흐려지고 앞에 준 내용을 놓치기 시작한다고 적습니다. 그리고 이 현상을 컨텍스트 로트(context rot · 문맥이 길어질수록 흐려진다는 뜻)라고 부릅니다7.
방금 본 네 단계가 실제로 어떻게 생겼는지 걸어 다니듯 둘러볼 수 있는 사이트가 있습니다. 브렌던 바이크로프트가 만든 LLM Visualization은 모델 안을 3차원 구조물로 세워 두고, 글이 들어와 다음 조각이 나오기까지를 여러 장으로 나누어 한 단계씩 짚어 줍니다. 아주 작은 모델부터 시작해 GPT-2와 GPT-3까지 같은 방식으로 볼 수 있어서, 「모델이 커진다」는 말이 무엇이 커진다는 뜻인지도 눈에 들어옵니다. bbycroft.net/llm 입니다.
읽고 나서 해 볼 것
다음에 AI가 이상한 답을 내면, 같은 질문을 어조만 세게 바꿔 다시 쓰지 마시고 필요한 자료를 대화창에 직접 붙여 넣어 보세요. 묻는 방식이 아니라 주는 재료를 바꾸는 것이 이 구조에 맞는 대응입니다.
출처
각주 7개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 2017년 구글 연구진의 「Attention Is All You Need」는 순환(recurrence)과 합성곱을 통째로 걷어내고 어텐션만으로 만든 구조를 제안했다We propose a new simple network architecture, the Transformer, based solely on attention mechanisms, dispensing with recurrence and convolutions entirely.https://arxiv.org/abs/1706.03762확인 2026-09-01↩
- 같은 논문은 이 구조가 더 잘 병렬화되고 학습 시간이 훨씬 적게 든다고 적는다Experiments on two machine translation tasks show these models to be superior in quality while being more parallelizable and requiring significantly less time to train.https://arxiv.org/abs/1706.03762확인 2026-09-01↩
- 모델은 다음에 올 토큰 후보마다 확률을 매기며, 그 값은 API 로 꺼내 볼 수 있다. OpenAI 는 로그 확률을 「주어진 문맥에서 각 토큰이 그 자리에 나타날 가능성」으로 설명한다Log probabilities of output tokens indicate the likelihood of each token occurring in the sequence given the context.https://developers.openai.com/cookbook/examples/using_logprobs확인 2026-09-01↩
- 무작위성 설정을 0으로 낮춰도 결과가 완전히 결정적이지는 않다Note that even with `temperature` of `0.0`, the results will not be fully deterministic.https://platform.claude.com/docs/en/api/messages/create확인 2026-09-01↩
- 환각의 원인을 확률적 선택 구조 하나로 돌릴 수 없다. OpenAI 연구진은 훈련과 평가 절차가 불확실함을 인정하는 것보다 추측을 보상하기 때문이라고 적는다language models hallucinate because the training and evaluation procedures reward guessing over acknowledging uncertaintyhttps://arxiv.org/abs/2509.04664확인 2026-09-01↩
- 컨텍스트 윈도우는 학습에 쓰인 데이터와 다른 자리이며 모델의 「작업 기억」에 해당한다This is different from the large corpus of data the language model was trained on, and instead represents a "working memory" for the model.https://platform.claude.com/docs/en/build-with-claude/context-windows확인 2026-09-01↩
- 컨텍스트를 넓게 쓸수록 좋기만 한 것이 아니다. 토큰 수가 늘면 정확도와 회상이 떨어지며 이 현상에는 컨텍스트 로트라는 이름이 있다As token count grows, accuracy and recall degrade, a phenomenon known as context rot.https://platform.claude.com/docs/en/build-with-claude/context-windows확인 2026-09-01↩