 P3T
AI 토큰이란? 끝말잇기와 글자 세기에 약한 이유
최소 단위가 글자가 아니라 토큰이라, 글자 세기와 끝말잇기에 약합니다
- 무슨 일
- AI 가 끝말잇기와 글자 세기에서 자꾸 틀립니다.
- 확인된 것
- strawberry 는 st·raw·berry 세 토큰으로 잘립니다.
- 왜 중요한가
- 한국어는 같은 뜻을 더 많은 토큰으로 써서 요금이 더 붙습니다.
- 오늘 할 일
- 글자를 다루는 일은 AI 말고 도구에 맡깁니다.
AI는 글을 글자 그대로 보지 않고 토큰이라는 덩어리로 나누기 때문에 글자 세기와 끝말잇기에 약합니다.
AI와 끝말잇기를 해 보면 금방 이상해집니다. 「기차」 다음에 「차표」가 나와야 하는데 엉뚱한 말을 내놓습니다. 낱말을 몰라서가 아닙니다. AI는 말을 글자로 보고 있지 않습니다. AI가 보는 것은 「토큰」이라는 덩어리입니다. 오늘은 네 단계 중 첫 번째인 자르기를 봅니다. 이 한 단계로 끝말잇기 실패도, 한국어를 쓸 때 요금이 더 나오는 이유도 설명됩니다.
AI가 보는 최소 단위는 글자가 아닙니다
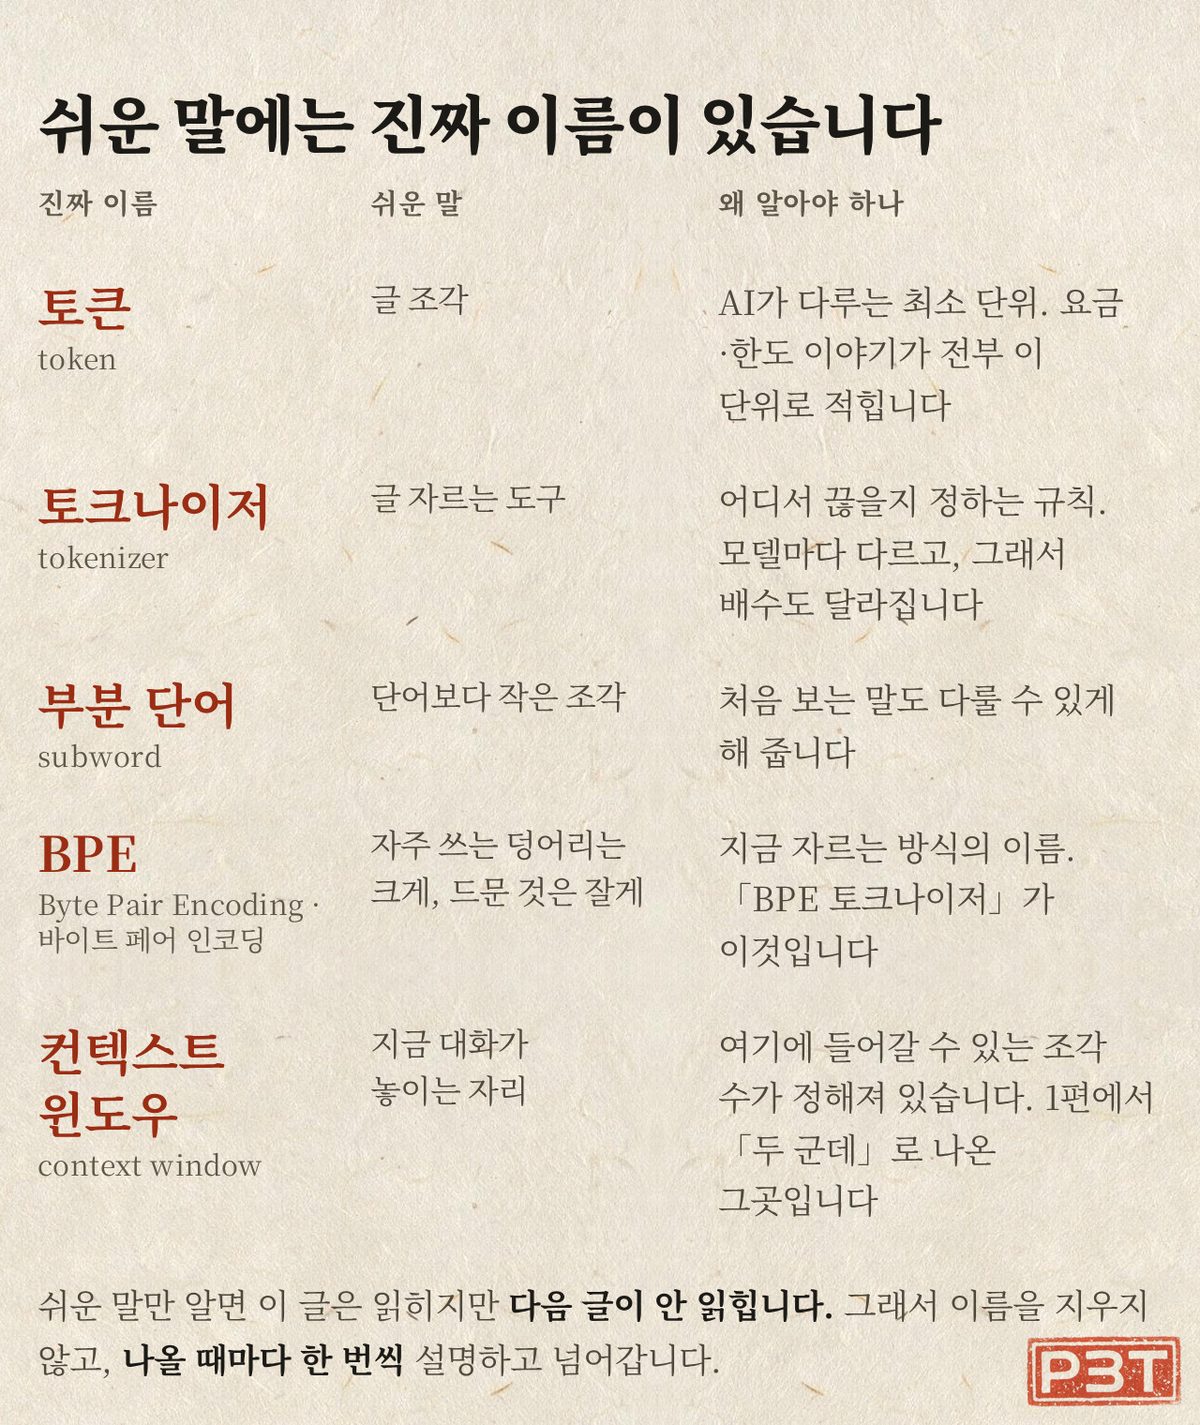
먼저 비유 없이 한 문장으로 적겠습니다. AI가 글을 다룰 때 쓰는 최소 단위는 글자가 아니라 「토큰(token)」이라는 덩어리입니다.
앤트로픽은 토큰을 언어 모델이 글을 처리하는 가장 작은 개별 단위라고 설명합니다. 토큰 하나는 단어 전체일 수도 있고 단어 일부(subword)일 수도 있고 글자나 바이트일 수도 있습니다1. 오픈AI는 이를 「자주 나타나는 문자열」이라고 표현합니다2. 자주 붙어 다니는 덩어리는 통째로 한 토큰이 되고, 드물게 나오는 것은 잘게 쪼개진다는 뜻입니다.
직접 확인해 보겠습니다. 글을 토큰으로 자르는 도구를 토크나이저(tokenizer)라고 하는데, 오픈AI가 공개해 둔 것을 그대로 썼습니다. GPT-4o 계열이 쓰는 o200k_base 방식 기준입니다.
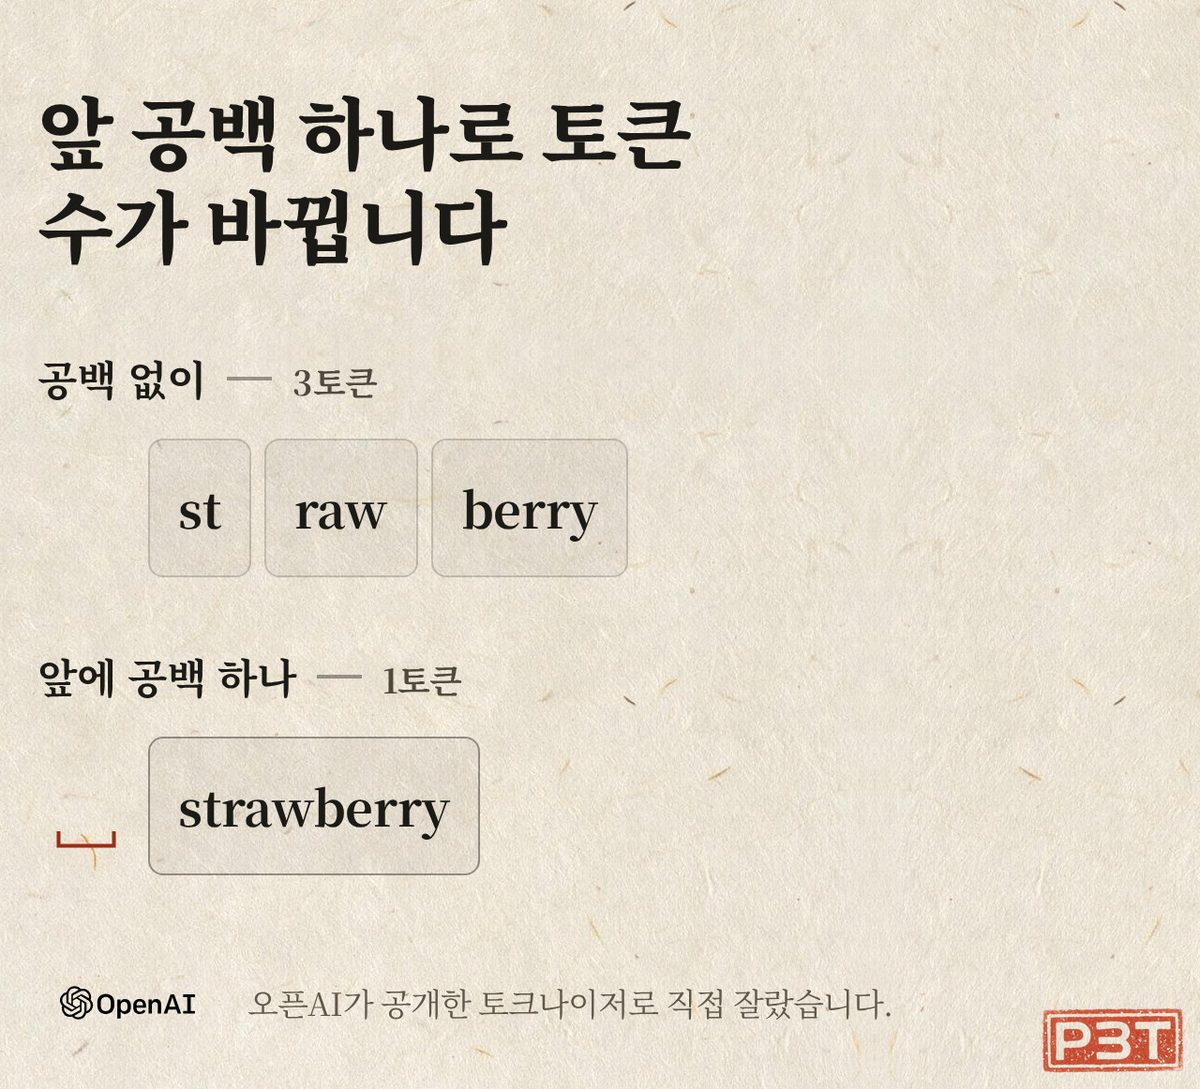
strawberry → st · raw · berry
사람에게는 하나의 단어지만, 모델은 이를 세 토큰으로 처리합니다. 그런데 앞에 공백을 붙인 strawberry는 하나의 토큰이 됩니다. 토크나이저가 공백을 뒤따르는 단어와 함께 묶는 경우가 있기 때문입니다. 이처럼 같은 단어도 앞뒤 문맥이나 공백에 따라 다르게 나뉠 수 있습니다.
왜 단어째로 자르지 않을까요
단어 단위로 자르면 깔끔할 것 같은데 그렇게 하지 않습니다. 처음 보는 이름이나 신제품명, 오타처럼 사전에 없는 단어를 처리하기 어렵기 때문입니다. 세상에는 새로운 말이 계속 생기지만, 미리 만든 단어 목록에는 한계가 있기 때문입니다.
2015년 연구진은 번역 모델이 단어를 더 작은 조각으로 나눠 처리하는 방법을 제시했습니다3. 처음 보는 이름은 글자에 가까운 단위로 나누고, 복합어는 익숙한 부분끼리 나누면 뜻을 다루기 쉬워진다는 접근이었습니다.
그래서 지금의 AI는 자주 나오는 글자 묶음은 크게 잡고, 드문 것은 잘게 나눕니다. 이 방식이 바이트 페어 인코딩(BPE, Byte Pair Encoding)입니다. 덕분에 AI는 처음 보는 단어도 작은 조각으로 쪼개 처리할 수 있습니다. 다만 단어가 여러 조각으로 나뉘면서 철자와 글자 수를 파악하기는 어려워질 수 있습니다.
BPE는 원래 데이터를 압축하려고 나온 아이디어입니다. 자주 반복되는 조각을 하나로 묶고, 그렇게 만든 묶음도 자주 함께 나오면 다시 합칩니다. 이 과정을 반복하면서 「자주 나오는 것은 크게, 드문 표현은 작게」라는 원칙이 자연스럽게 생깁니다.
그래서 글자 세기를 못 합니다
처음 질문으로 돌아갑니다.
AI가 받는 것은 strawberry라는 단어가 아니라 st, raw, berry라는 세 토큰입니다. 각 토큰 안에 어떤 글자가 몇 개 들어 있는지는 별도 정보로 주어지지 않습니다. 세 개의 상자를 건네주고 상자 안에 있는 특정 글자의 수를 묻는 것과 비슷합니다.
2025년 연구도 대규모 언어 모델이 글자 세기 같은 단순한 과제에서 자주 실패하는 원인으로 토큰화를 지목했습니다4.
그래서 AI는 글자 수 세기, 끝말잇기, 철자 뒤집기처럼 글자 하나하나를 봐야 하는 일에 약할 수 있습니다. 프롬프트를 더 강하게 쓴다고 이 문제가 항상 해결되지는 않습니다. 구조상 글자가 직접 보이지 않기 때문입니다. 정확성이 중요하다면 계산기나 코드 같은 도구에 맡기고, AI에게는 그 도구를 사용하고 결과를 설명하는 역할을 맡기는 편이 낫습니다.
한국어는 토큰이 더 나옵니다
토큰은 AI 사용료를 계산하는 기준이기도 합니다. 오픈AI 가격 문서는 모델의 입력과 출력 사용량을 토큰 단위로 계산한다고 설명합니다5. 같은 모델을 써도 같은 뜻을 더 많은 토큰으로 표현하면 비용도 늘어납니다.
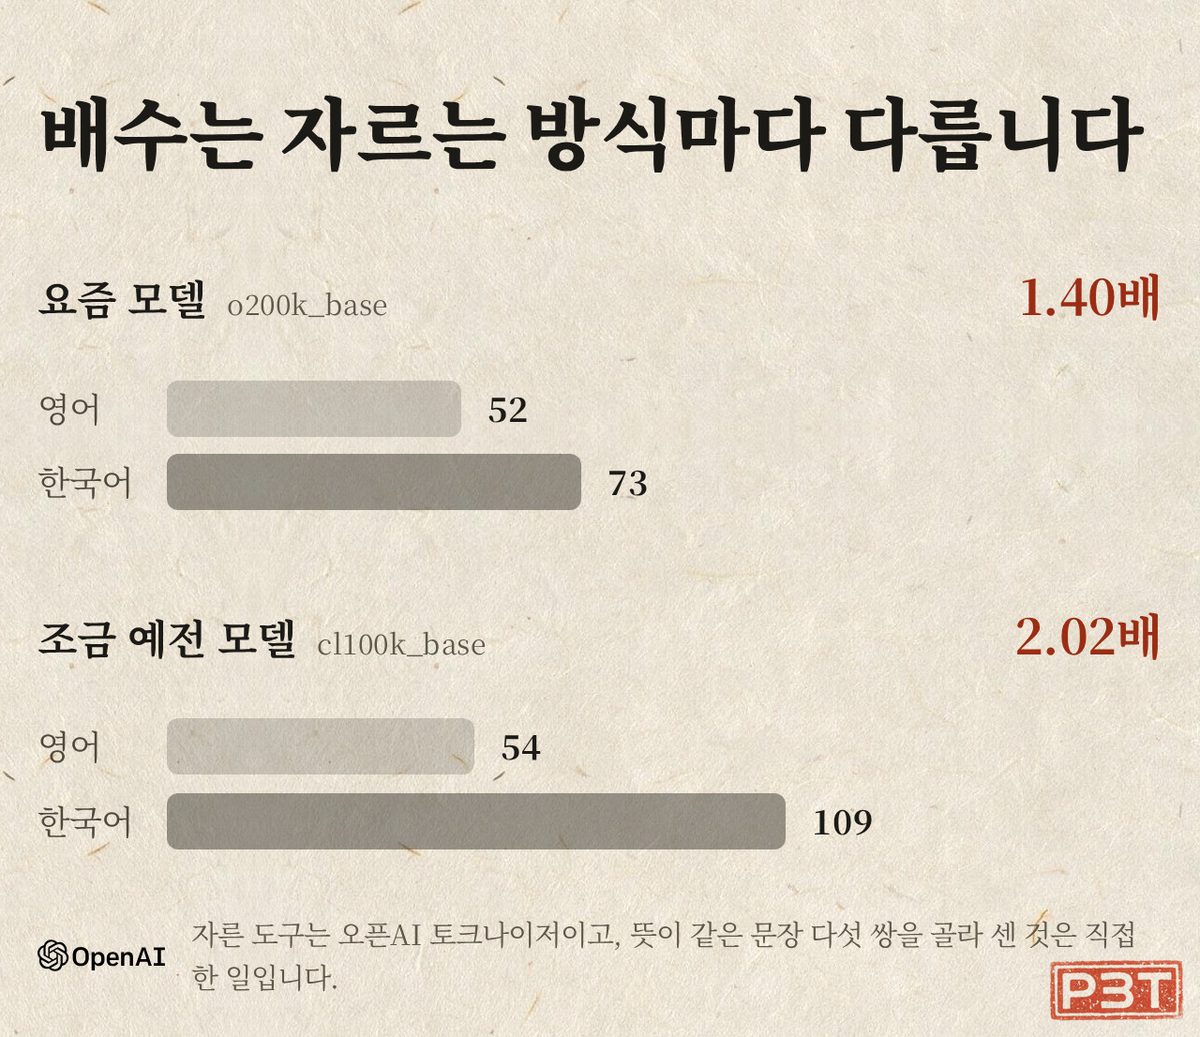
뜻이 같은 한국어와 영어 문장 다섯 쌍을 직접 비교했습니다. GPT-4o 계열의 o200k_base에서는 영어 52토큰, 한국어 73토큰으로 한국어가 1.40배였습니다. GPT-4 계열의 cl100k_base에서는 영어 54토큰, 한국어 109토큰으로 2.02배였습니다.
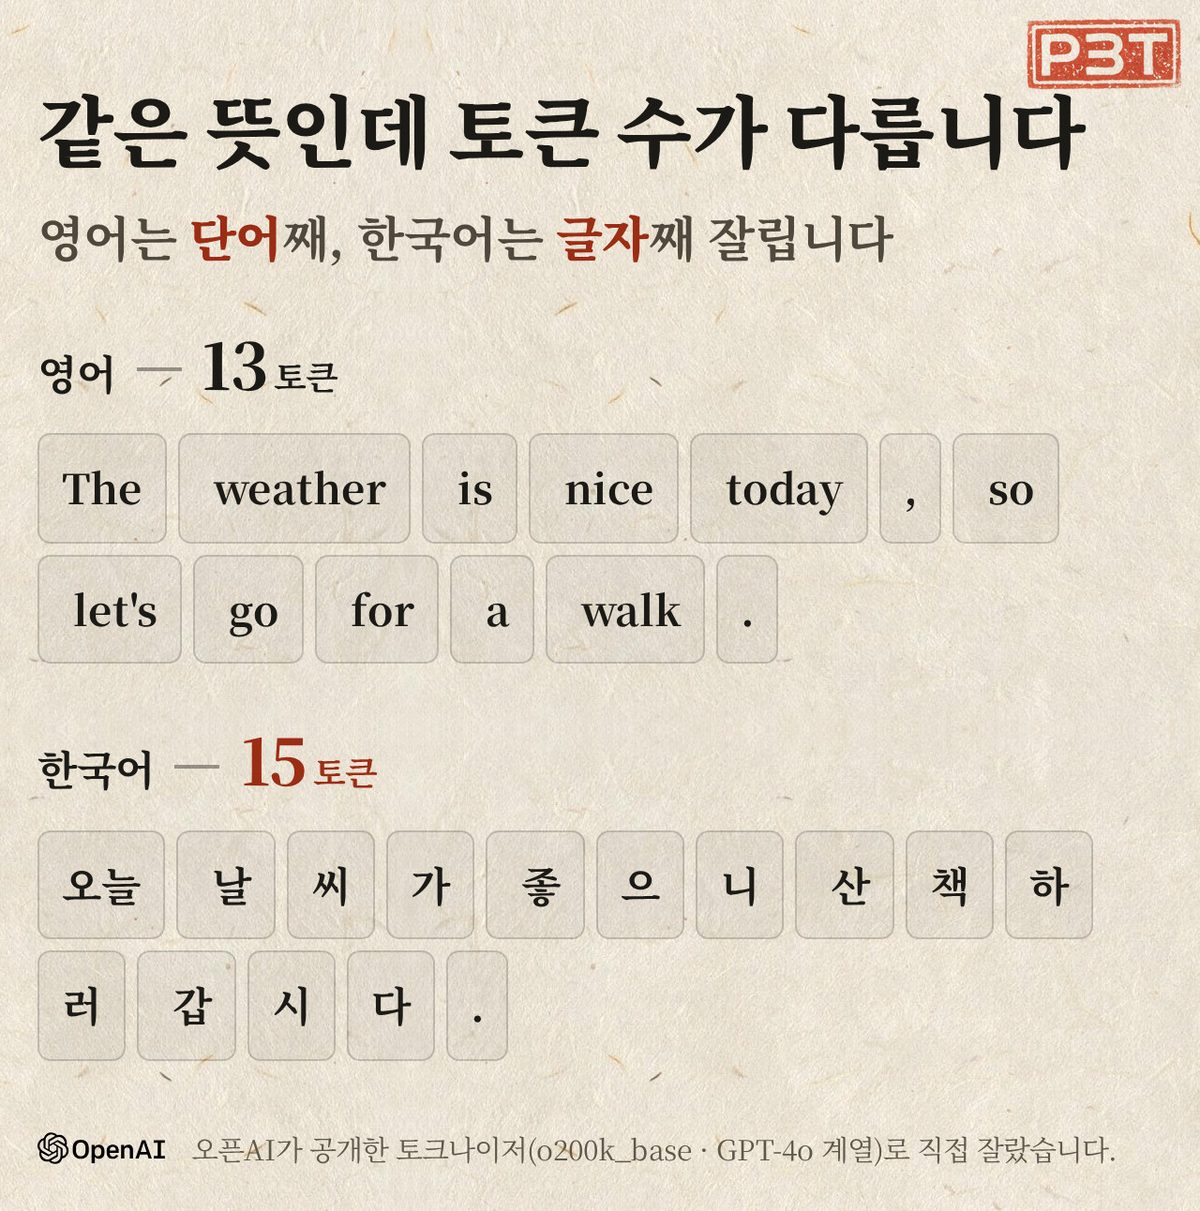
같은 뜻인데 한국어 쪽에서 토큰이 더 많이 나왔습니다. 하지만 그 차이가 늘 같은 것은 아닙니다. 토크나이저가 바뀌자 2.02배가 1.40배로 줄었습니다. 따라서 「한국어는 영어보다 몇 배 비싸다」고 말하려면 어떤 모델과 토크나이저를 기준으로 했는지 함께 봐야 합니다.
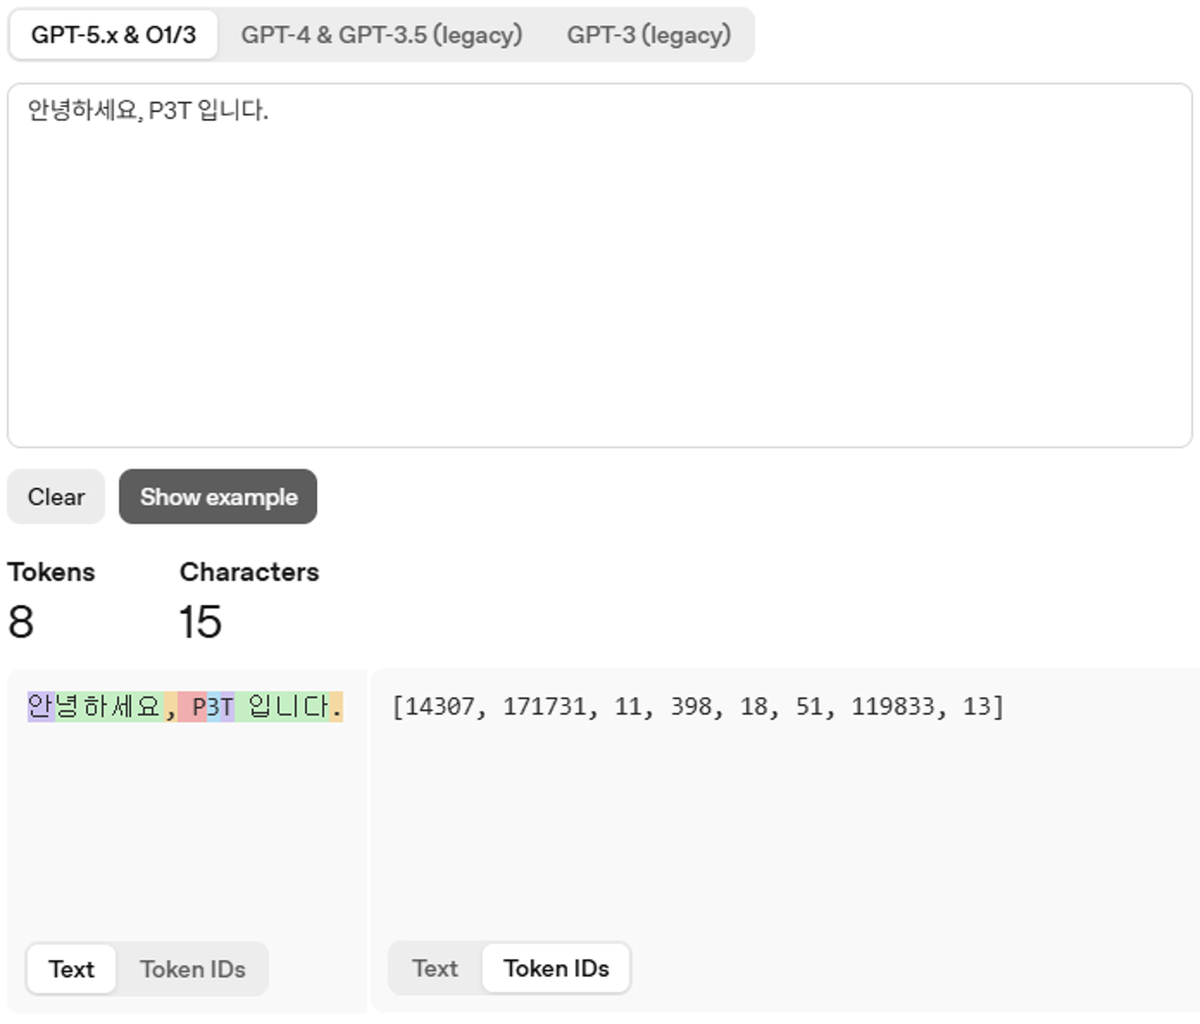
직접 확인하는 것이 가장 빠릅니다. 오픈AI 토크나이저 페이지에 문장을 넣으면 토큰마다 색이 칠해지고 글자 수와 토큰 수가 함께 표시됩니다.
「안녕하세요, P3T 입니다.」는 글자 15개지만 토큰은 8개입니다. 「안」에서 한 번 끊기고 「녕하세요」는 한 토큰이 됩니다. 영어와 숫자가 섞인 「P3T」도 P, 3, T로 나뉩니다. 로그인 없이 platform.openai.com/tokenizer 에서 확인할 수 있습니다.
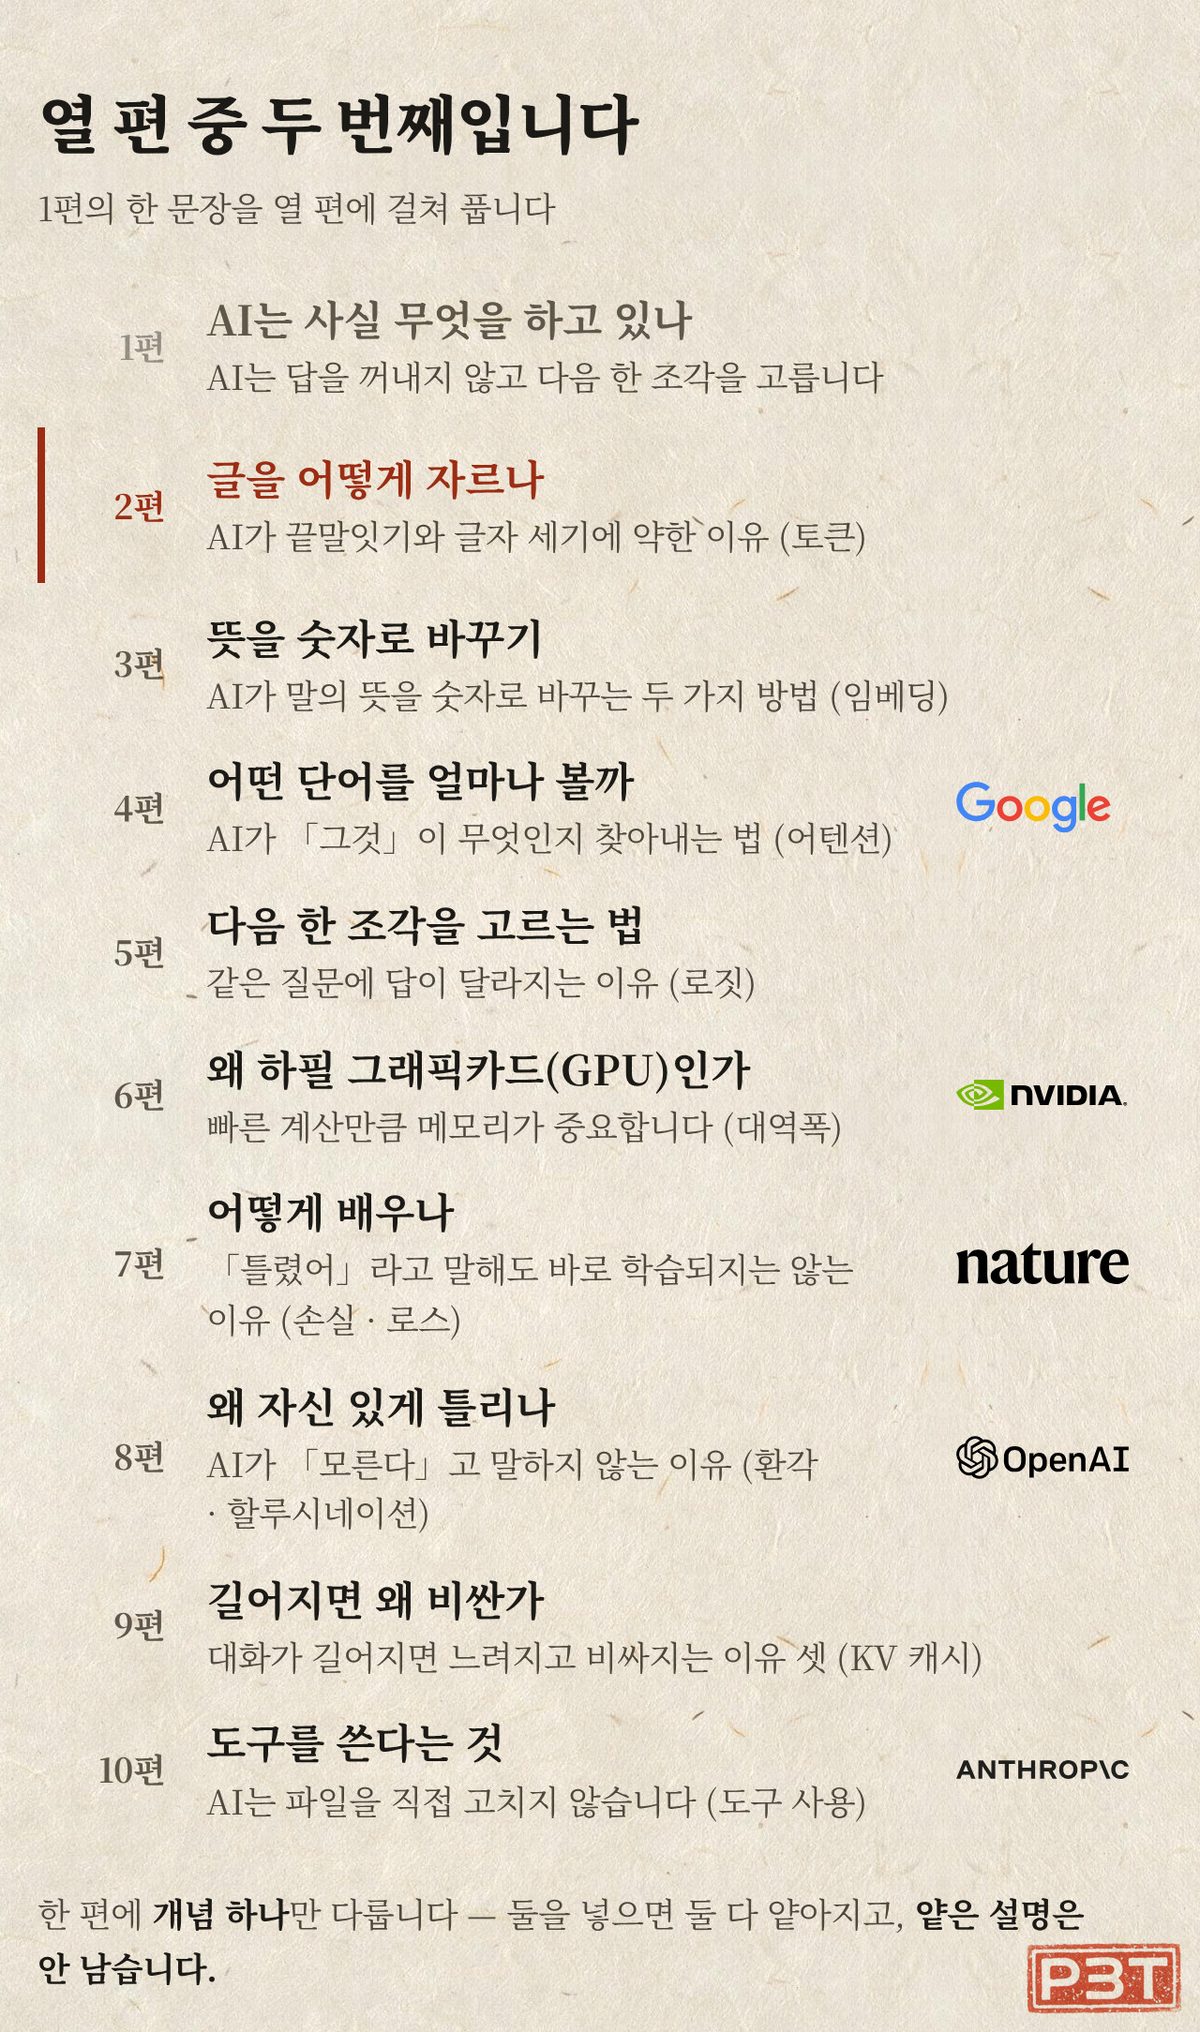
다음 편에서는 두 번째 단계를 살펴봅니다. 이렇게 자른 토큰을 AI가 계산할 수 있는 숫자로 바꾸는 과정입니다.
읽고 나서 해 볼 것
지금 쓰는 문서 한 문단을 오픈AI 토크나이저에 넣어 보세요. 같은 뜻의 한국어와 영어를 나란히 넣으면 토큰 수가 얼마나 다른지 바로 보입니다. 그 숫자를 보면 사용량과 비용을 줄일 때 무엇부터 덜어 내야 할지 알 수 있습니다.
출처
각주 5개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 앤트로픽 공식 용어집은 토큰을 언어 모델의 가장 작은 개별 단위라고 적으며, 단어·부분 단어·글자·바이트에 해당할 수 있다고 설명한다Tokens are the smallest individual units of a language model, and can correspond to words, subwords, characters, or even bytes (in the case of Unicode).https://platform.claude.com/docs/en/about-claude/glossary확인 2026-09-02↩
- 오픈AI 문서는 토큰을 자주 나타나는 문자열이라고 적는다Tokens represent commonly occurring sequences of characters.https://developers.openai.com/api/docs/concepts확인 2026-09-02↩
- 2015년 BPE 논문은 여러 종류의 단어가 단어보다 작은 단위로 번역될 수 있다고 적으며 이름·복합어·차용어를 예로 들었다various word classes are translatable via smaller units than words, for instance names (via character copying or transliteration), compounds (via compositional translation), and cognates and loanwords (via phonological and morphological transformations).https://arxiv.org/abs/1508.07909확인 2026-09-02↩
- 2025년 논문은 대규모 언어 모델이 글자 세기 같은 단순한 글자 단위 과제에서 계속 실패하는 근본 원인으로 토큰화를 지목한다Large Language Models (LLMs) consistently fail at simple character-level tasks, such as counting letters in words, due to a fundamental limitation: tokenization.https://arxiv.org/abs/2505.14172확인 2026-09-02↩
- 오픈AI 가격 문서는 토큰이 모델의 입력 요율과 출력 요율로 과금된다고 적는다Tokens are billed at the chosen model's input and output rates.https://developers.openai.com/api/docs/pricing확인 2026-09-02↩