 P3T
임베딩이란? 말의 뜻을 숫자로 바꿔 문서를 찾는 법
글을 숫자 묶음으로 바꾸면 비슷한 뜻이 가까운 자리에 놓입니다
- 무슨 일
- 「내 문서에서 찾아 줘」가 되는 자리가 임베딩입니다.
- 확인된 것
- 오픈AI·구글의 상위 임베딩 모델은 숫자 3,072개로 바꿉니다.
- 왜 중요한가
- 검색이 빗나가면 모델이 아니라 자른 조각을 봐야 합니다.
- 오늘 할 일
- AI 가 내 문서를 못 찾으면 질문에 문서 속 표현을 넣어 봅니다.
임베딩은 글을 숫자 묶음으로 바꾸고, 관련된 글을 숫자 공간에서 가깝게 찾도록 해 줍니다.
AI가 「사과」와 비슷한 단어를 찾게 하려면 먼저 글을 숫자로 바꿔야 합니다. 뜻이 비슷한 글은 숫자상으로 가까이 놓이도록 만드는 것입니다. 이 숫자 묶음을 임베딩(embedding)이라고 합니다. 임베딩은 여러 곳에서 쓰이지만, 여기서는 두 가지를 구분하겠습니다. 언어 모델 안에서는 토큰마다 임베딩이 붙습니다. 문서 검색에서는 문장이나 문단 전체를 하나의 임베딩으로 바꿉니다. 오늘 자세히 볼 것은 문서 검색용 임베딩입니다. 모델 안쪽은 다음 편에서 이어집니다.
글에 숫자 묶음이 붙습니다
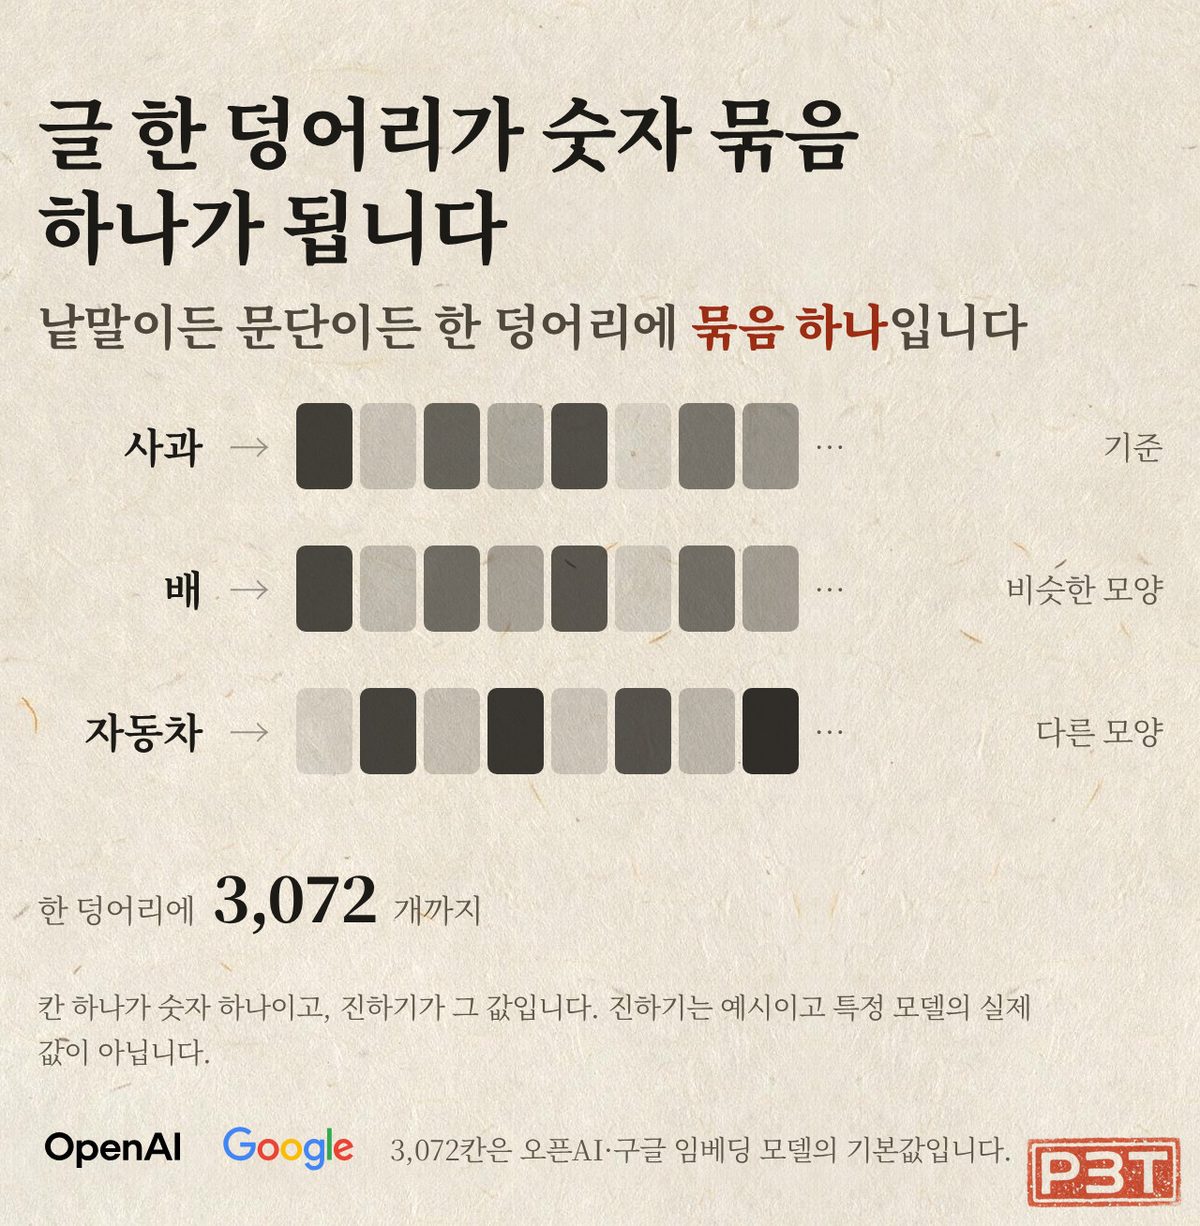
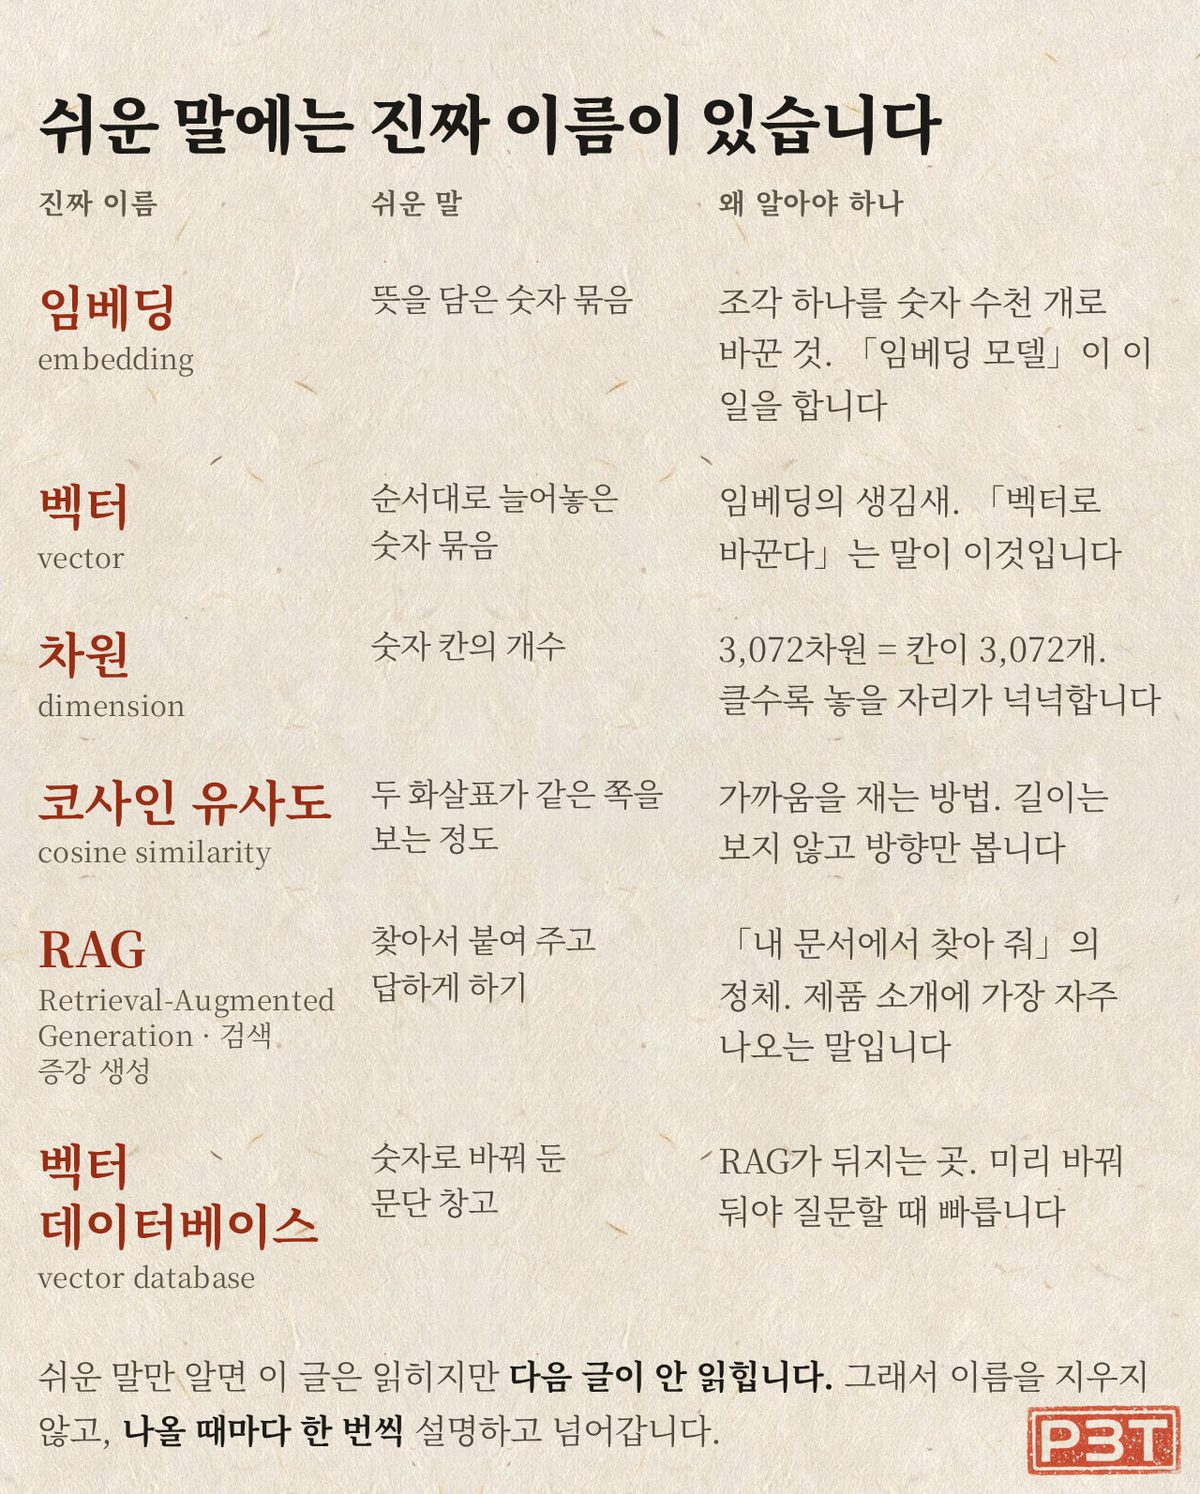
임베딩은 글의 특징을 계산할 수 있도록 문자를 숫자로 바꾼 숫자 묶음입니다. 이를 벡터(vector)라고도 합니다. 0.12, -0.87, 0.03처럼 숫자가 길게 이어진 형태입니다1.
숫자의 개수는 차원(dimension)이라고 부릅니다. 예를 들어, 오픈AI의 text-embedding-3-large와 구글의 gemini-embedding-001은 기본적으로 3,072개의 숫자로 이루어진 임베딩을 만듭니다2.
단어마다 3,072개가 붙는다는 뜻은 아닙니다. 문서 검색에서는 문장이나 문단 하나를 넣으면 그 전체를 나타내는 임베딩 하나가 나옵니다. 모델 내부에서 토큰마다 사용하는 임베딩과는 목적과 구조가 다르므로 구분해서 봐야 합니다.
왜 번호 하나로는 안 될까요
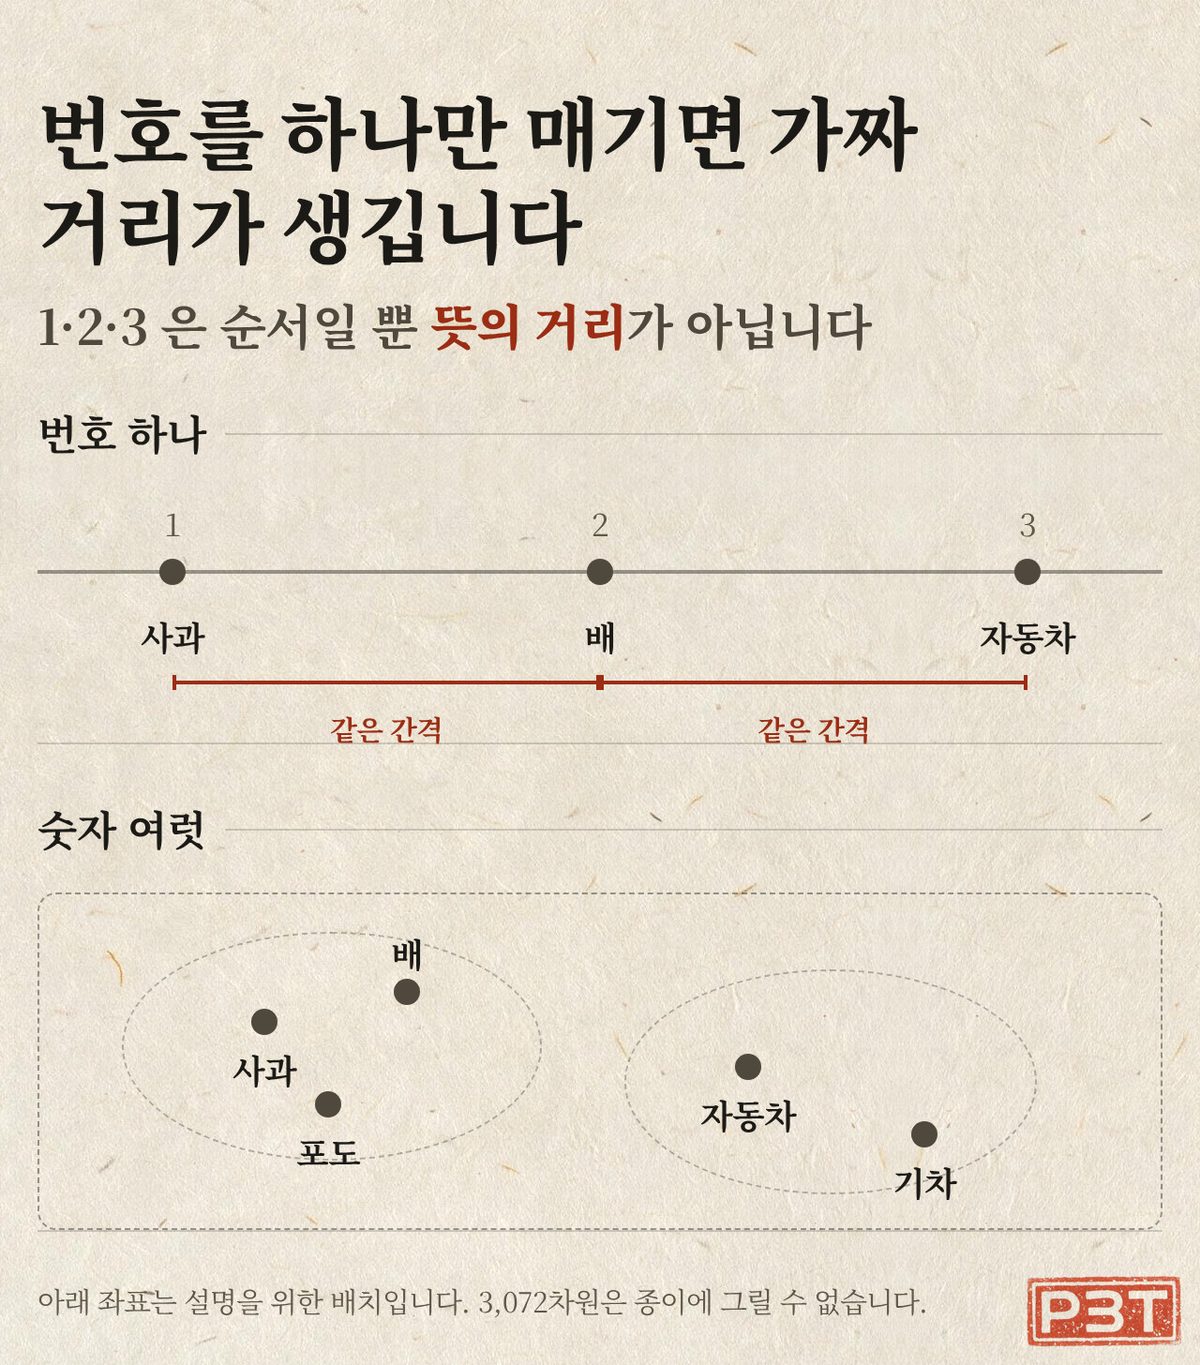
사과는 1번, 배는 2번, 자동차는 3번처럼 번호 하나만 붙일 수도 있습니다. 하지만 이 번호는 이름표일 뿐, 의미를 담지는 못합니다. 1과 2가 가깝다고 해서 사과와 배의 뜻이 가까운 것은 아닙니다.
숫자를 여러 개 쓰면 달라집니다. 글을 넓은 공간에 놓을 수 있게 되고, 그 공간 안에서 사과와 배는 가까이 두고 자동차는 멀리 배치하는 식입니다. 3,072차원이라는 말은 글 하나를 3,072개의 숫자로 표현한다는 뜻입니다.
중요한 것은 이 숫자들을 사람이 직접 정하지 않는다는 점입니다. 학습 자료와 학습 목표를 바탕으로 예문을 잔뜩 보면서 AI가 스스로 조정합니다. 같이 나오는 말끼리 가까워지고, 그렇지 않은 말끼리는 멀어집니다. 다만 각 숫자 하나하나가 색깔이나 맛처럼 하나의 뜻을 정확히 담당하는 것은 아닙니다.
뜻이 비슷하면 자리도 가깝습니다
검색용 임베딩은 관련 있는 글이 가까운 자리에 놓이도록 만들어집니다. 오픈AI는 두 임베딩을 비교할 때 코사인 유사도(cosine similarity)를 권합니다34. 두 벡터가 얼마나 같은 방향을 향하는지 재는 방법입니다. 길이는 보지 않고 방향만 봅니다.
단어 임베딩의 유명한 사례도 있습니다. 2013년 연구에서는 King에서 Man을 빼고 Woman을 더한 벡터가 Queen에 아주 가까워졌습니다5. 왕에서 남자를 빼고 여자를 더했더니 여왕 근처에 떨어졌다는 말입니다.
단, 조심할 데가 있습니다. 이 사례는 흔히 등식처럼 소개되는데, 원논문은 등식으로 적지 않았습니다. 아주 가까운 벡터가 나온다고 적었습니다. 정확히 Queen이 되는 것이 아니라 Queen 근처에 떨어진다는 이야기입니다. 뜻이 숫자로 옮겨 가되 딱 떨어지지는 않는다는 것을, 이 사례가 오히려 잘 보여 줍니다.
그래서 「내 문서에서 찾아 줘」가 됩니다
오픈AI는 임베딩의 대표적인 활용 사례로 검색·분류·추천을 제시합니다6. 모두 내용이나 특징이 비슷한 대상을 찾는 일입니다.
문서 검색에서는 먼저 긴 글을 작은 조각으로 나누고, 각 조각을 임베딩으로 바꿔 저장합니다. 질문이 들어오면 질문도 임베딩으로 바꾼 뒤, 숫자상으로 가까운 문서 조각을 찾습니다. AI는 이렇게 찾은 자료를 질문과 함께 받아 답을 만듭니다.
모델 밖의 자료를 검색해 답변에 활용하는 방식을 검색 증강 생성 RAG(Retrieval-Augmented Generation)라고 합니다. 모델이 학습할 때 몰랐던 정보나 최신 자료를 참고할 수 있다는 장점이 있습니다. 다만 검색한 자료가 정확해야 답변 품질도 좋아집니다. 구글도 관련 정보를 찾아 문맥에 넣으면 답변 품질을 높일 수 있다고 설명합니다7.
임베딩 검색은 RAG를 만드는 대표적인 방법이지만 유일한 방법은 아닙니다. 단어가 정확히 일치하는 문서 검색을 사용하거나 두 방식을 섞기도 합니다. 임베딩과 원문 정보를 저장하고 빠르게 찾는 저장소는 벡터 데이터베이스라고 부릅니다.
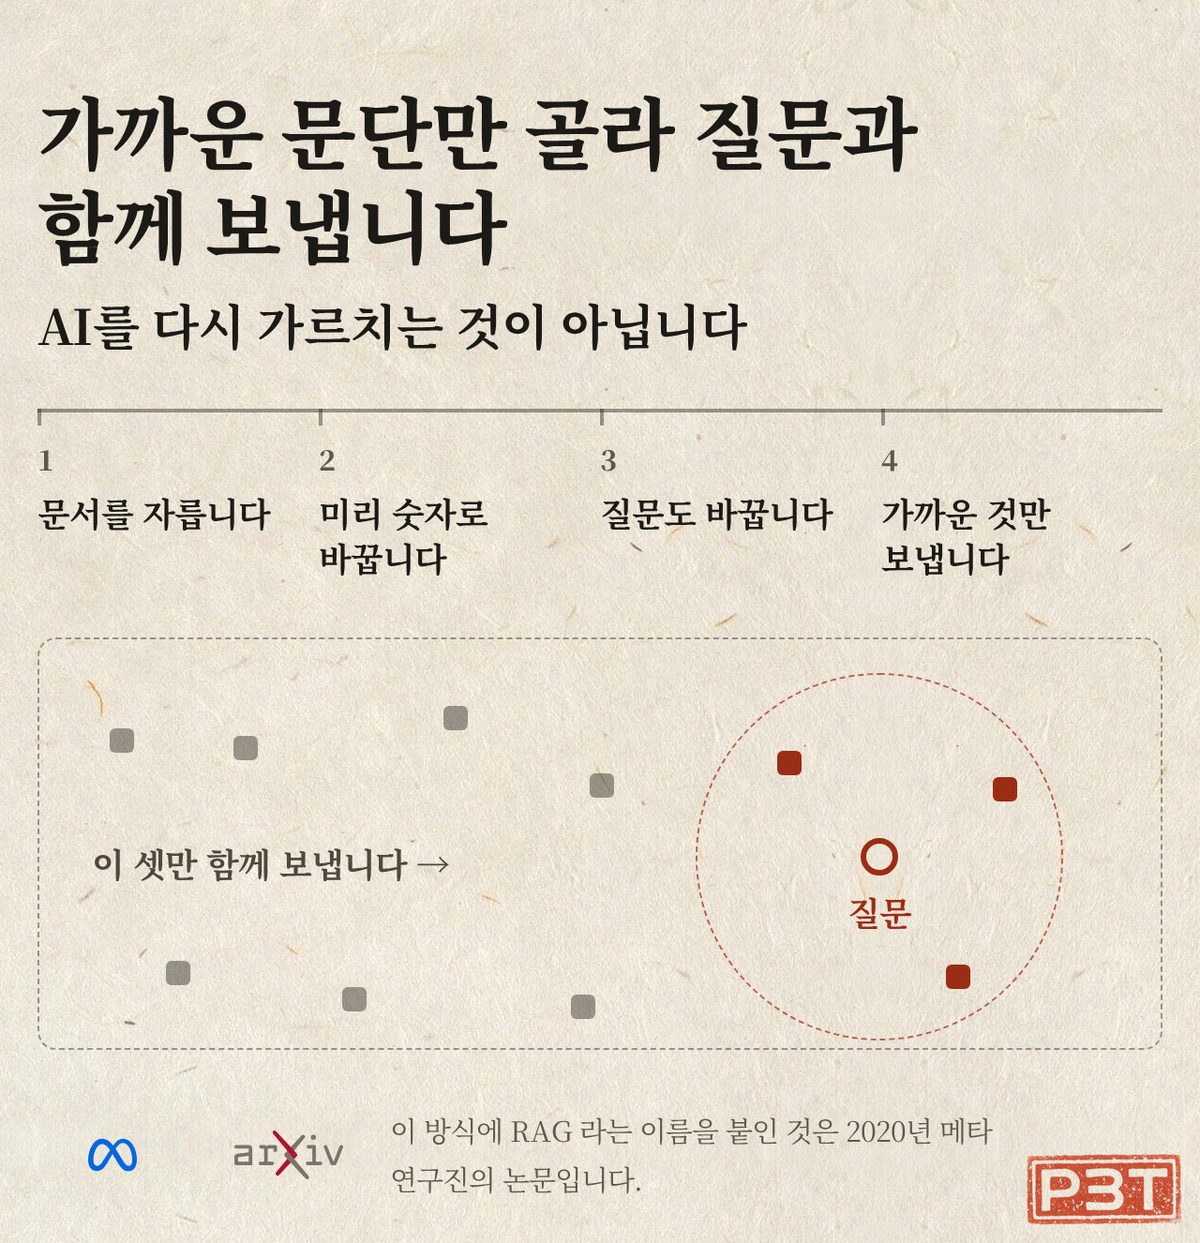
1편에서 AI의 기억을 학습된 값과 현재 작업대로 나눴습니다. 검색은 필요한 자료를 골라 현재 작업대에 올리는 일입니다. AI를 다시 학습시키는 것은 아닙니다.
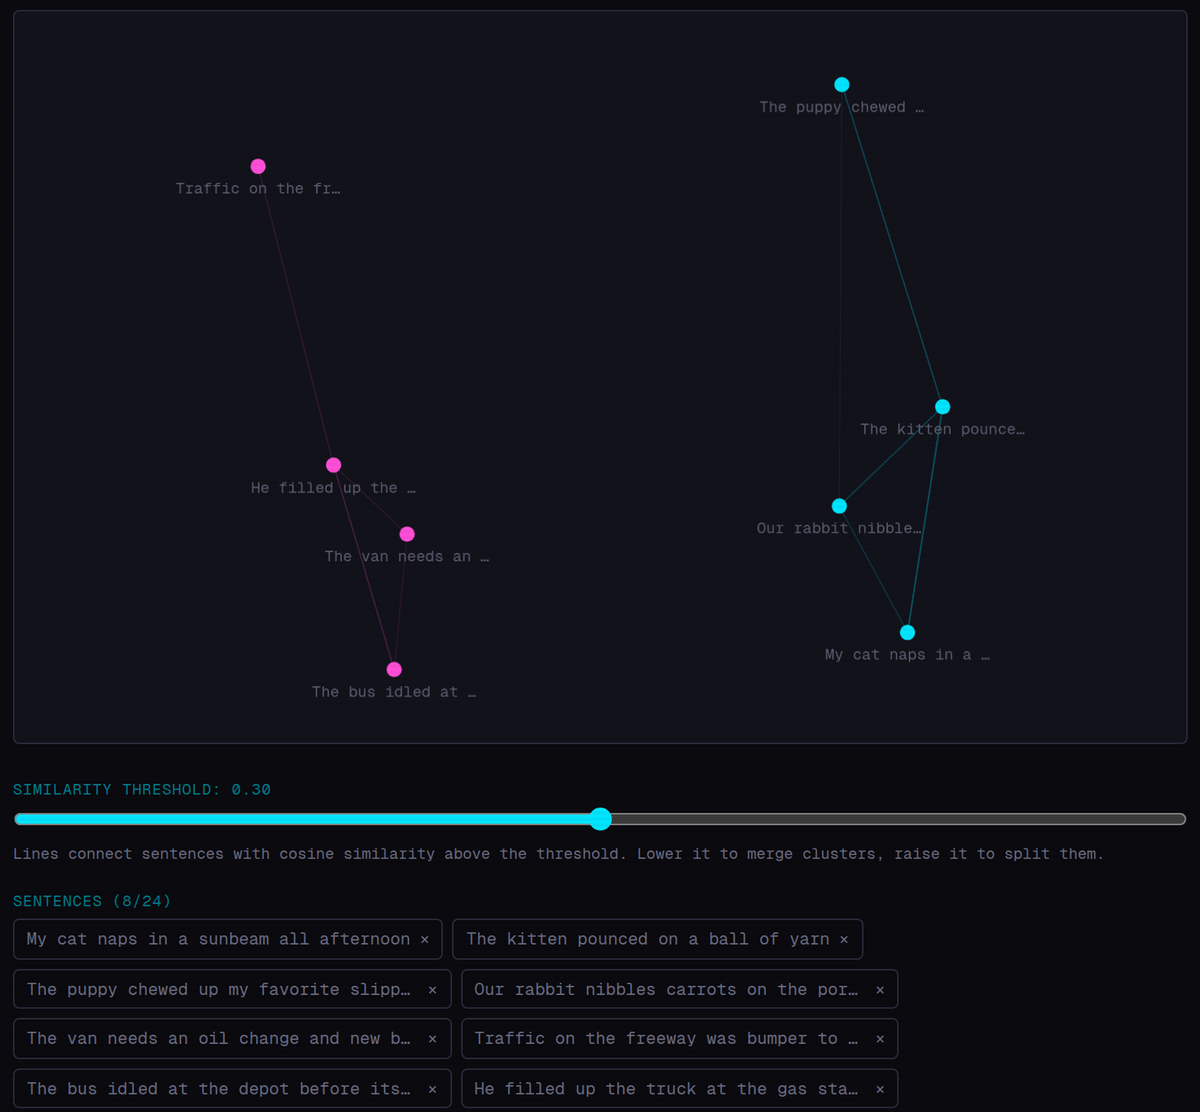
직접 보고 싶다면 Embedding Playground에 문장을 넣어 보세요. 고양이·강아지·토끼 문장과 버스·트럭·자동차 문장을 섞으면 비슷한 문장끼리 모입니다. 가입은 필요 없습니다.
adityabawankule.io/tools/embedding-playground
단어 임베딩을 3차원으로 돌려 보고 싶다면 구글의 Embedding Projector도 있습니다.
projector.tensorflow.org
이제 모델 안쪽의 임베딩이 남았습니다. 토큰마다 처음 붙는 숫자는 문맥을 보기 전의 출발점입니다. 하지만 「사과를 먹었다」와 「잘못을 사과했다」의 사과는 뜻이 다릅니다. 앞뒤 문맥을 봐야 둘을 구분할 수 있습니다.
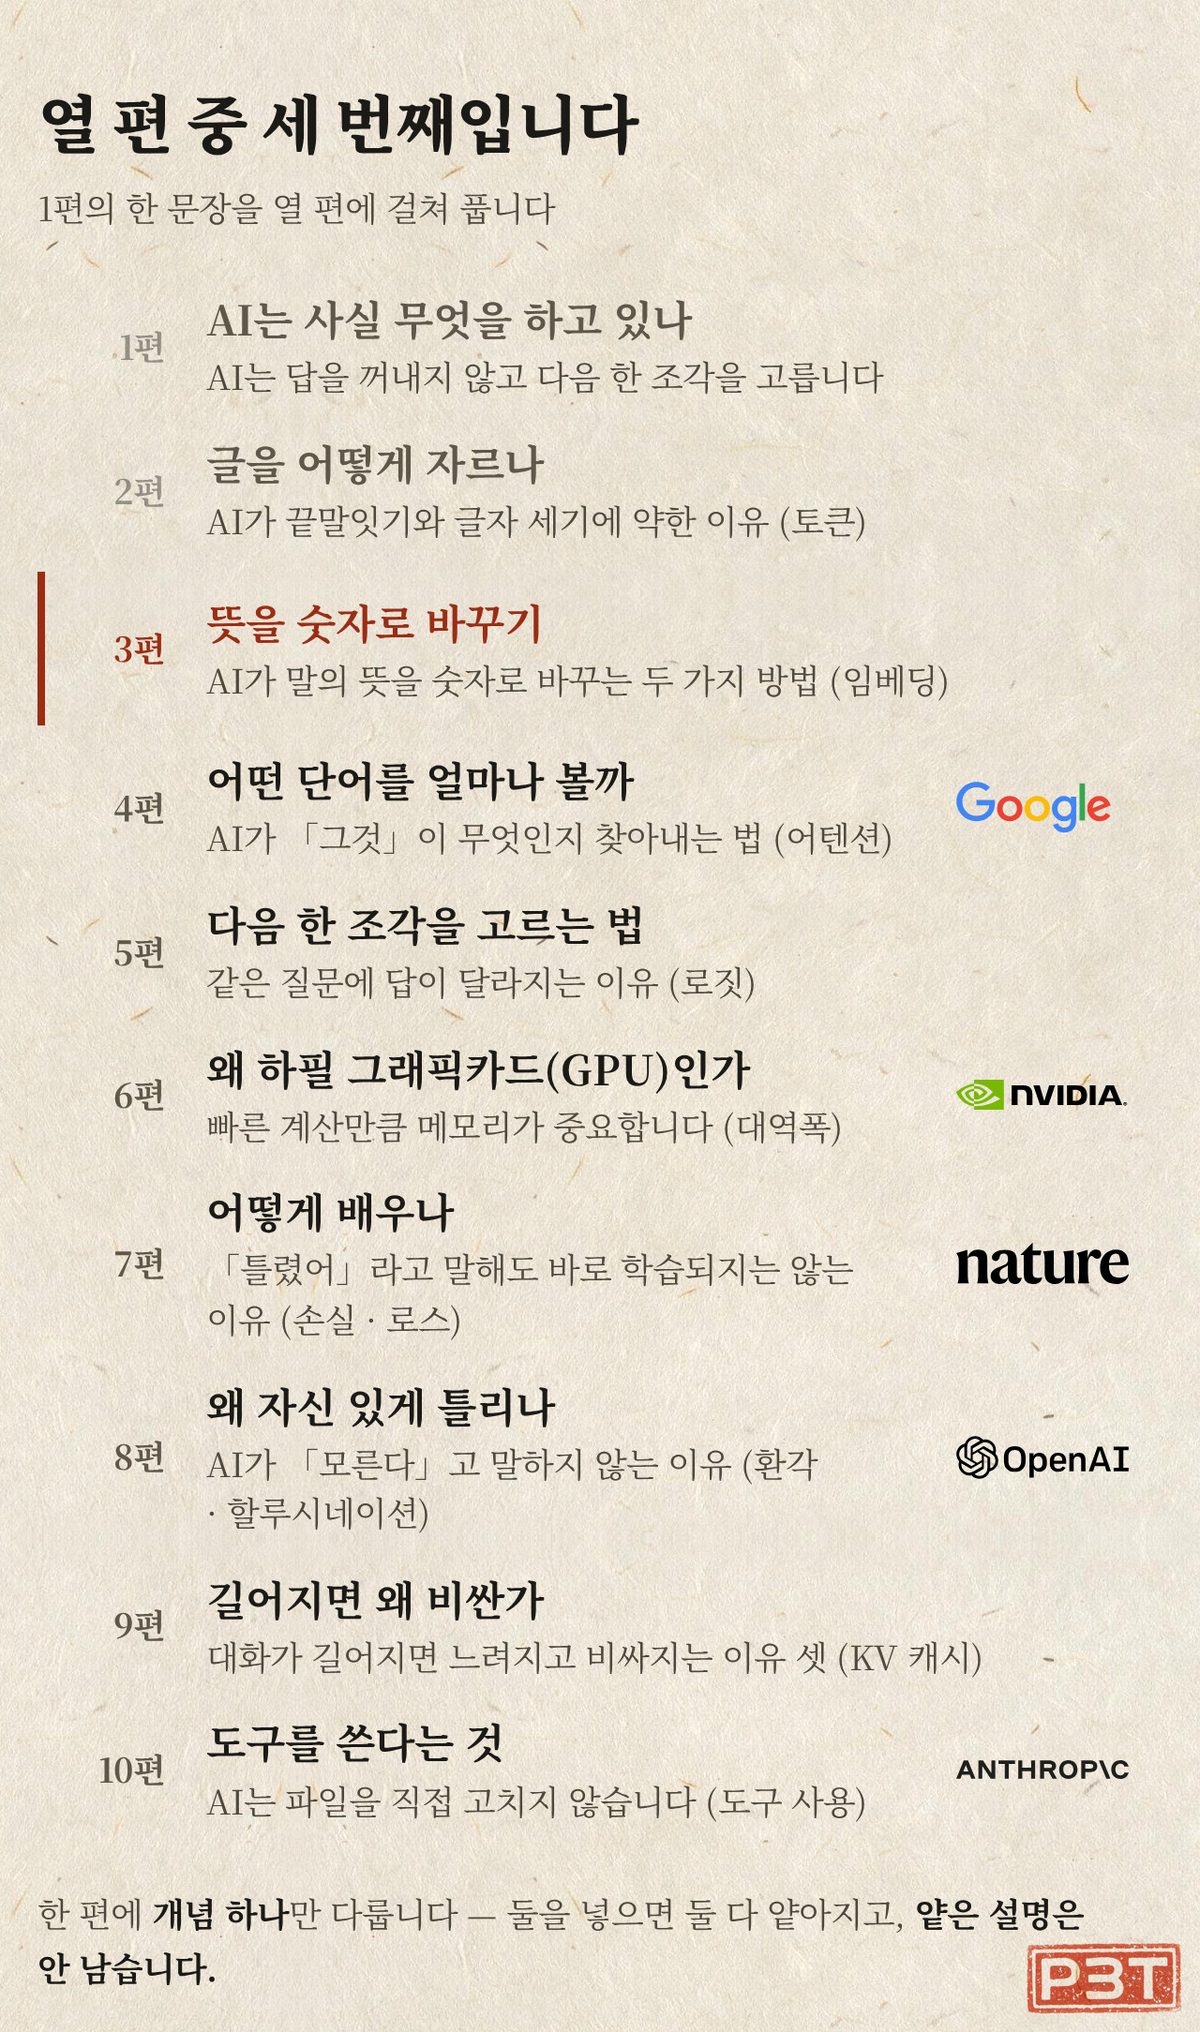
다음 편에서는 토큰들이 서로 무엇을 참고할지 계산하는 어텐션을 살펴봅니다. 같은 말의 숫자가 문맥에 따라 달라지는 과정도 여기서 시작됩니다.
읽고 나서 해 볼 것
문서 검색이 엉뚱한 대목을 가져온다면 질문의 표현과 핵심어를 바꿔 보세요. 질문이 달라지면 임베딩도 달라지고, 가까운 문단도 달라질 수 있습니다.
출처
각주 7개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 오픈AI 문서는 임베딩을 부동소수점 숫자의 벡터, 즉 목록이라고 정의한다An embedding is a vector (list) of floating point numbers.https://developers.openai.com/api/docs/guides/embeddings확인 2026-09-02↩
- 오픈AI와 구글의 상위 임베딩 모델은 기본으로 3,072개의 숫자를 낸다By default, the length of the embedding vector is 1536 for text-embedding-3-small or 3072 for text-embedding-3-large.https://developers.openai.com/api/docs/guides/embeddings확인 2026-09-02By default, both models output a 3072-dimensional embeddinghttps://ai.google.dev/gemini-api/docs/embeddings확인 2026-09-02↩
- 오픈AI 문서는 거리가 짧으면 관련성이 높고 거리가 멀면 관련성이 낮다고 적는다Small distances suggest high relatedness and large distances suggest low relatedness.https://developers.openai.com/api/docs/guides/embeddings확인 2026-09-02↩
- 오픈AI 문서는 거리 측정에 코사인 유사도를 권한다We recommend cosine similarity.https://developers.openai.com/api/docs/guides/embeddings확인 2026-09-02↩
- 2013년 논문은 남성과 여성의 관계가 저절로 학습되며 King에서 Man을 빼고 Woman을 더하면 Queen과 아주 가까운 벡터가 나온다고 적었다the male/female relationship is automatically learned, and with the induced vector representations, "King - Man + Woman" results in a vector very close to "Queen."https://aclanthology.org/N13-1090.pdf확인 2026-09-02↩
- 오픈AI 문서는 임베딩의 용도로 검색과 군집과 추천을 든다Embeddings are commonly used for: Search (where results are ranked by relevance to a query string), Clustering (where text strings are grouped by similarity), Recommendations (where items with related text strings are recommended)https://developers.openai.com/api/docs/guides/embeddings확인 2026-09-02↩
- 구글 문서는 관련 정보를 찾아 모델의 문맥에 넣어 주면 생성되는 글의 품질이 좋아진다고 설명한다Embeddings enhance the quality of generated text by retrieving and incorporating relevant information into the context of a model.https://ai.google.dev/gemini-api/docs/embeddings확인 2026-09-02↩