 P3T
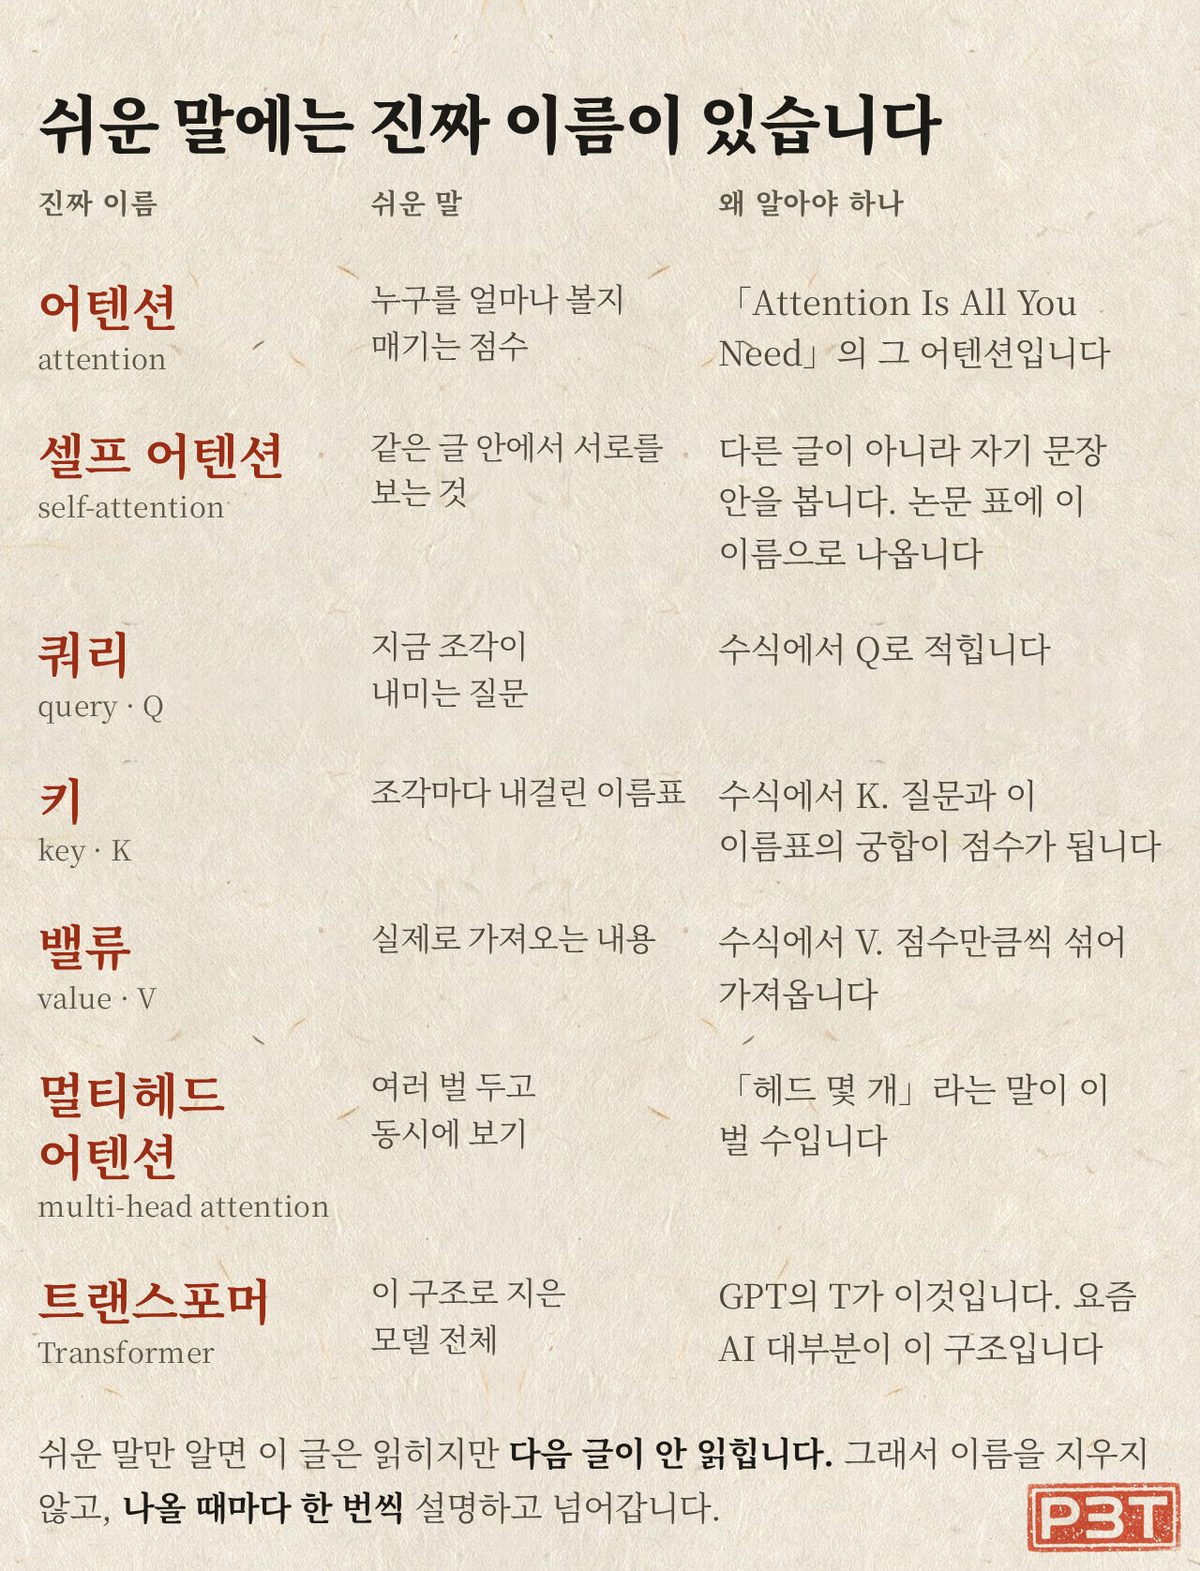
어텐션이란? AI가 「그것」이 무엇인지 찾아내는 계산
질문·이름표·내용 셋으로 나눠 무엇을 얼마나 참고할지 숫자로 냅니다
- 무슨 일
- 단어 하나를 바꾸면 「그것」이 가리키는 대상이 달라집니다.
- 확인된 것
- 질문과 이름표가 잘 맞는 쪽의 내용을 더 많이 가져옵니다.
- 왜 중요한가
- 어텐션 그림을 판단 근거로 읽으면 없는 이유를 읽게 됩니다.
- 오늘 할 일
- 어텐션 시각화는 참고 정도로만 봅니다.
어텐션은 지금 처리하는 토큰이 다른 토큰을 얼마나 참고할지 숫자로 계산하는 장치입니다.
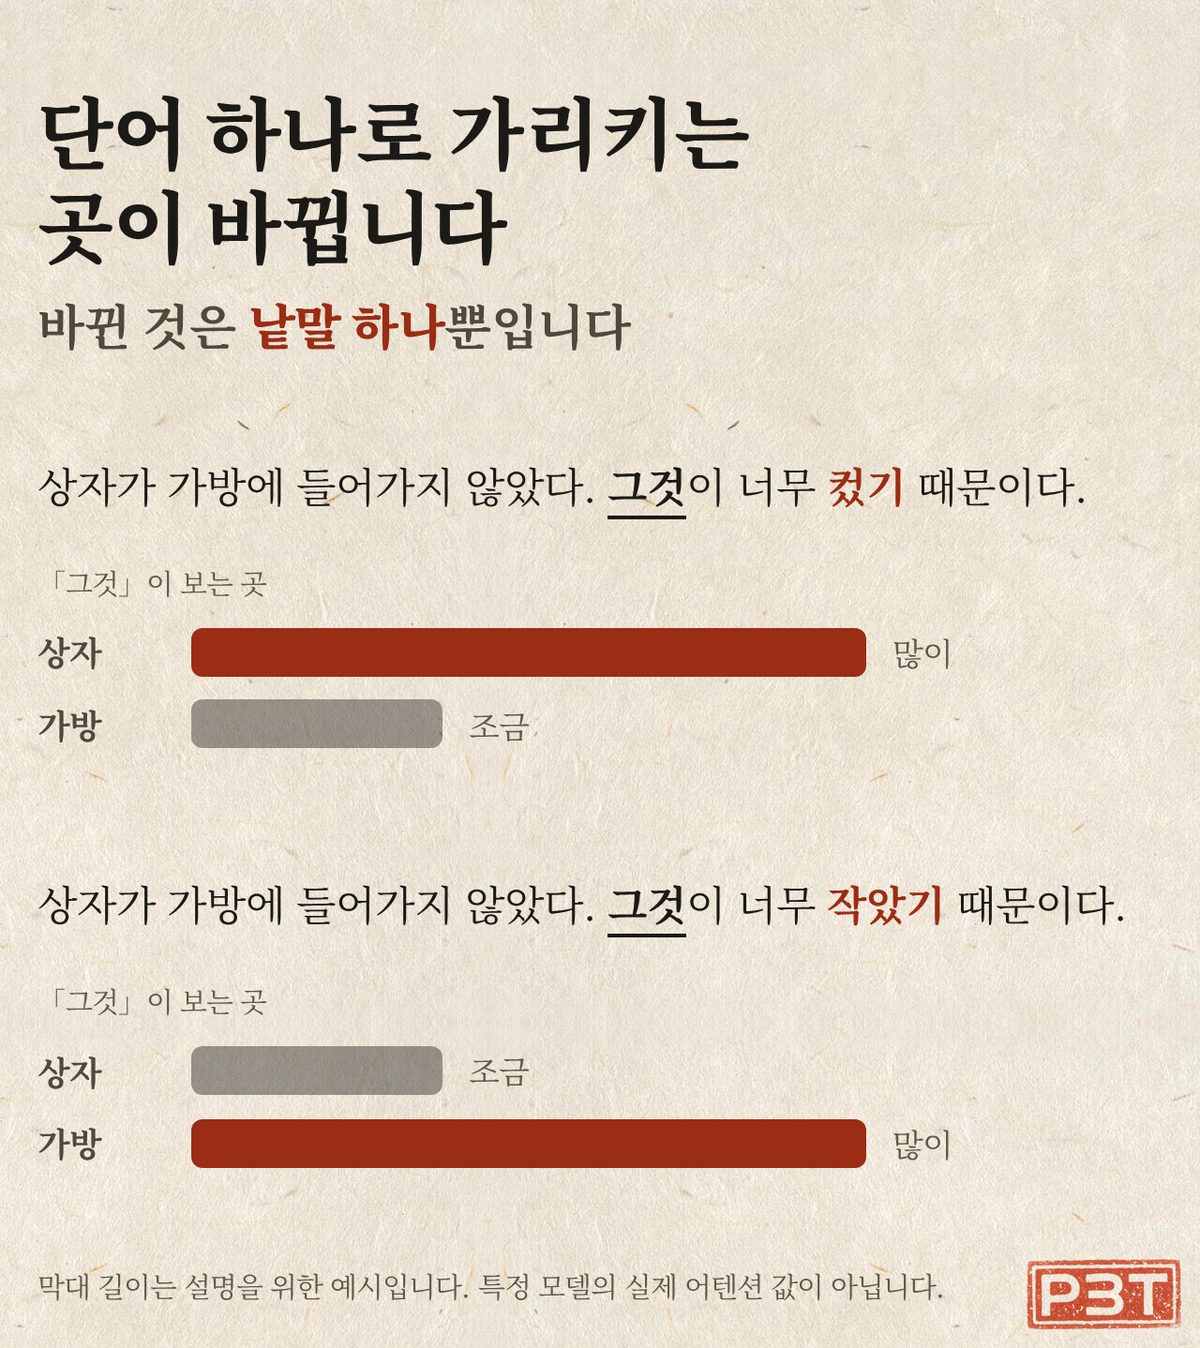
문장 하나를 보겠습니다. 「상자가 가방에 들어가지 않았다. 그것이 너무 컸기 때문이다.」 여기서 「그것」은 상자입니다. 하지만 「그것이 너무 작았기 때문이다」로 바꾸면 가방을 가리킵니다. 단어 하나가 달라지자 문장의 관계도 달라졌습니다. AI가 이런 관계를 파악할 때 사용하는 핵심 계산이 어텐션(attention)입니다.
무엇을 얼마나 참고할지 숫자로 계산합니다
어텐션은 지금 처리하는 토큰이 다른 토큰을 얼마나 참고할지 숫자로 계산하는 방식입니다.
트랜스포머 이전에는 글을 앞에서부터 차례대로 읽으며 정보를 이어 가는 방식이 널리 쓰였습니다. 이 방식은 글이 길어질수록 멀리 떨어진 정보를 연결하기 어려웠습니다.
어텐션은 현재 볼 수 있는 토큰을 한꺼번에 펼쳐 놓고 비교해 각각에 참고 점수를 매깁니다. 「그것」을 처리할 때 상자에 0.6, 가방에 0.3, 나머지에 0.1을 주는 식입니다. 이 숫자는 원리를 설명하기 위한 예시이며, 실제 점수는 문맥과 모델의 각 층에서 다르게 계산됩니다.
질문, 이름표, 내용 세 가지로 나눕니다
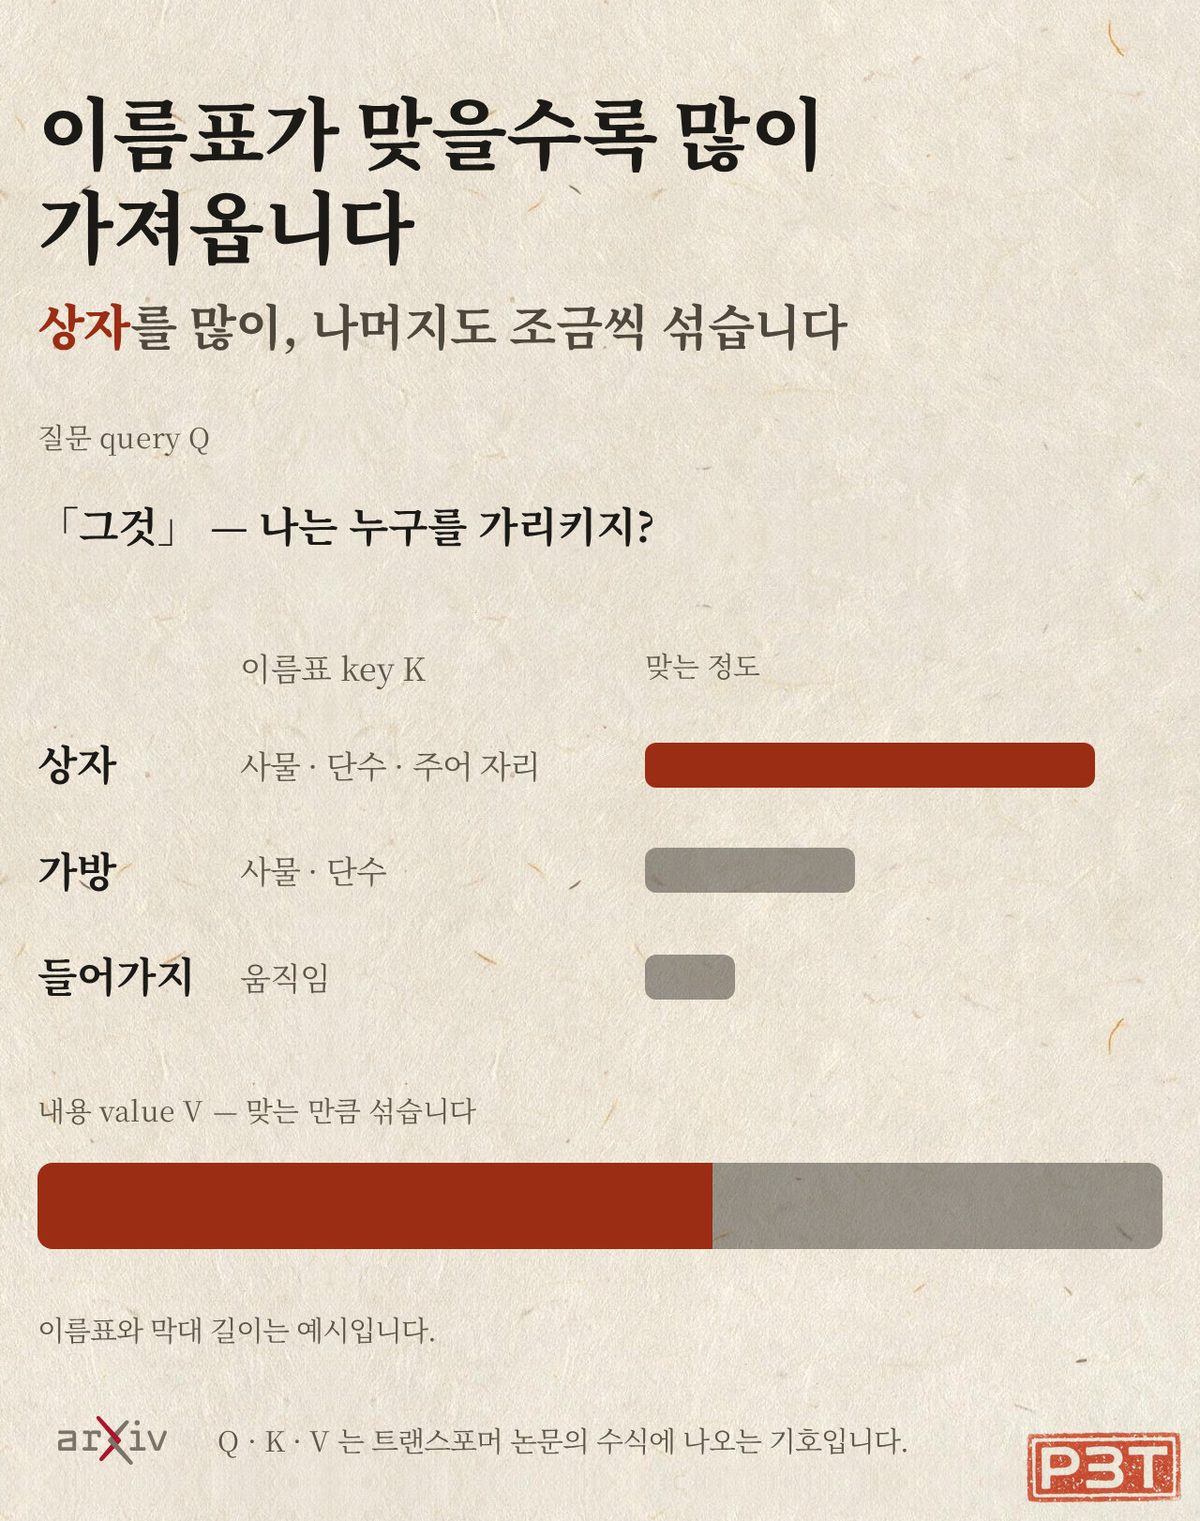
그 어텐션 점수는 어떻게 정할까요? 트랜스포머는 각 토큰에서 세 가지 숫자 묶음을 만듭니다. 쿼리(query)·키(key)·밸류(value)입니다1. 쉽게 비유하면 질문·이름표·내용입니다.
지금 처리하는 토큰의 쿼리(Q≒질문)는 다른 토큰의 키(K≒이름표)와 비교됩니다. 「그것」이 "나는 무엇과 관련이 있지?"라고 묻고, 위 문장에서 '상자'와 '가방'이 각자의 이름표를 보여 주는 셈입니다. 질문과 이름표가 잘 맞을수록 그 토큰의 내용을 더 많이 가져옵니다.
가져오는 양은 토큰마다 다릅니다. 관련이 큰 내용은 많이, 작은 내용은 조금씩 가져와 하나로 합칩니다. 이를 가중합이라고 합니다. 우유는 많이, 시럽은 조금 넣어 섞는 것과 비슷합니다2.
이 계산 과정은 모든 토큰과 여러 층에서 반복됩니다. 그만큼 수많은 곱셈과 덧셈이 필요합니다. 어떤 장치가 이 계산에 잘 맞는지는 6편에서 살펴보겠습니다.
한 번만 보지 않고 여러 갈래로 봅니다
문장을 이해하려면 여러 관계를 함께 살펴야 합니다. 누가 행동했는지, 어느 말이 어느 말을 꾸미는지, 「그것」이 무엇을 가리키는지 등을 봐야 합니다.
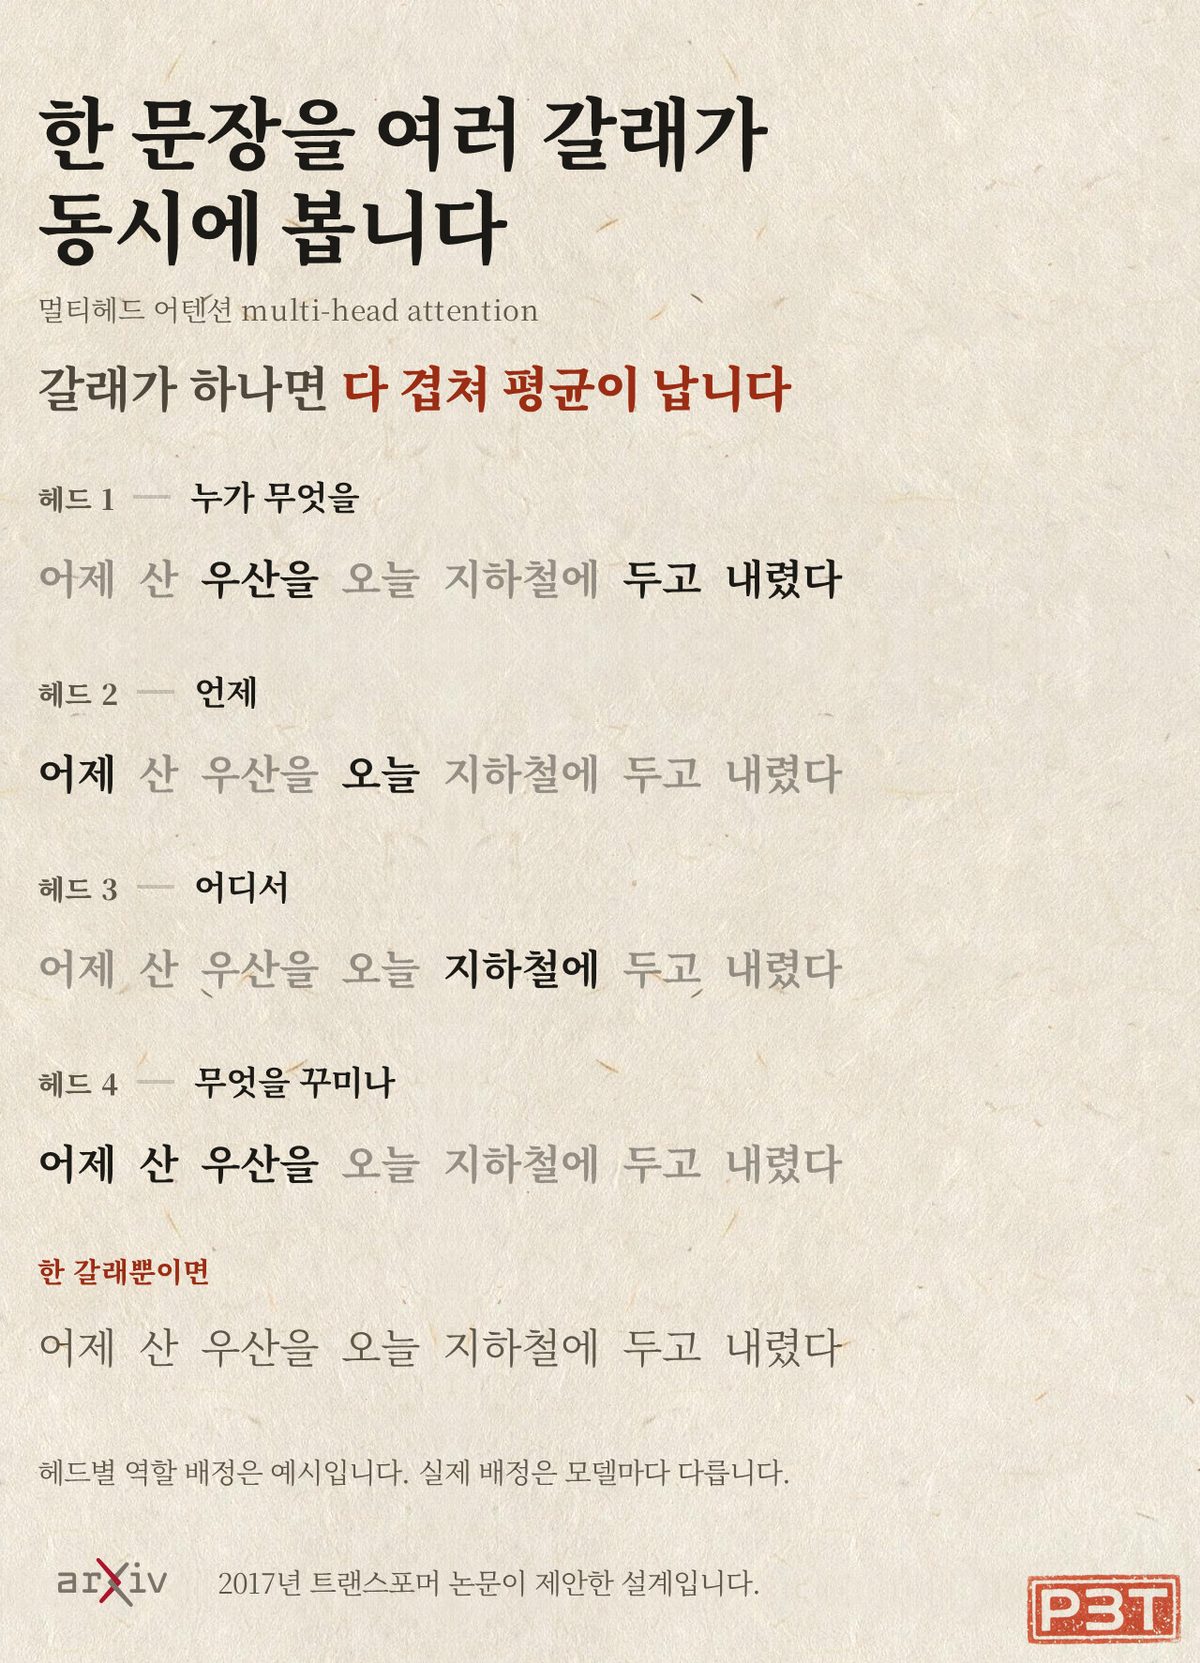
그래서 트랜스포머는 어텐션을 여러 갈래로 나누어 계산합니다. 이를 멀티헤드 어텐션(multi-head attention)이라고 합니다. 각 헤드는 서로 다른 방식으로 토큰의 위치와 관계를 살펴볼 수 있습니다3.
여러 사람이 같은 문장을 함께 보면서 각자 눈에 띄는 관계를 찾는 것과 비슷합니다. 다만 "첫 번째 헤드는 문법, 두 번째 헤드는 명사"처럼 역할이 미리 정해져 있는 것은 아닙니다. 학습 과정에서 서로 다른 관계에 반응하는 경향이 생깁니다.
2017년 논문의 기본 트랜스포머는 토큰 하나를 512개의 숫자로 표현하고, 이를 8개의 어텐션 헤드로 나누어 처리했습니다4. 지금은 모델마다 크기와 헤드 구성, 계산 방식이 크게 다릅니다.
논문이 공개한 시각화에서는 일부 헤드가 문장의 구문이나 의미 관계에 반응하는 모습도 나타났습니다5. 하지만 모든 헤드의 역할을 사람이 분명하게 해석할 수 있다는 것은 아닙니다.
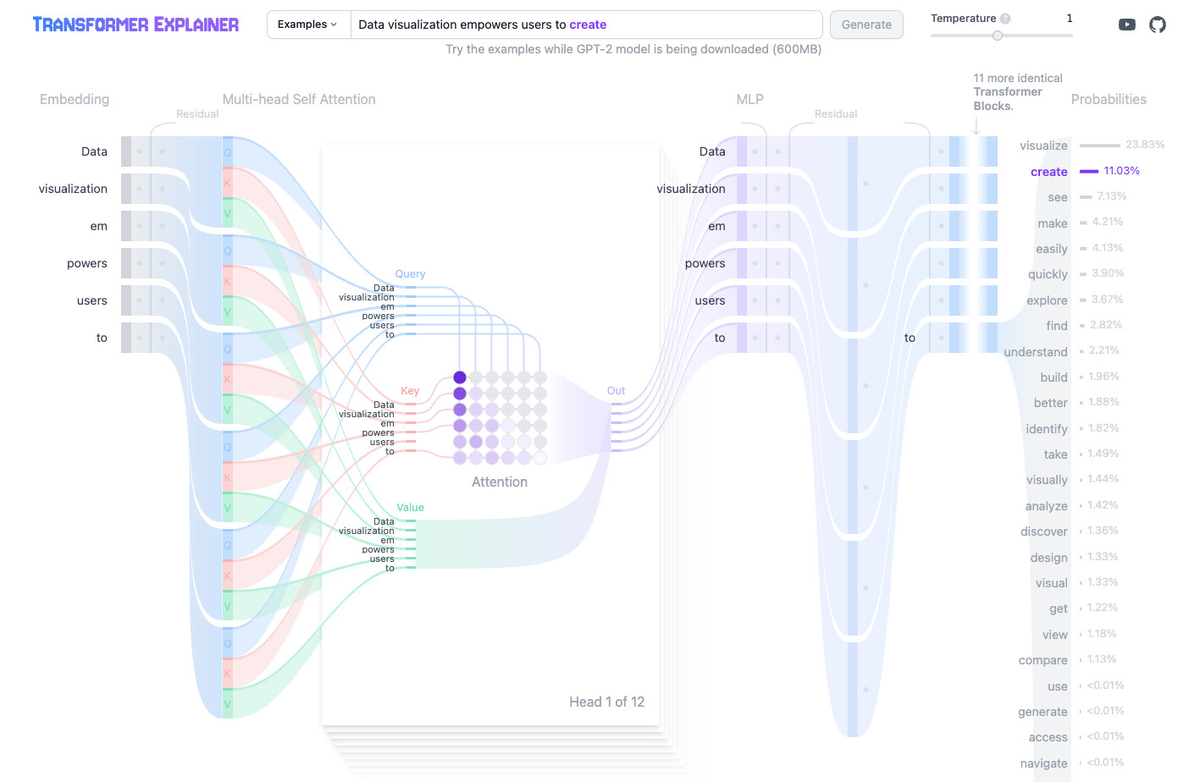
직접 보고 싶다면 조지아공대의 Transformer Explainer를 이용할 수 있습니다. 문장이 토큰과 숫자로 바뀌고, 쿼리·키·밸류를 거쳐 다음 토큰의 확률이 나오는 과정을 한 화면에 보여 줍니다.
poloclub.github.io/transformer-explainer
여기서 사용하는 모델은 2019년에 공개된 작은 GPT-2입니다. 원리를 이해하기 위한 도구이며, 최신 AI의 실제 크기를 보여 주는 것은 아닙니다.
어텐션 그림이 곧 AI의 생각은 아닙니다
어텐션 점수는 선의 굵기나 색으로 그릴 수 있습니다. 어떤 토큰이 다른 토큰을 얼마나 참고했는지 보여 주는 그림입니다. 하지만 이를 AI의 생각이나 판단 근거로 그대로 읽어서는 안 됩니다.
2019년 연구는 어텐션 점수만으로 모델의 판단 이유를 충분히 설명하기 어렵다고 지적했습니다6. 이에 대한 반론도 있어 완전히 끝난 논쟁은 아닙니다. 다만 어텐션 그림 하나만 보고 "AI가 이렇게 생각했다"고 단정할 수는 없습니다.
그렇다면 토큰을 한꺼번에 처리하면서 순서는 어떻게 알까요?
트랜스포머는 각 토큰에 위치 정보를 함께 제공합니다. 토큰 임베딩이 그 토큰이 무엇인지를 담는다면, 위치 정보는 그 토큰이 어디에 있는지를 알려 줍니다. 덕분에 「나는 너를 때렸다」와 「너는 나를 때렸다」를 다른 문장으로 구분할 수 있습니다.
토큰은 여러 층을 지나며 다른 토큰의 정보를 받아 계속 달라집니다. 마지막에는 이 정보가 다음에 올 토큰들의 점수로 바뀝니다. 그 점수를 확률로 바꾸고 하나를 고르는 과정은 다음 편에서 살펴보겠습니다.
어텐션 연결을 더 자세히 보고 싶다면 BertViz도 이용할 수 있습니다. 헤드마다 어느 토큰이 어느 토큰을 참고했는지 선으로 보여 줍니다.
github.com/jessevig/bertviz
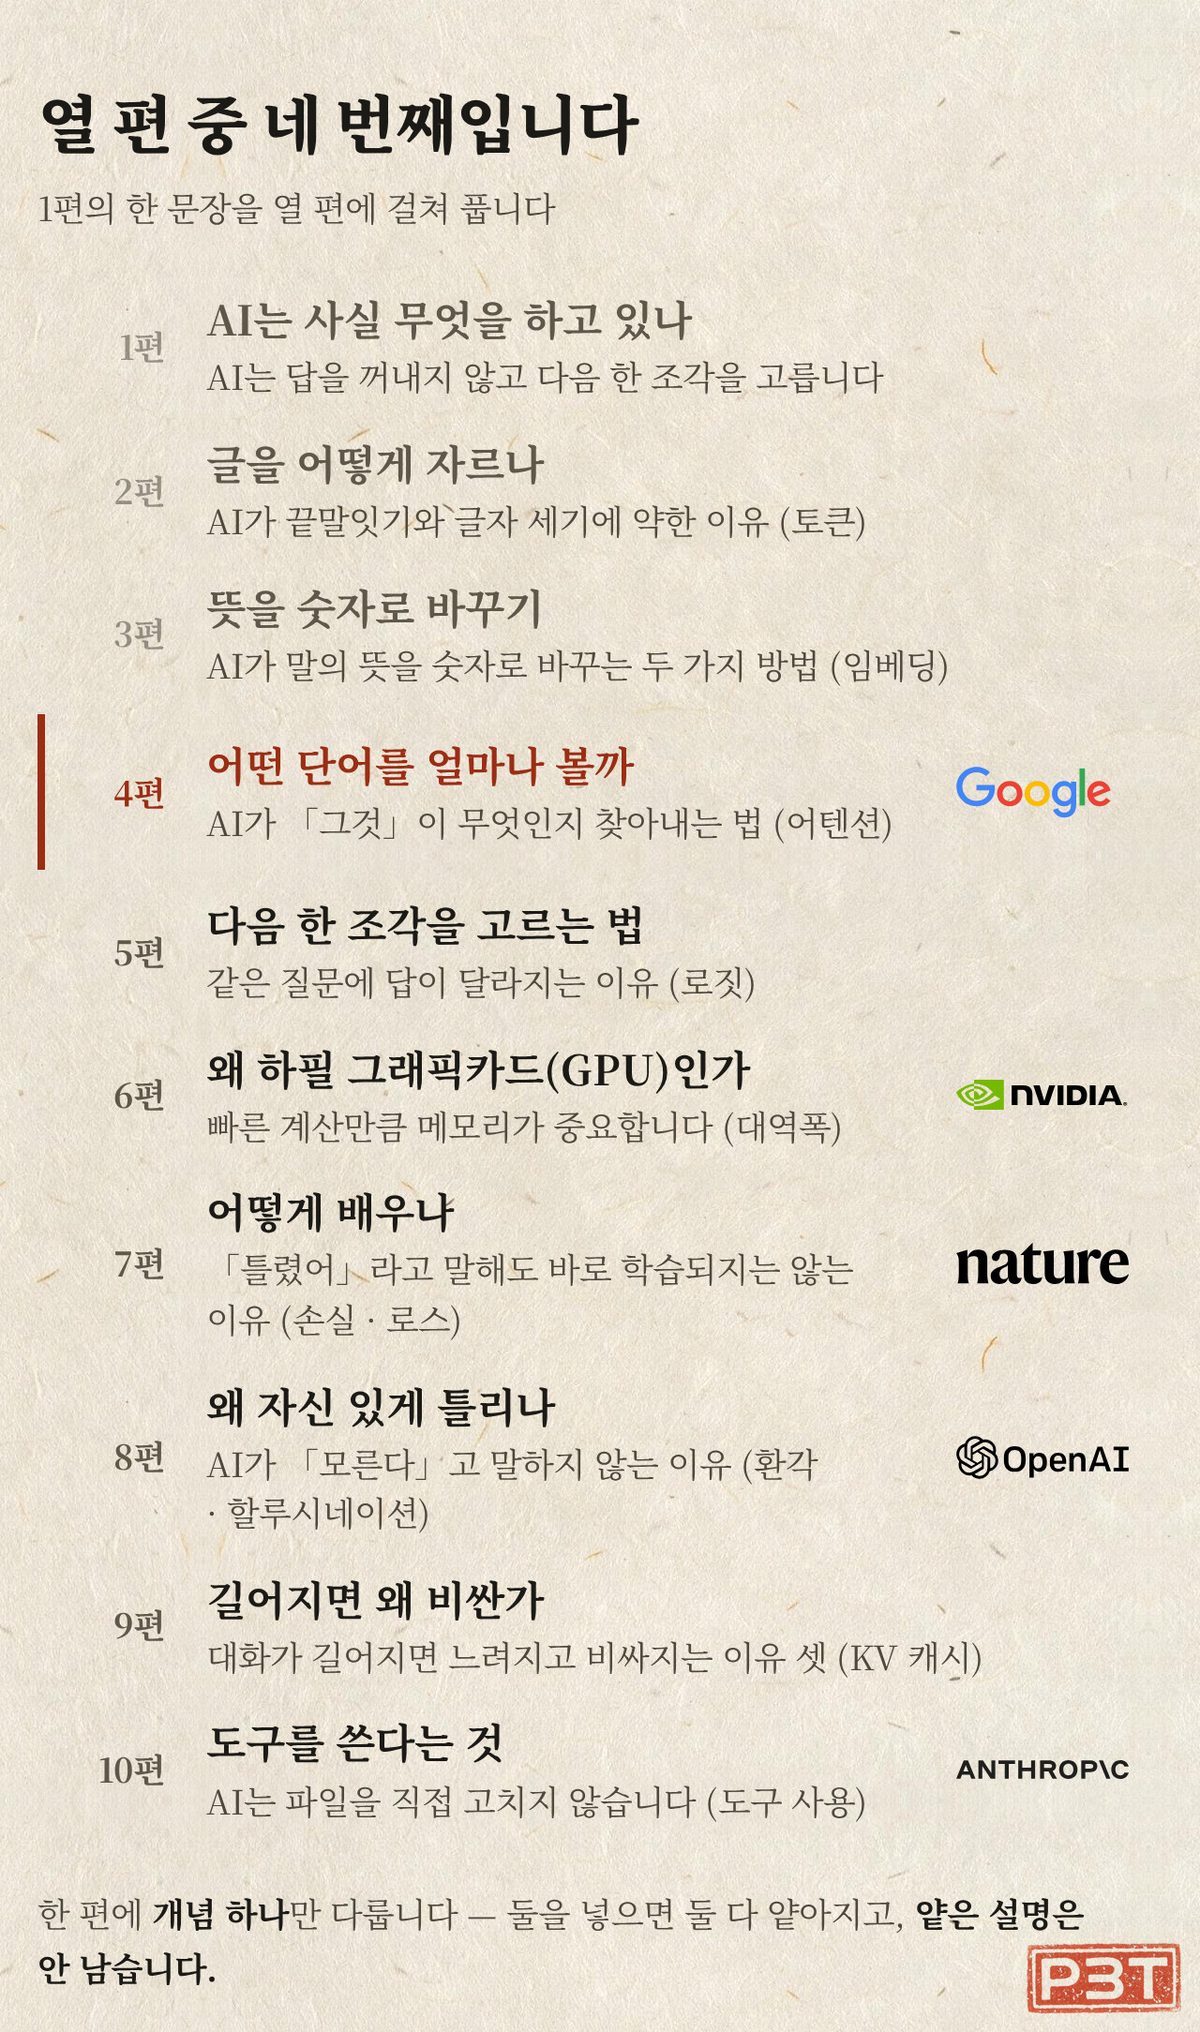
다음 편은 네 번째 단계입니다. 이렇게 모은 정보로 다음 토큰을 고르는 방법을 살펴봅니다.
읽고 나서 해 볼 것
긴 자료를 AI에 넣을 때 「위에서 말한 그것」 같은 표현을 정확한 이름으로 바꿔 보세요. 중요한 정보와 질문을 가까이 두고 대상을 분명하게 적으면 AI가 관계를 찾는 데 도움이 됩니다.
출처
각주 6개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 2017년 논문은 어텐션을 하나의 질의와 키·값 쌍들의 묶음을 출력으로 대응시키는 함수로 정의하며 질의·키·값·출력이 모두 벡터라고 적는다An attention function can be described as mapping a query and a set of key-value pairs to an output, where the query, keys, values, and output are all vectors.https://arxiv.org/pdf/1706.03762확인 2026-09-02↩
- 같은 논문은 출력이 값들의 가중합이며 각 값의 가중치가 질의와 대응하는 키의 궁합 함수로 계산된다고 적는다The output is computed as a weighted sum of the values, where the weight assigned to each value is computed by a compatibility function of the query with the corresponding key.https://arxiv.org/pdf/1706.03762확인 2026-09-02↩
- 같은 논문은 멀티헤드 어텐션이 서로 다른 위치의 서로 다른 표현 부분공간 정보를 동시에 살피게 하며 헤드가 하나면 평균화가 이를 방해한다고 적는다Multi-head attention allows the model to jointly attend to information from different representation subspaces at different positions. With a single attention head, averaging inhibits this.https://arxiv.org/pdf/1706.03762확인 2026-09-02↩
- 「Attention Is All You Need」의 기본 모델은 어텐션 헤드 8개와 512 길이의 숫자 묶음을 썼다In this work we employ h = 8 parallel attention layers, or heads. For each of these we use dk = dv = dmodel/h = 64.https://arxiv.org/pdf/1706.03762확인 2026-09-02hparams.hidden_size = 512https://github.com/tensorflow/tensor2tensor/blob/master/tensor2tensor/models/transformer.py확인 2026-09-02↩
- 같은 논문은 개별 어텐션 헤드가 서로 다른 일을 하도록 학습하며 상당수가 문장의 구문·의미 구조와 관련된 행동을 보인다고 적었다Not only do individual attention heads clearly learn to perform different tasks, many appear to exhibit behavior related to the syntactic and semantic structure of the sentences.https://arxiv.org/pdf/1706.03762확인 2026-09-02↩
- 2019년 연구는 표준 어텐션 모듈이 의미 있는 설명을 제공하지 않으며 그런 것처럼 취급되어서는 안 된다고 적었다Our findings show that standard attention modules do not provide meaningful explanations and should not be treated as though they do.https://arxiv.org/abs/1902.10186확인 2026-09-02↩