 P3T
챗GPT 답이 매번 다른 이유, 확률로 뽑기 때문입니다
AI 는 후보마다 점수를 매겨 하나를 뽑습니다 — 그 점수는 사실 여부가 아닙니다
- 무슨 일
- 같은 질문을 두 번 해도 답이 조금씩 달라집니다.
- 확인된 것
- 모델은 후보 확률에서 하나를 뽑습니다. 표에 참·거짓 칸은 없습니다.
- 왜 중요한가
- 확신에 찬 말투가 사실을 확인했다는 뜻이 아닙니다.
- 오늘 할 일
- 답이 갈리는 질문은 두 번 물어 다른지 봅니다.
AI는 후보마다 점수를 매겨 하나를 고르지만, 그 점수에 사실 여부는 표시되지 않습니다.
AI에 같은 질문을 두 번 해도 답이 조금씩 달라질 때가 있습니다. 고장이라기보다 글을 만드는 방식에서 생기는 현상입니다. AI는 다음에 올 토큰마다 점수를 매기고, 그중 하나를 확률로 골라 문장을 이어갑니다.
점수를 확률로 바꿔서 뽑습니다
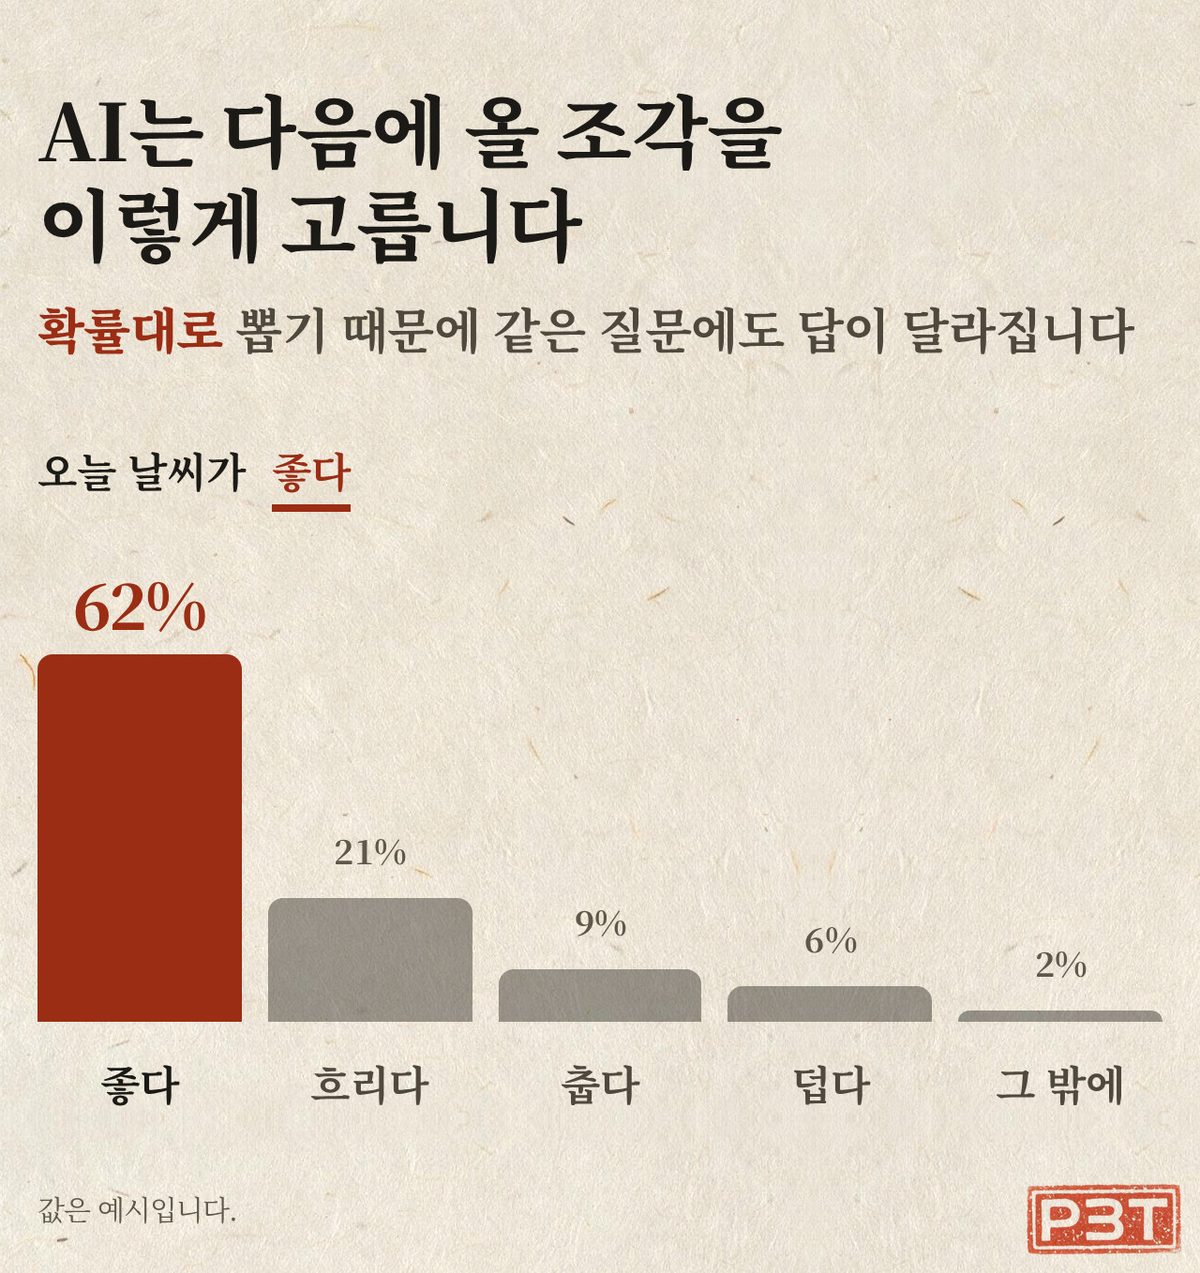
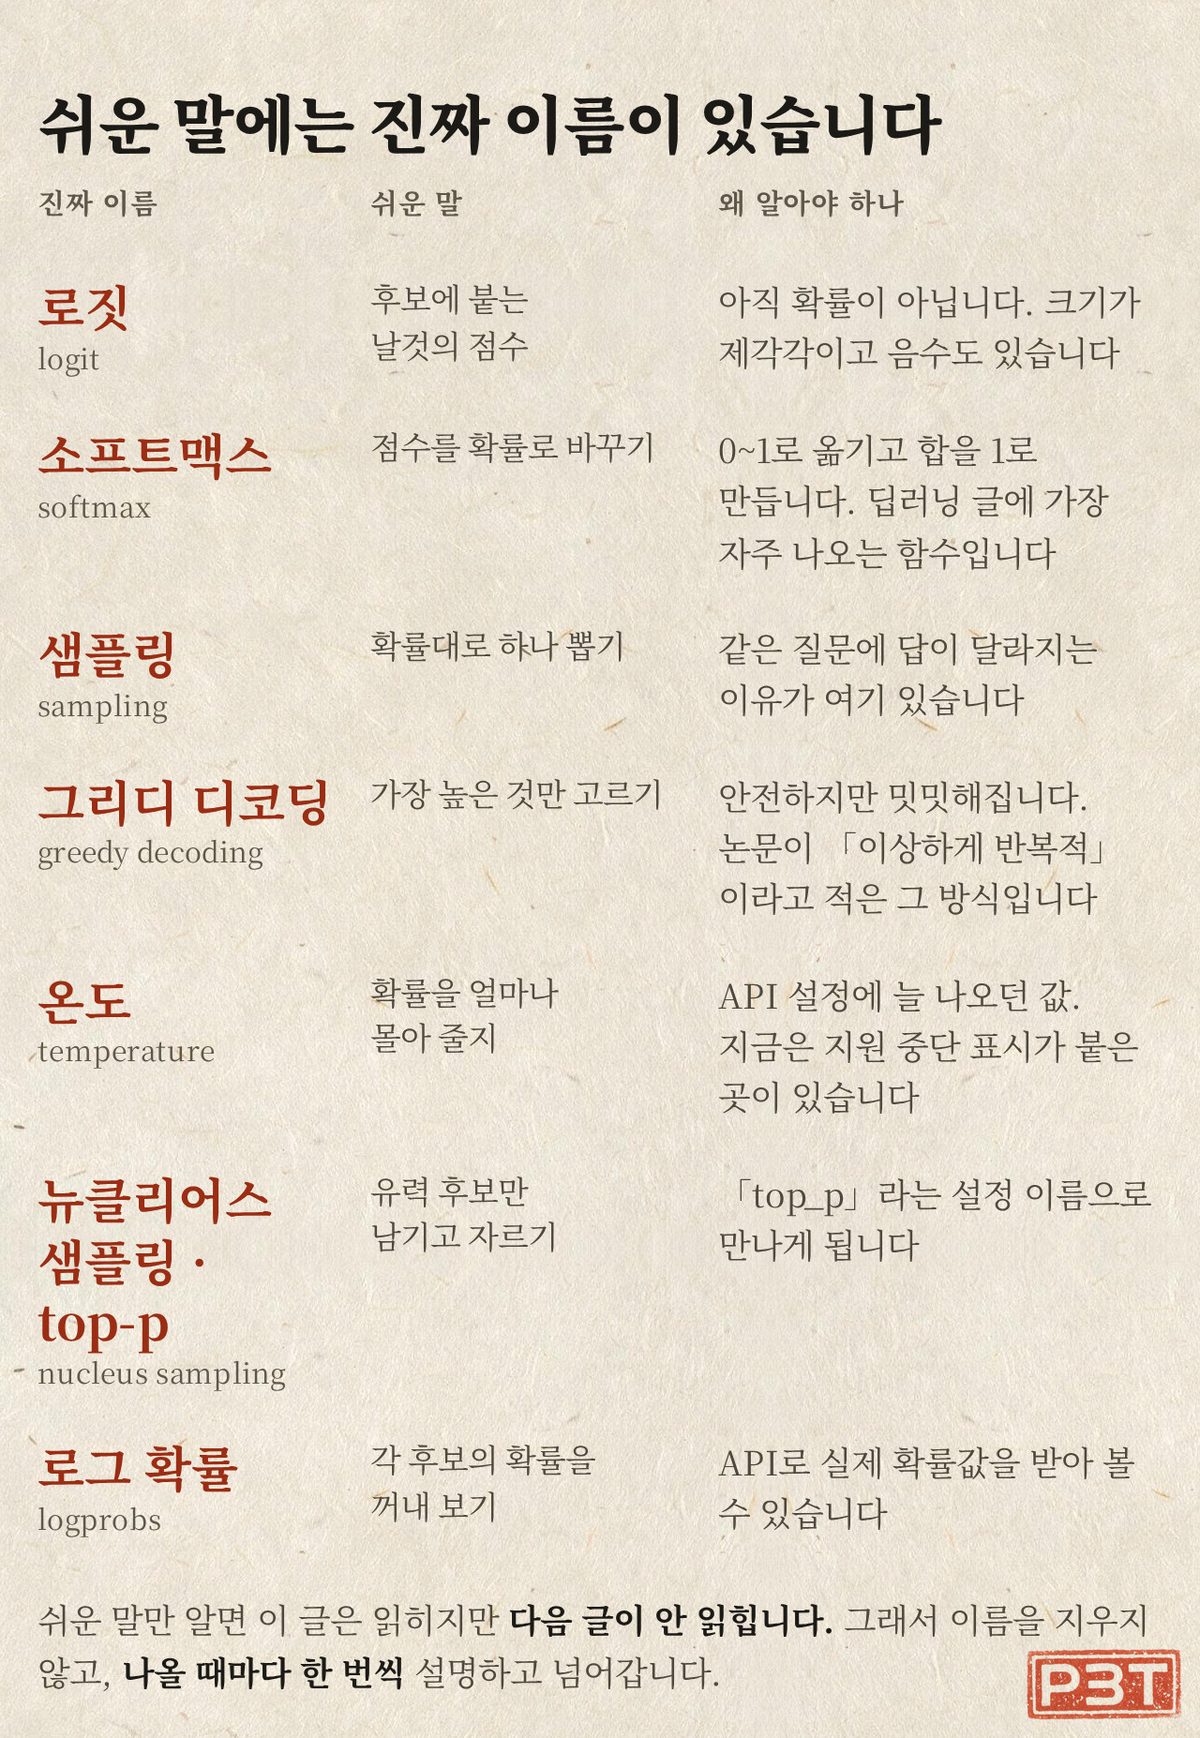
「오늘 날씨가」 다음에는 「좋다」, 「흐리다」, 「춥다」 처럼 여러 표현이 올 수 있습니다. AI는 가능한 모든 토큰에 점수를 붙입니다. 이 가공 전 점수를 로짓(logit)이라고 부릅니다.
로짓은 크기도 제각각이고 음수도 있습니다. 그래서 한 번 다듬습니다. 전부 0과 1 사이의 값으로 바꾸고 전체 합이 정확히 1이 되게 만드는데, 이것을 소프트맥스(softmax)라고 합니다1.
합이 1이면 그게 곧 확률입니다. 그 결과 「좋다 62%, 흐리다 21%, 춥다 9%」 같은 확률표가 만들어집니다. 실제로는 이보다 훨씬 많은 후보가 들어 있습니다. AI는 설정에 따라 가장 확률이 높은 토큰을 고르거나, 확률을 반영해 하나를 뽑습니다.
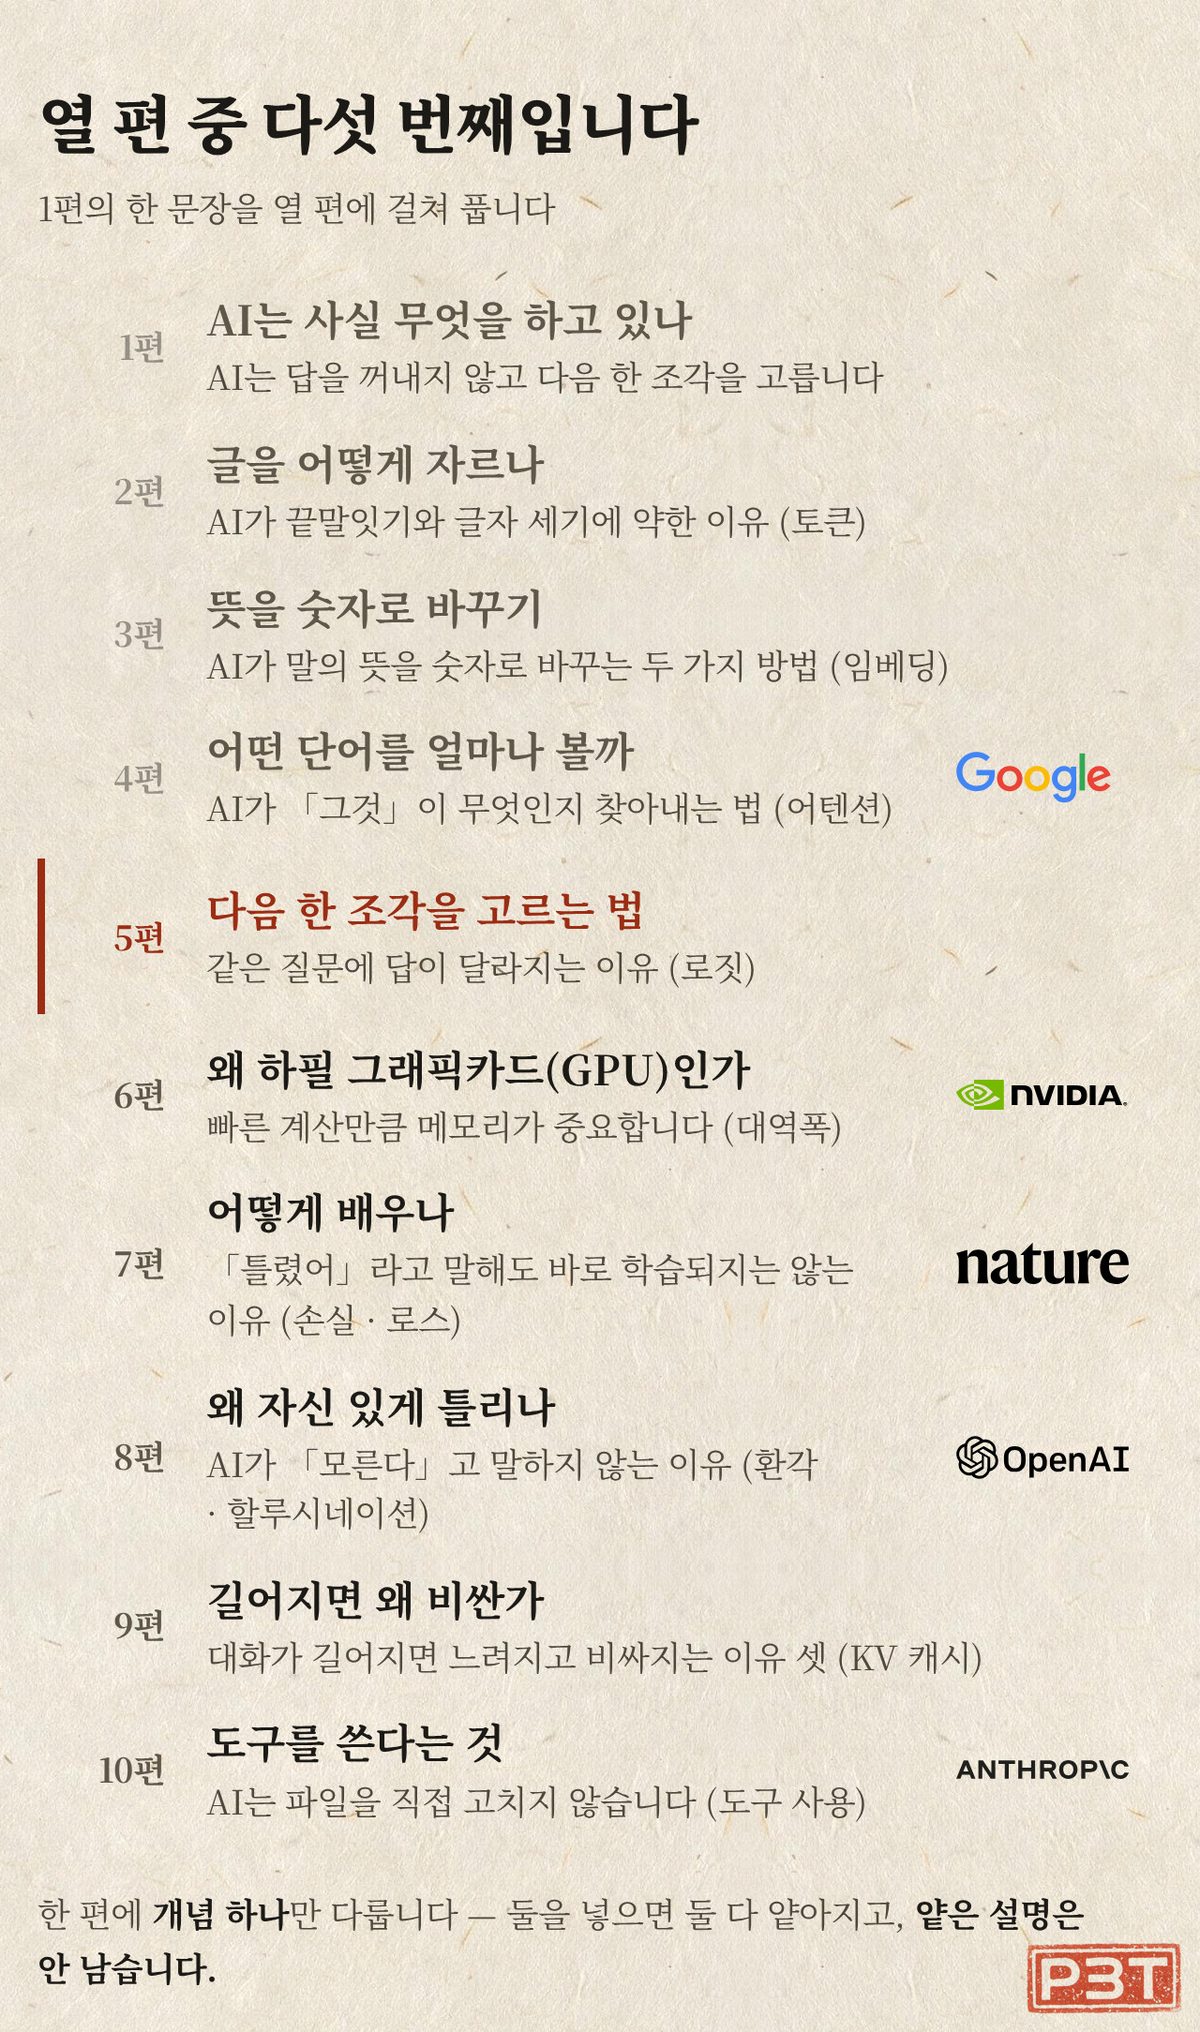
여기서 자연히 나오는 질문이 하나 있습니다. 그러면 AI는 언제 멈출까요. 알아서 멈추는 것이 아닙니다. 후보 목록에는 「여기서 끝」이라는 토큰도 하나 들어 있고, 그 토큰이 뽑히면 답이 끝납니다. 멈추는 것도 고르는 일입니다. 그 단계는 7편에서 봅니다.
가장 높은 것만 고르면 글이 밋밋해집니다
가장 확률이 높은 토큰만 고르면 되지 않을까요?
짧은 답에서는 괜찮아 보이지만, 긴 글을 이어 쓰게 하면 문제가 드러납니다. 2019년 논문 한 편이 이 문제를 다뤘습니다. 확률이 가장 높은 쪽만 계속 고르면 글이 반복적이고 부자연스러운 문장이 되풀이된다는 것입니다2.
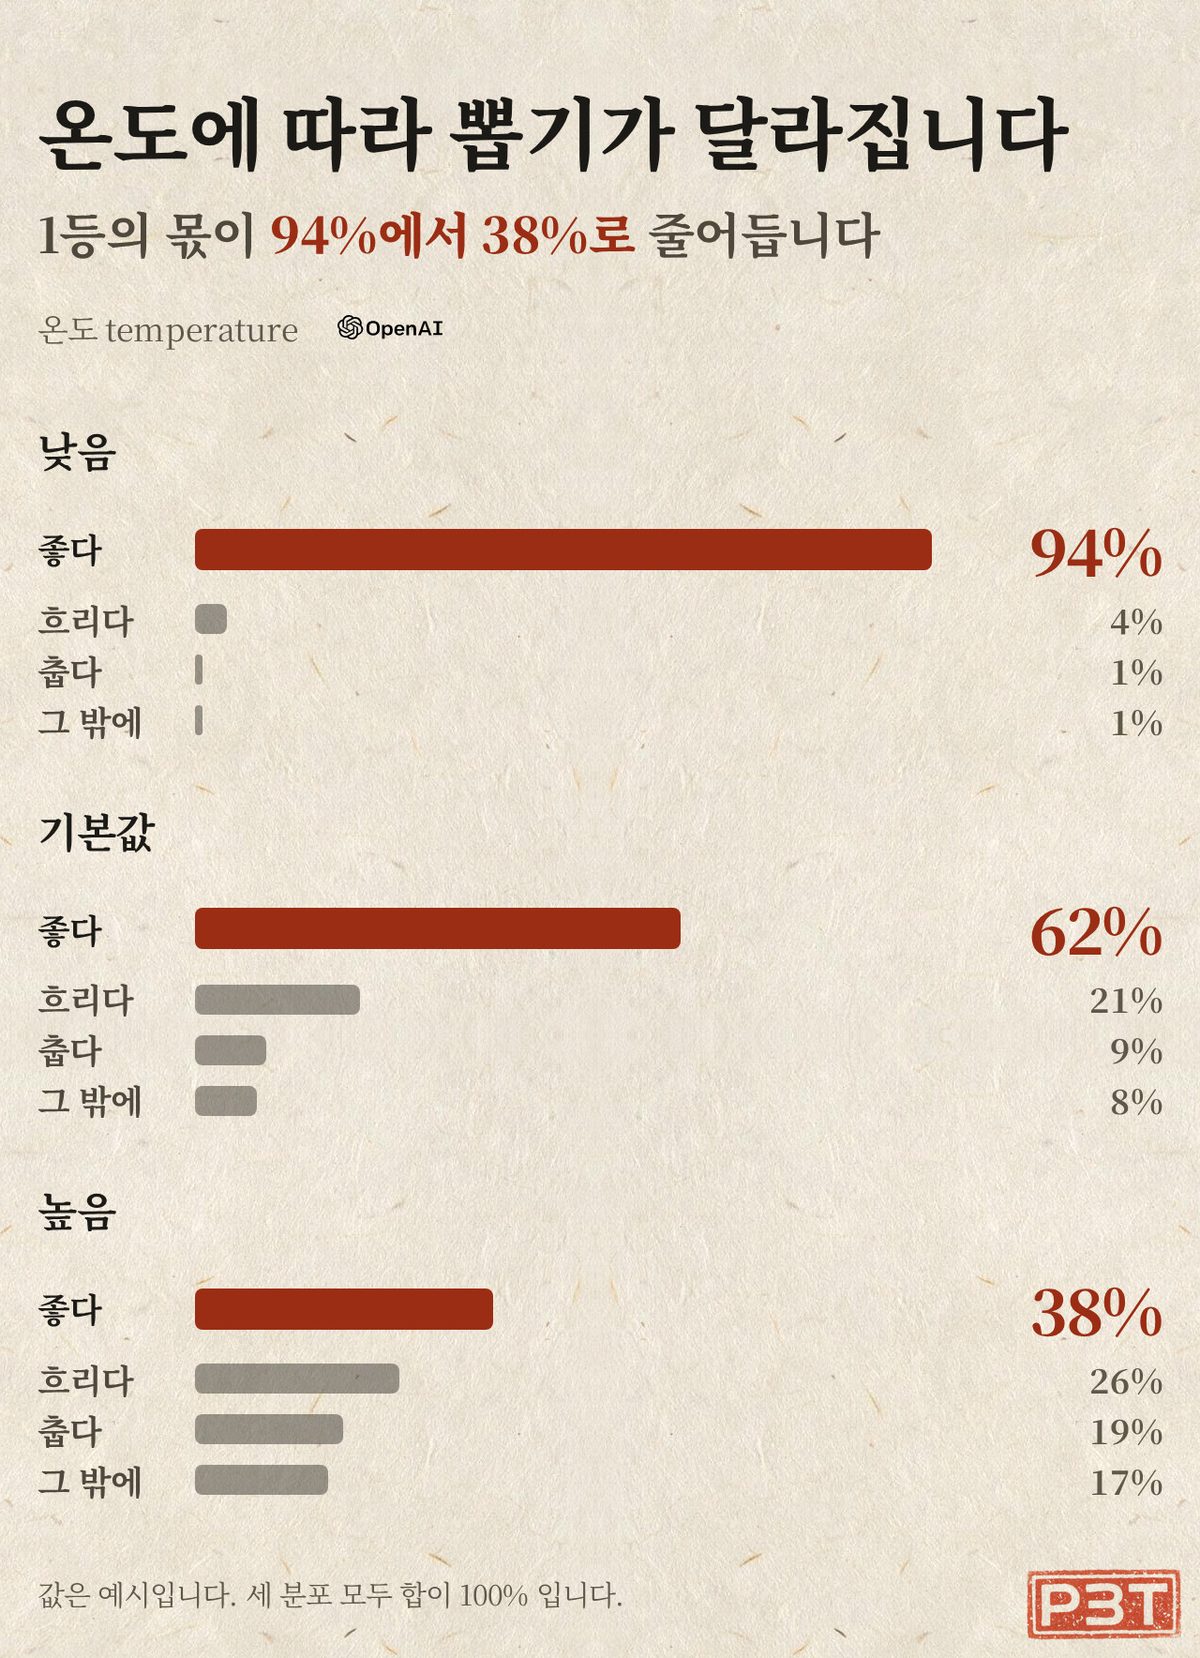
그래서 확률표를 조절하는 설정이 생겼습니다. 대표적인 것이 온도(temperature)입니다. 오픈AI는 온도를 낮추면 확률이 높은 후보에 더 집중하고, 높이면 다양한 후보를 선택할 가능성이 커진다고 설명합니다3.
다만 온도가 낮다고 답이 더 정확해지는 것은 아닙니다. 틀린 후보의 점수가 가장 높다면, 같은 오답을 더 꾸준히 내놓을 수도 있습니다.
또 다른 설정은 top-p 입니다. 확률이 높은 후보부터 더해 누적 확률이 정해진 값에 도달할 때까지만 남기고, 그 안에서 하나를 고릅니다. 앤트로픽은 이를 뉴클리어스 샘플링(nucleus sampling)이라고 부릅니다4.
오픈AI는 일반적으로 temperature와 top-p 가운데 하나만 조절하라고 권합니다5. 둘을 함께 바꾸면 결과가 달라진 이유를 파악하기 어려워지기 때문입니다.
그런데 이 손잡이가 사라지는 중입니다
온도와 top-p는 오랫동안 널리 쓰였지만, 모든 최신 모델에서 조절할 수 있는 것은 아닙니다.
앤트로픽은 클로드 오퍼스 4.6(Claude Opus 4.6) 이후에 나온 모델이 temperature 설정을 지원하지 않는다고 말합니다. 그 모델들은 예전 방식으로 쓰던 프로그램이 그대로 돌아가도록 1.0만 받아 주고, 다른 값을 넣으면 오류를 내며 거절한다고 얘기합니다6. 후보를 잘라내는 설정인 top_p와 top_k에도 지원하지 않는다는 같은 표시가 붙어 있습니다7.
회사와 모델마다 다르므로 실제로 쓸 때는 해당 모델의 최신 문서를 확인해야 합니다.
이 변화만으로 업계 전체의 방향을 단정할 수는 없습니다. 다만 사용자가 확률을 직접 조절하는 모델과, 모델이 생성 방식을 내부에서 관리하는 모델이 함께 존재한다고 볼 수 있습니다.
손잡이가 사라져도 기본 구조는 같습니다. AI는 다음 토큰 후보들의 점수를 만들고 그중 하나를 선택합니다.
확률표에는 정답 표시가 없습니다
여기서 중요한 점이 하나 있습니다.
「좋다 62%, 흐리다 21%, 춥다 9%」라는 표에는 어떤 후보가 사실인지 표시하는 칸이 없습니다. AI가 계산하는 것은 지금까지의 문맥에서 다음 토큰으로 얼마나 자연스럽게 이어지는가입니다.
물론 모델은 학습 과정에서 많은 사실과 사람의 선호를 익힙니다. 하지만 다음 토큰을 고르는 마지막 단계에 별도의 사실 확인 장치가 자동으로 작동하는 것은 아닙니다.
AI가 그럴듯하게 틀리는 이유의 일부가 여기에 있습니다. 그렇다고 모든 오류를 확률 선택만으로 설명할 수는 없습니다. 학습 자료, 평가 방식, 질문의 모호함, 검색 결과도 영향을 줍니다. 나머지는 8편에서 살펴보겠습니다.
설정을 직접 확인하고 싶다면 사용 중인 모델의 API 문서를 보세요. 오픈AI는 developers.openai.com, 앤트로픽은 platform.claude.com에서 temperature와 top-p의 지원 여부를 확인할 수 있습니다.
다음 편에서는 이 네 단계를 실제로 계산하는 기계를 봅니다. AI에 왜 GPU가 필요한지, 계산은 어디에서 느려지는지 알아보겠습니다.
읽고 나서 해 볼 것
중요한 질문을 AI에 세 번 똑같이 던져 보세요. 답이 달라지는 부분은 후보들의 확률이 비슷했던 자리일 수 있습니다. 하지만 세 답이 같다고 사실이라는 뜻도 아닙니다. 숫자·이름·날짜·출처는 원문에서 따로 확인하세요.
출처
각주 7개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 파이토치 공식 문서는 소프트맥스가 값들을 0과 1 범위에 놓이게 하고 합이 1이 되도록 다시 조정한다고 적는다Rescales them so that the elements of the n-dimensional output Tensor lie in the range [0,1] and sum to 1.https://docs.pytorch.org/docs/stable/generated/torch.nn.Softmax.html확인 2026-09-02↩
- 2019년 논문은 가능도를 디코딩 목표로 삼으면 밋밋하고 이상하게 반복적인 글이 나온다고 적었다using likelihood as a decoding objective leads to text that is bland and strangely repetitive.https://arxiv.org/abs/1904.09751확인 2026-09-02↩
- 오픈AI 문서는 높은 temperature 값이 출력을 더 무작위하게, 낮은 값이 더 집중되고 결정적으로 만든다고 적는다What sampling temperature to use, between 0 and 2. Higher values like 0.8 will make the output more random, while lower values like 0.2 will make it more focused and deterministic.https://developers.openai.com/api/reference/python/resources/chat/subresources/completions/methods/create확인 2026-09-02↩
- 앤트로픽 문서는 뉴클리어스 샘플링이 확률 내림차순으로 누적 분포를 계산해 지정한 값에 이르면 잘라 낸다고 설명한다In nucleus sampling, we compute the cumulative distribution over all the options for each subsequent token in decreasing probability order and cut it off once it reaches a particular probability specified by top_p.https://platform.claude.com/docs/en/api/messages확인 2026-09-02↩
- 오픈AI 문서는 temperature 와 top_p 중 하나만 조절하기를 권한다We generally recommend altering this or top_p but not both.https://developers.openai.com/api/reference/python/resources/chat/subresources/completions/methods/create확인 2026-09-02↩
- 앤트로픽 문서는 클로드 오퍼스 4.6 이후 출시 모델이 temperature 설정을 지원하지 않으며 1.0 외의 값은 오류로 거절된다고 적는다Deprecated. Models released after Claude Opus 4.6 do not support setting temperature. A value of 1.0 of will be accepted for backwards compatibility, all other values will be rejected with a 400 error.https://platform.claude.com/docs/en/api/messages확인 2026-09-08↩
- 같은 문서는 top_p 와 top_k 에도 같은 지원 중단 표시를 붙여 두었다Deprecated. Models released after Claude Opus 4.6 do not support setting top_p. A value >= 0.99 will be accepted for backwards compatibility, all other values will be rejected with a 400 error. | Deprecated. Models released after Claude Opus 4.6 do not accept top_k; any value will be rejected with a 400 error.https://platform.claude.com/docs/en/api/messages확인 2026-09-08↩