 P3T
AI 프롬프트에 자료를 많이 넣으면 답이 좋아질까요
입력이 길수록 성능이 내려갔고, 같은 정보도 놓인 자리와 추려 넣기에 따라 결과가 달랐습니다
- 무슨 일
- AI 프롬프트에 자료를 많이 넣는다고 답이 계속 좋아지지는 않았습니다
- 확인된 것
- 입력이 길어질수록 성능이 내려간다는 결과가 두 곳에서 나왔습니다
- 왜 중요한가
- 골라 넣은 입력이 전부 넣은 입력보다 모든 모델에서 높았습니다
- 오늘 할 일
- 필요한 부분만 추려 질문보다 위쪽에 두고, 질문은 그 아래에 적어 보세요
연구들에서는 자료를 많이 넣어도 답이 계속 좋아지지는 않았고, 입력이 길어질수록 성능이 내려가는 경향이 나타났습니다.
AI 프롬프트에 자료를 많이 넣는다고 답이 계속 좋아지지는 않았습니다. 입력이 길어질수록 성능이 내려간다는 결과가 서로 다른 두 곳에서 나왔습니다. 같은 정보라도 입력의 어느 위치에 넣느냐에 따라 성능이 달라졌습니다. AI 프롬프트는 질문과 함께 AI 에 넣는 글 전체를 뜻합니다. AI 가 한 번에 읽을 수 있는 분량은 컨텍스트 윈도우라고 부릅니다. 그렇다면 자료는 얼마나, 어디에 넣는 것이 좋을까요?
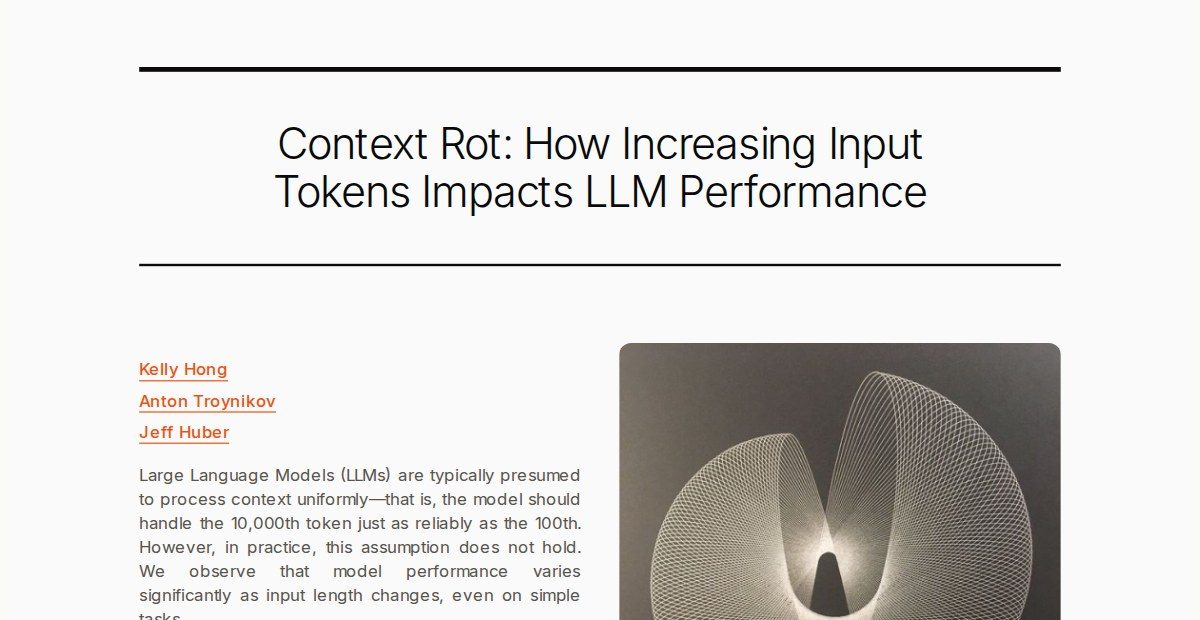
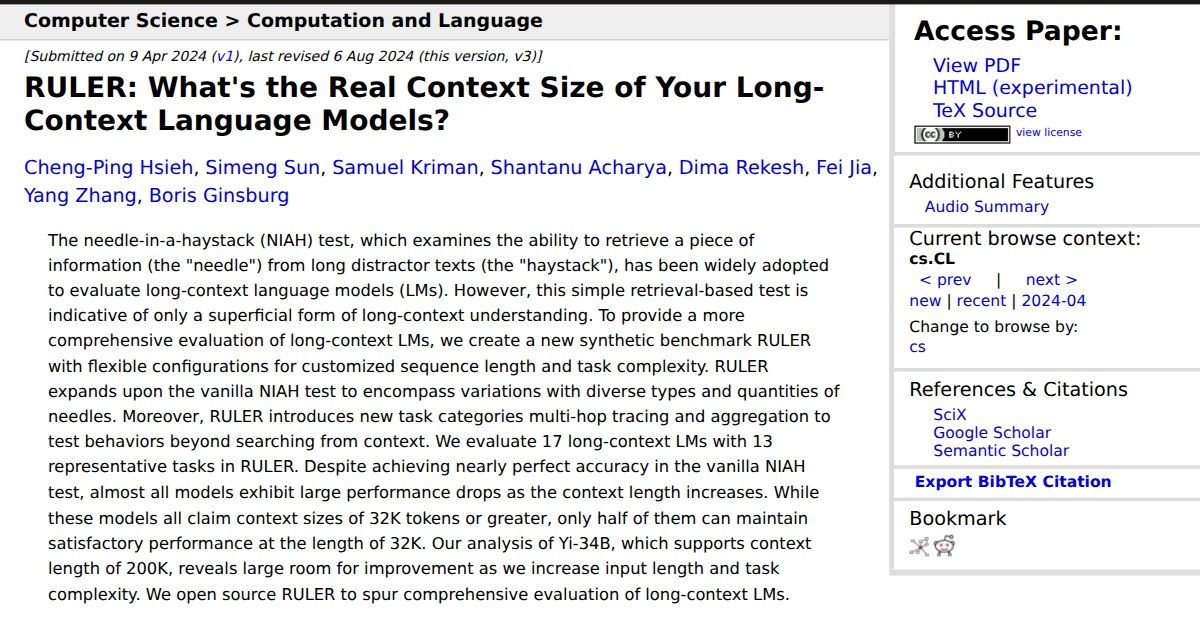
- 입력이 길어질수록 성능이 내려간다는 결과가 Chroma 보고서와 RULER 논문, 두 곳에서 나왔습니다.
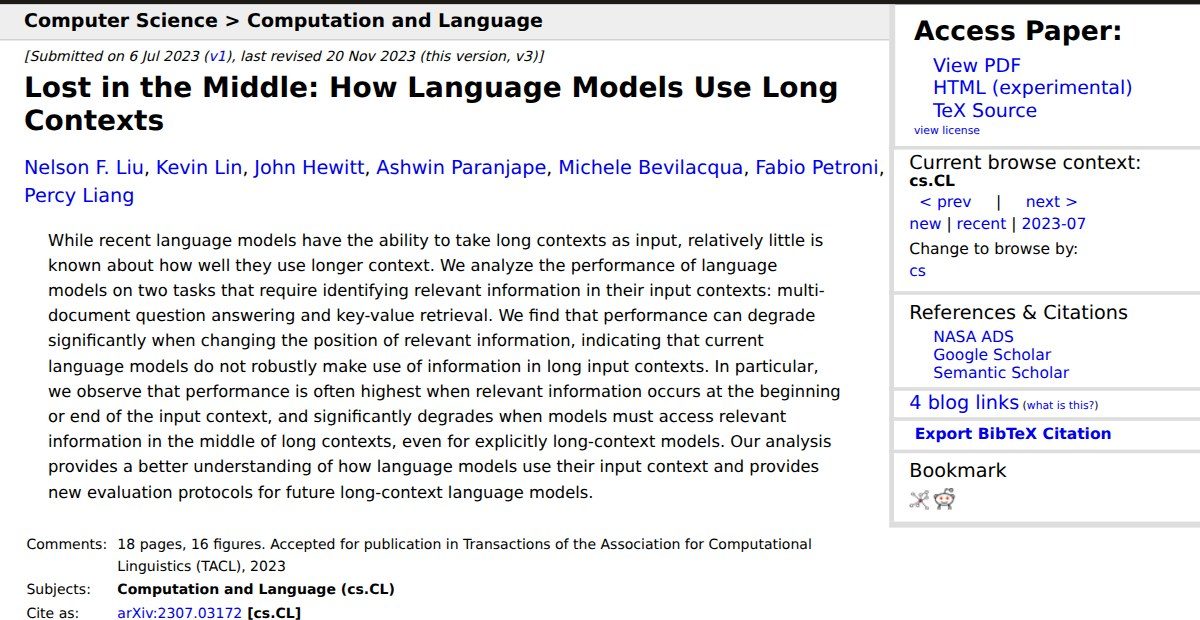
- 필요한 정보가 입력 중간에 있을 때는 처음이나 끝에 있을 때보다 성능이 크게 떨어졌습니다.
- 제 해석으로는 자료를 넣는 양만이 아니라 무엇을 어디에 넣느냐도 답의 품질에 영향을 줄 수 있습니다.
입력이 길어질수록 성능이 내려갔습니다
Chroma 연구진은 보고서에서 여러 모델을 시험했습니다. GPT-4.1, Claude 4, Gemini 2.5, Qwen3 계열이 들어 있습니다1. Chroma 연구진은 모든 실험에서 입력 길이가 늘어날수록 모델 성능이 꾸준히 떨어졌다고 정리했습니다1.
비슷한 결과는 다른 논문에서도 나왔습니다. RULER 논문에서도 거의 모든 모델이 입력이 길어질수록 성능이 크게 떨어졌습니다2. 이 모델들은 모두 긴 입력을 읽을 수 있다고 스스로 내세운 모델이었습니다2.
같은 정보도 놓인 자리에 따라 달랐습니다
입력 안에서 정보가 놓인 위치를 살핀 논문을 보겠습니다. 필요한 정보가 입력의 처음이나 끝에 있을 때 성능이 가장 높은 경우가 많았습니다3. 정보가 긴 입력의 중간에 있으면 성능이 크게 떨어졌습니다3. 다만 지금 쓰는 모델에서도 같은 크기로 나타나는지는 따로 확인해야 합니다.
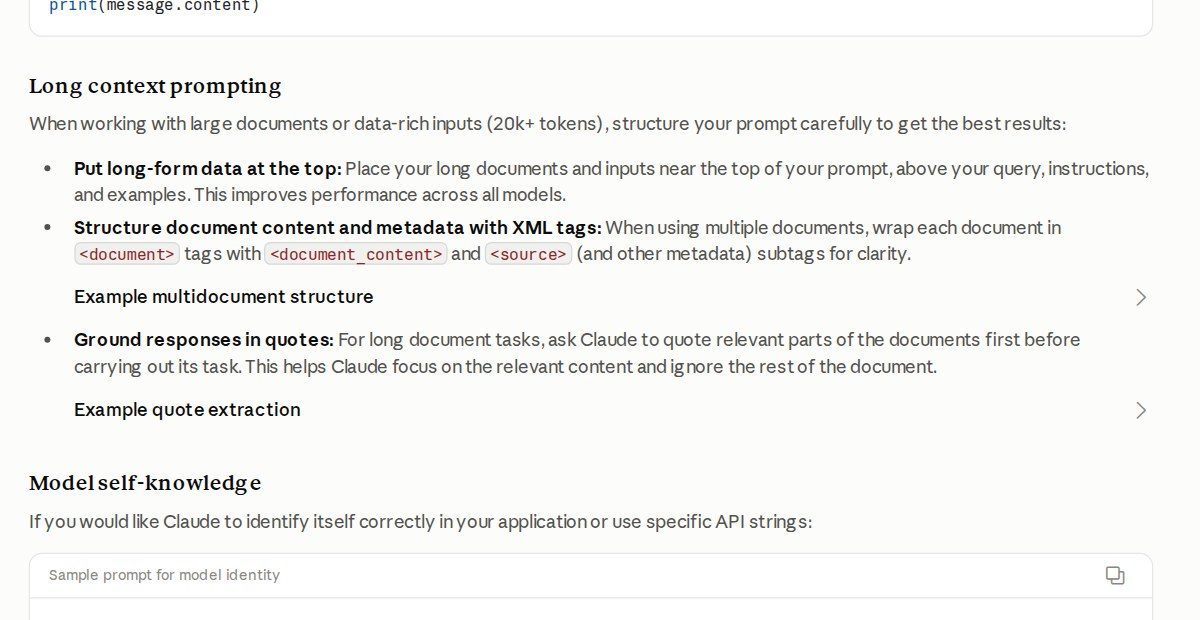
Anthropic 의 Claude 사용 문서에는 자료를 넣는 위치를 안내한 내용도 있습니다. 긴 문서나 자료는 프롬프트 위쪽에 두고, 질문과 지시는 그 아래에 두라고 권합니다4. 이 권고는 Anthropic 이 자사 문서에 적은 내용입니다.
추려 넣은 입력이 전부 넣은 입력보다 높았습니다
Chroma 는 추려 넣은 프롬프트(focused)와 전부 넣은 프롬프트(full)도 비교했습니다. 추려 넣은 프롬프트가 전부 넣은 프롬프트보다 모든 모델에서 성능이 크게 높았습니다5.
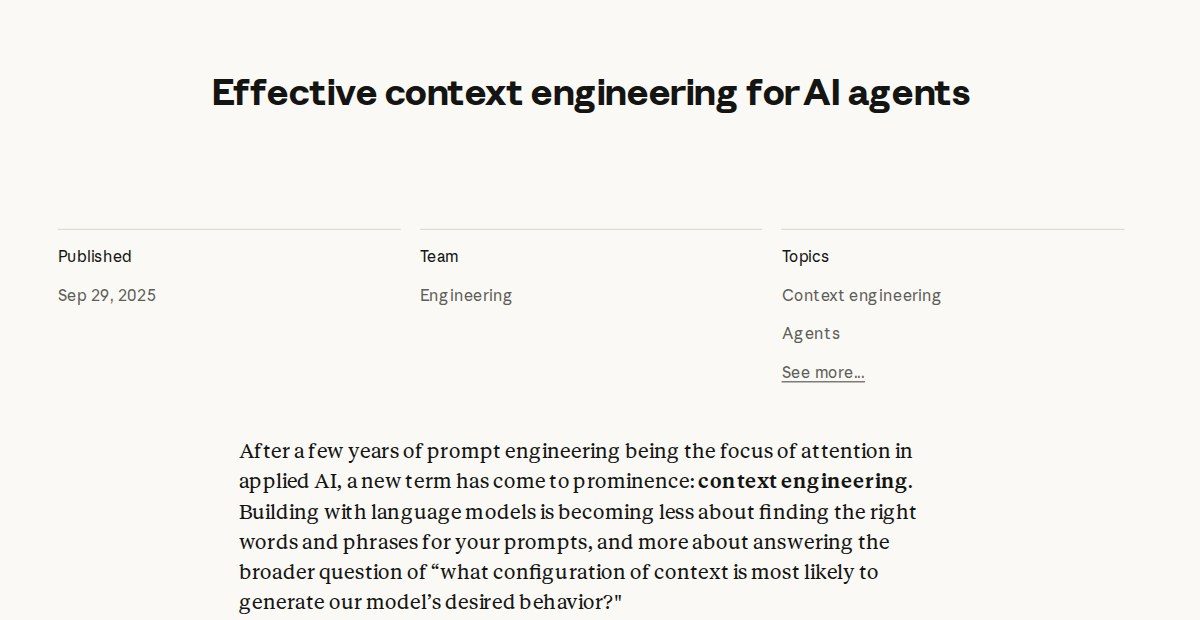
Anthropic 엔지니어링 글도 같은 방향입니다. 컨텍스트는 더 넣을수록 얻는 이득이 줄어드는 한정된 자원으로 다뤄야 한다고 적었습니다6. 자료를 더 넣어도 얻는 효과가 갈수록 작아진다는 뜻이지, 넣는 것 자체가 손해라는 뜻은 아닙니다. 이 글은 원하는 결과가 나올 가능성을 가장 높이는, 가장 작은 고신호 토큰 집합을 찾는 일을 말합니다7. 토큰은 AI 가 글을 읽는 조각 단위입니다.
이 결과를 어디까지 믿을 수 있을까요
모델은 계속 바뀌므로 이 연구들의 결과가 지금 쓰는 모델에서 같은 크기로 나타난다고 단정할 수는 없습니다.
내 업무의 자료 묶음에서 성능이 얼마나 떨어질지는 이 연구들로 알 수 없습니다.
그래서 이 글의 결론은 많이 넣지 말라는 것이 아닙니다. 필요한 자료는 넣되, 무엇을 어디에 넣을지를 먼저 따져 보라는 것입니다.
읽고 나서 해 볼 것
긴 자료를 넣을 때는 꼭 필요한 부분만 추려 질문보다 위쪽에 두고, 질문은 그 아래에 적어 보세요.
출처
각주 7개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- Chroma 보고서는 GPT-4.1·Claude 4·Gemini 2.5·Qwen3 계열을 포함한 모델을 시험했고 모든 실험에서 입력 길이가 늘어날수록 모델 성능이 꾸준히 떨어졌다고 정리했다Across all experiments, model performance consistently degrades with increasing input length.https://www.trychroma.com/research/context-rot확인 2026-10-25In this report, we evaluate 18 LLMs, including the state-of-the-art GPT-4.1, Claude 4, Gemini 2.5, and Qwen3 models.https://www.trychroma.com/research/context-rot확인 2026-10-25↩
- RULER 논문은 거의 모든 모델이 컨텍스트 길이가 늘어날수록 성능이 크게 떨어졌다고 보고했고, 이 모델들은 긴 입력을 읽을 수 있다고 스스로 내세운 모델이었다almost all models exhibit large performance drops as the context length increases.https://arxiv.org/abs/2404.06654확인 2026-10-25While these models all claim context sizes of 32K tokens or greater,https://arxiv.org/abs/2404.06654확인 2026-10-25↩
- 해당 논문은 필요한 정보가 입력의 처음이나 끝에 있을 때 성능이 가장 높은 경우가 많았고 긴 입력의 중간에 있으면 크게 떨어졌다고 보고했다performance is often highest when relevant information occurs at the beginning or end of the input context.https://arxiv.org/abs/2307.03172확인 2026-10-25significantly degrades when models must access relevant information in the middle of long contexts.https://arxiv.org/abs/2307.03172확인 2026-10-25↩
- Anthropic 의 Claude 문서는 긴 자료를 프롬프트 위쪽에, 질문과 지시를 그 아래에 두라고 권한다(회사 문서 주장)Put long-form data at the top: Place your long documents and inputs near the top of your prompt, above your query, instructions, and examples. This improves performance across all models.https://platform.claude.com/docs/en/build-with-claude/prompt-engineering/long-context-tips확인 2026-10-25↩
- Chroma 보고서는 모든 모델에서 골라 넣은 focused 프롬프트가 전부 넣은 full 프롬프트보다 성능이 크게 높았다고 보고했다Across all models, we see significantly higher performance on focused prompts compared to full prompts.https://www.trychroma.com/research/context-rot확인 2026-10-25↩
- Anthropic 엔지니어링 글은 컨텍스트를 이득이 줄어드는 한정된 자원으로 다뤄야 한다고 적었다(회사 글)Context, therefore, must be treated as a finite resource with diminishing marginal returns.https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents확인 2026-10-25↩
- Anthropic 엔지니어링 글은 원하는 결과가 나올 가능성을 가장 높이는 가장 작은 고신호 토큰 집합을 찾는 일을 말한다(회사 글)finding the smallest possible set of high-signal tokens that maximize the likelihood of some desired outcome.https://www.anthropic.com/engineering/effective-context-engineering-for-ai-agents확인 2026-10-25↩