 P3T
파라미터 뜻, 크기 순서와 점수 순서는 달랐습니다
알리바바는 5조~10조 개로 키울 계획이지만, 같은 점수표에선 크기 순서대로 줄 서지 않았습니다
- 무슨 일
- 알리바바는 Qwen 4.5·Qwen 5 시리즈를 5조~10조 개 매개변수로 키울 계획입니다.
- 확인된 것
- 같은 점수표를 열어 보니 크기 순서와 점수 순서가 일치하지 않았습니다
- 왜 중요한가
- 에포크 AI가 말한 것은 매개변수 개수가 아니라 컴퓨트·전력·데이터를 더 들인 학습입니다
- 오늘 할 일
- 새 모델은 같은 점수표의 점수와 추론 설정을 함께 확인해 보세요
AI 모델은 크기 순서와 점수 순서가 일치하지 않았고, 어떤 점수표로 평가하느냐에 따라 순서도 바뀝니다.
파라미터 뜻부터 짚겠습니다. 파라미터(매개변수)는 AI 모델의 크기를 셀 때 쓰는 숫자입니다. 그럼 이 숫자가 클수록 더 똑똑할까요? 같은 점수표를 열어 보니 크기 순서와 점수 순서가 일치하지 않았습니다. 다만 모델마다 추론 설정과 실제로 일하는 매개변수(활성 매개변수)가 달라, 같은 조건에서 비교한 것은 아닙니다. 모델을 만드는 회사는 여전히 더 키우겠다고 말합니다. 어떤 점수표로, 어떤 추론 설정에서 평가하느냐에 따라 순서가 바뀝니다.
- 모델을 만드는 회사는 여전히 더 큰 모델을 만들겠다고 말하지만, 이런 모델은 아직 계획 단계입니다.
- 같은 점수표에서 크기 순서와 점수 순서는 일치하지 않았고, 점수표 위쪽 모델들은 크기가 공개되지 않았거나 비공개로 표기됩니다.
- 에포크 AI는 컴퓨트·전력·데이터를 더 들인 학습을 성능 향상의 근거로 들었기에, 파라미터 숫자 하나로는 똑똑함을 가늠하기 어렵습니다.
모델을 만드는 쪽은 아직 키우겠다고 말합니다
알리바바는 공식 보도자료에서 지금 학습 중인 Qwen 4 다음에 나올 Qwen 4.5 와 Qwen 5 시리즈를 5조~10조 개 매개변수 규모로 키울 계획이라고 밝혔습니다12. 다만 이것은 회사가 밝힌 계획이지, 나와 있는 모델이 아닙니다.
뉴욕대 상하이 연구소(NYU Shanghai RITS)도 이 발표를 실제 모델이 아닌 계획으로 봤습니다. Qwen 4는 출시일이 정해지지 않았고, 5조~10조 개 모델은 Qwen 4보다 한 세대 이상 뒤에 나올 것이라고 짚었습니다3. 계획 단계라 비교할 점수도 아직 없습니다.
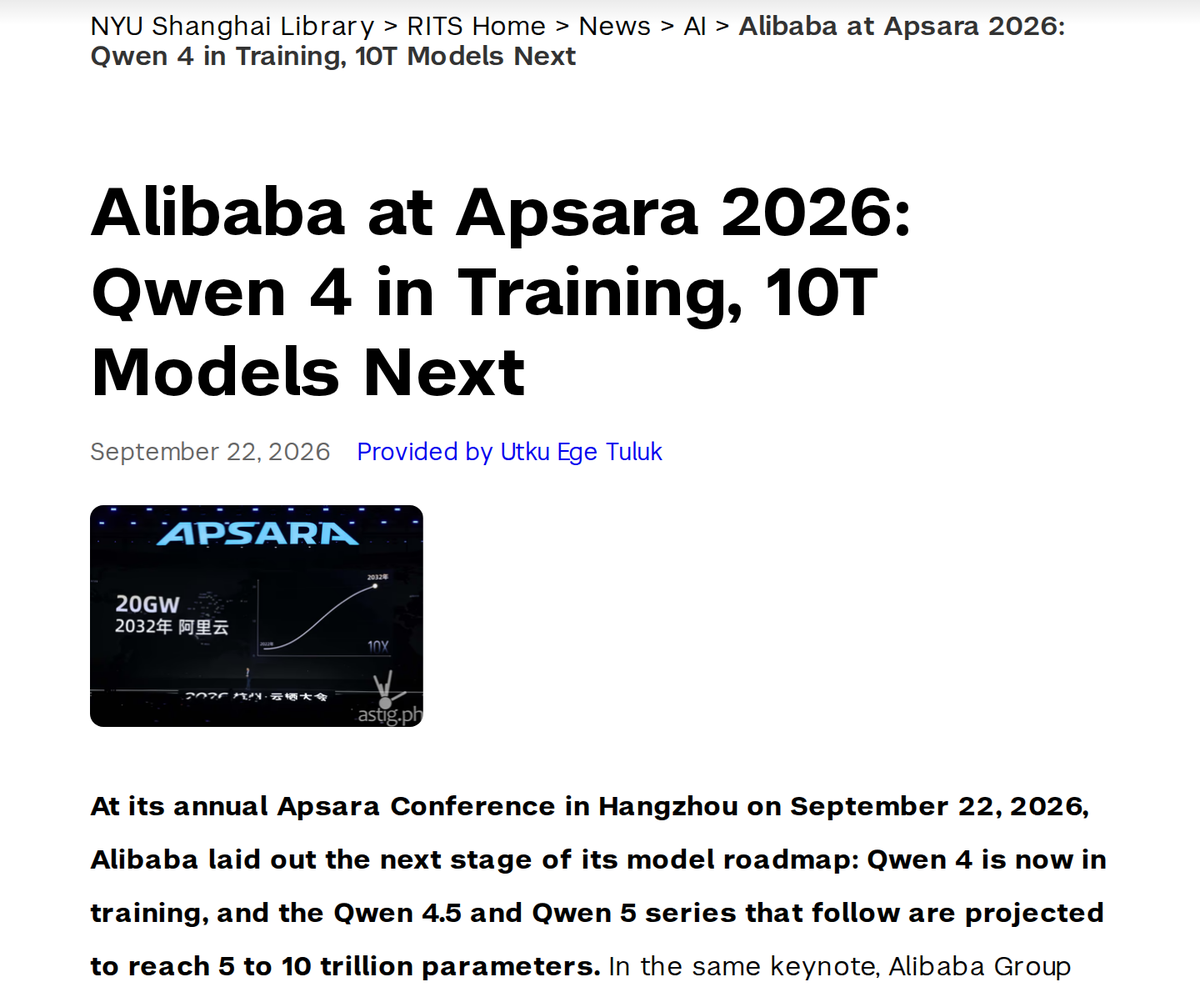
같은 발표에서 에디 우(알리바바 대표)는 매개변수가 270억 개인 공개 모델(누구나 내려받아 쓸 수 있는 모델) Qwen3.8-27B 이야기도 꺼냈습니다. 전 세계 개발자에게 가장 인기 있는 모델이 됐다고 말한 것으로 보도됐습니다4. 한 회사가 같은 날 아주 큰 모델과 작은 모델을 함께 내세운 셈입니다.
같은 점수표에선 크기 순서대로 줄 서지 않았습니다
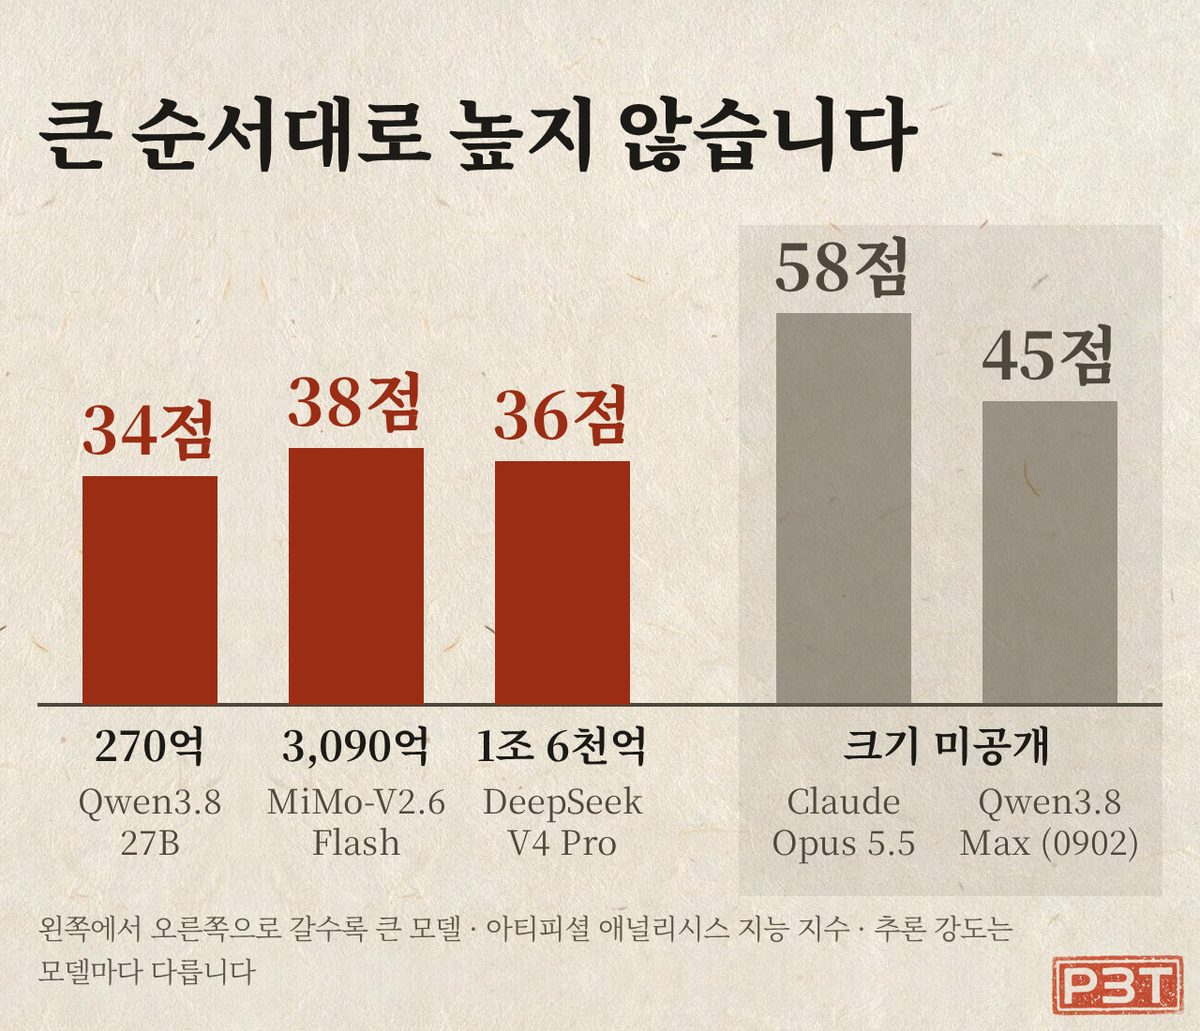
모델 성능을 한 숫자로 매기는 점수표에는 아티피셜 애널리시스(Artificial Analysis) 지능 지수가 있습니다. 이 점수표에서 MiMo-V2.6-Flash는 매개변수가 총 3,090억 개이고 38점을 받았습니다5. 1조 6천억 개인 DeepSeek V4 Pro는 36점이었습니다6. 매개변수가 270억 개인 Qwen3.8-27B는 34점이었습니다7.
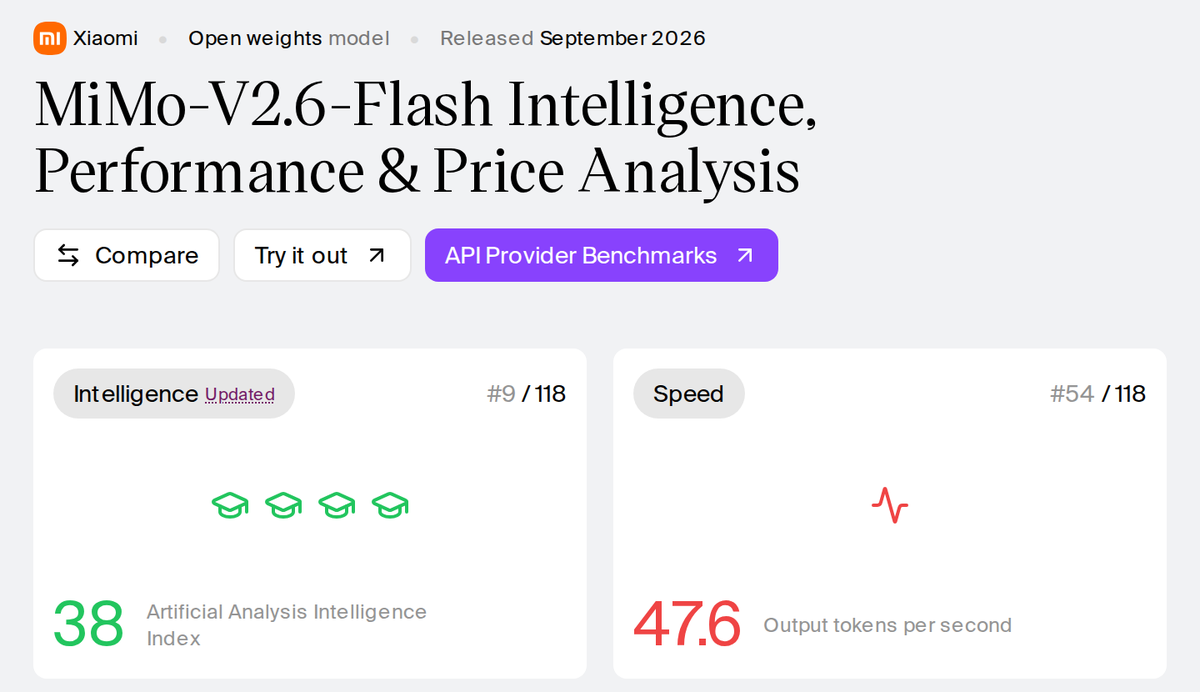
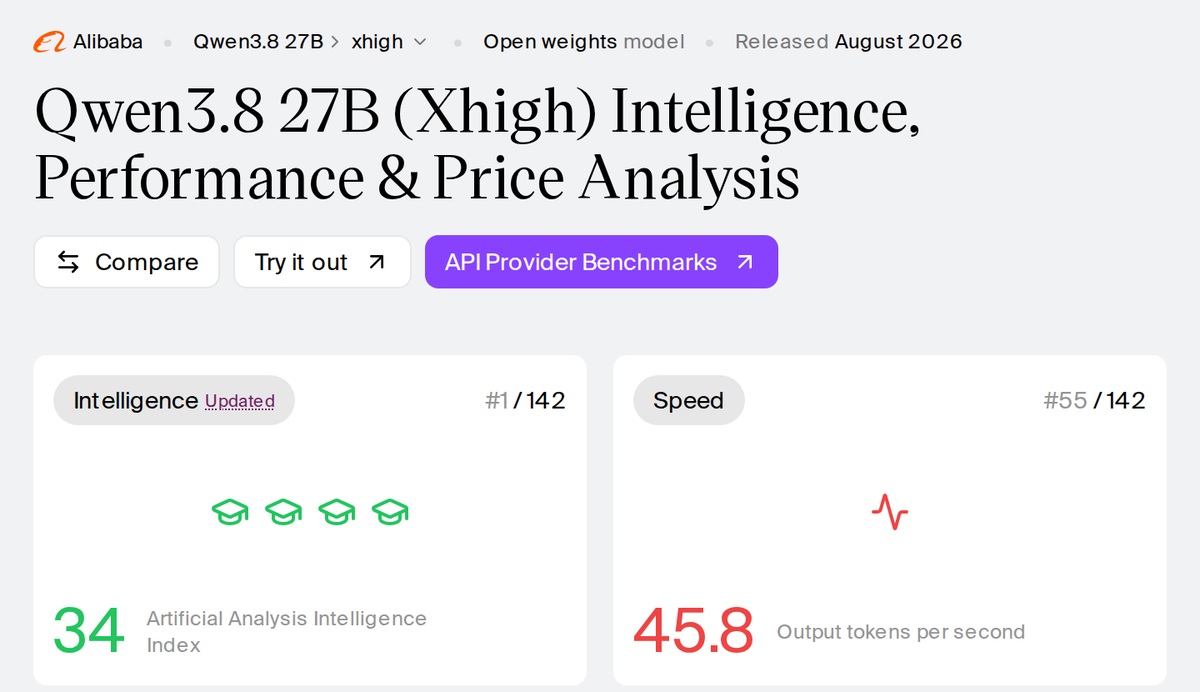
1조 6천억 개와 270억 개를 견주면 크기는 약 60배 차이지만, 점수 차이는 2점(36점·34점)이었습니다.
다만 조건이 같지 않은 비교입니다. MiMo-V2.6-Flash의 활성 매개변수는 150억 개입니다5. 모델마다 추론 강도 설정(Xhigh·Max)도 다릅니다.
점수표 위쪽 모델은 크기가 공개되지 않았습니다
같은 점수표의 위쪽은 사정이 다릅니다. Claude Opus 5.5는 58점인데, 앤트로픽은 모델 크기를 공개하지 않았습니다8. 알리바바의 Qwen3.8 Max(0902 판)도 45점을 받았지만, 아티피셜 애널리시스에 따르면 알리바바는 이 모델의 크기를 공개하지 않았습니다9. 그래서 가장 똑똑한 모델이 가장 큰지는 지금 공개된 숫자로 확인할 수 없습니다.
키우면 나아진다는 쪽에도 근거는 있습니다. 연구기관 에포크 AI(Epoch AI)는 컴퓨트·전력·데이터를 더 들일수록 성능이 꾸준히 좋아졌다고 정리했습니다10. 다만 에포크 AI가 말한 것은 매개변수 개수가 아니라 컴퓨트·전력·데이터를 더 들인 학습입니다.
점수표가 바뀌면 순서도 바뀝니다
작은 모델이 큰 모델에 거의 맞먹었다는 보도도 조심해서 읽어야 합니다. Qwen3.8-27B가 DeepSeek V4 Pro에 거의 맞먹었다고 더 넥스트 웹(The Next Web)이 적었습니다11. 그러면서도 평가 일부가 내부 평가였고 시험 조건이 같지 않아, 승자를 가릴 근거로는 약하다고 덧붙였습니다11.
크기가 비슷한 모델끼리도 점수 종류에 따라 앞서는 모델이 바뀐다는 논문도 있습니다. arXiv에 올라온 사전 공개 논문(동료 평가 전)입니다. 비슷한 크기의 소형 모델들이 정답률과 추론 경로 충실도에서 크게 달랐습니다. 두 지표가 서로 다른 모델을 앞세우기도 했습니다12. 크기보다 먼저 볼 것은 어떤 점수표로 평가했느냐입니다.
읽고 나서 해 볼 것
새 모델의 파라미터 숫자를 만나면, 같은 점수표에서 몇 점인지와 추론 설정이 같은지도 함께 확인해 보세요.
출처
각주 12개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 알리바바는 2026-09-22 공식 보도자료에서 다음에 나올 Qwen 4.5·Qwen 5 시리즈를 5조~10조 개 매개변수 규모로 키울 계획이라고 밝혔다(회사 주장·계획)The company further announced its roadmap for the upcoming Qwen 4.5 and Qwen 5 model series, projected to scale up to 5 to 10 trillion parameters.https://www.alibabacloud.com/press-room/alibaba-unveils-roadmap-on-full-stack-ai-strategy확인 2026-10-05앞으로 모델의 매개변수 규모를 5조~10조개까지 확대할 계획https://aitimes.com/news/articleView.html?idxno=215594확인 2026-10-04↩
- 알리바바는 다음 모델 Qwen 4 가 학습 중이라고 밝혔다(회사 주장)At the conference, Alibaba revealed that its next-generation model, Qwen 4 , is currently in training.https://www.alibabacloud.com/press-room/alibaba-unveils-roadmap-on-full-stack-ai-strategy확인 2026-10-05↩
- NYU Shanghai RITS 는 Qwen 4 에 출시일이 없고 5조~10조 개 모델은 적어도 한 세대 뒤라고 분석했다The headline is a plan, not a product. Qwen 4 has no release date, and the 5–10T models are at least one generation further out.https://rits.shanghai.nyu.edu/ai/alibaba-at-apsara-2026-qwen-4-in-training-10t-models-next/확인 2026-10-04↩
- 에디 우(알리바바 대표)는 오픈 모델 Qwen-27B 가 전 세계 개발자에게 가장 인기 있는 모델이 됐다고 말한 것으로 보도됐다(Alizila 재인용 · 2차)our open-source Qwen-27B has emerged as the most popular model among developers worldwidehttps://rits.shanghai.nyu.edu/ai/alibaba-at-apsara-2026-qwen-4-in-training-10t-models-next/확인 2026-10-04↩
- Artificial Analysis 기준 MiMo-V2.6-Flash 는 총 3,090억 개(활성 150억 개) 매개변수로 지능 지수 38점MiMo-V2.6-Flash scores 38 on the Artificial Analysis Intelligence Indexhttps://artificialanalysis.ai/models/mimo-v2-6-flash확인 2026-10-04309 billion parametershttps://artificialanalysis.ai/models/mimo-v2-6-flash확인 2026-10-0415 billion active parametershttps://artificialanalysis.ai/models/mimo-v2-6-flash확인 2026-10-04↩
- Artificial Analysis 기준 DeepSeek V4 Pro(0813 Max · 총 1조 6천억 개)는 지능 지수 36점36 on the Artificial Analysis Intelligence Indexhttps://artificialanalysis.ai/models/deepseek-v4-pro확인 2026-10-04Total parameters 1.6Thttps://artificialanalysis.ai/models/deepseek-v4-pro확인 2026-10-04↩
- Artificial Analysis 기준 Qwen3.8 27B(Xhigh · 270억 개)는 지능 지수 34점Qwen3.8 27B (Xhigh) ... 34 on the Artificial Analysis Intelligence Indexhttps://artificialanalysis.ai/models/qwen3-8-27b확인 2026-10-04Total parameters 27Bhttps://artificialanalysis.ai/models/qwen3-8-27b확인 2026-10-04↩
- Artificial Analysis 기준 Claude Opus 5.5(Max)는 지능 지수 58점 · 앤트로픽은 모델 크기를 공개하지 않았다58 on the Artificial Analysis Intelligence Indexhttps://artificialanalysis.ai/models/claude-opus-5-5확인 2026-10-04Anthropic has not disclosed the model size or parameter counthttps://artificialanalysis.ai/models/claude-opus-5-5확인 2026-10-04↩
- Artificial Analysis 기준 Qwen3.8 Max(0902)는 지능 지수 45점 · Artificial Analysis 는 이 모델의 크기를 비공개로 표기한다Qwen3.8 Max (0902) scores 45 on the Artificial Analysis Intelligence Indexhttps://artificialanalysis.ai/models/qwen3-8-max확인 2026-10-04Alibaba has not disclosed the model size or parameter count.https://artificialanalysis.ai/models/qwen3-8-max확인 2026-10-04↩
- Epoch AI 는 컴퓨트·전력·데이터를 더 들여 학습할수록 AI 성능이 꾸준히 좋아졌다고 정리했다(매개변수 개수만을 가리키지 않음)Training AI systems with more compute, power and data has consistently led to better performancehttps://epoch.ai/topics/scaling확인 2026-10-04↩
- The Next Web 은 Qwen3.8 27B 가 DeepSeek V4 Pro 에 거의 맞먹었다고 보도하면서, 일부 평가가 내부 평가이고 시험 조건이 같지 않아 승자 판정 근거로 약하다고 썼다some of the evaluations were internal, and that the test setups were not identical, so the numbers were poor grounds for declaring a winnerhttps://thenextweb.com/news/alibaba-qwen3-8-27b-local-frontier-model확인 2026-10-04nearly matched DeepSeek's V4-Prohttps://thenextweb.com/news/alibaba-qwen3-8-27b-local-frontier-model확인 2026-10-04↩
- arXiv 2609.27669(PREPRINT · 2026-09-23 제출)는 비슷한 크기의 소형 모델들이 정답률과 추론 경로 정확도에서 크게 달랐고 두 지표가 다른 모델을 앞세우기도 했다고 썼다similarly sized local models differ substantially in answer accuracy and path fidelity, with the two metrics sometimes favoring different modelshttps://arxiv.org/abs/2609.27669확인 2026-10-04↩