 P3T
AI에 GPU가 필요한 이유, 정작 막히는 곳은 메모리
행렬 곱셈은 GPU 가 맡지만, 답을 쓰는 동안의 병목은 메모리입니다
- 무슨 일
- AI 이야기에 그래픽카드와 HBM 이 늘 함께 나옵니다.
- 확인된 것
- H100 한 장의 메모리는 80GB, 대역폭은 초당 3.35테라바이트입니다.
- 왜 중요한가
- 계산만 빠른 장비는 답을 쓰는 구간에서 그대로 멈춰 섭니다.
- 오늘 할 일
- GPU 기사에서 연산 성능과 메모리를 갈라 읽습니다.
AI의 행렬 계산에는 GPU가 잘 맞고, 답을 한 토큰씩 만들 때는 메모리 용량과 대역폭도 중요합니다.
AI 이야기에는 그래픽카드, 즉 GPU가 늘 따라 나옵니다. 게임 화면을 그리던 장치가 왜 AI에 필요할까요? 이유는 계산의 모양에 있습니다. AI는 수많은 숫자를 같은 방식으로 한꺼번에 계산합니다. GPU는 바로 이런 일에 강합니다. 다만 답을 한 토큰씩 만드는 단계에서는 계산 능력만큼 메모리 속도도 중요합니다. 모델의 수많은 값을 메모리에서 빠르게 가져와야 하기 때문입니다.
AI 계산의 중심은 행렬 곱셈입니다
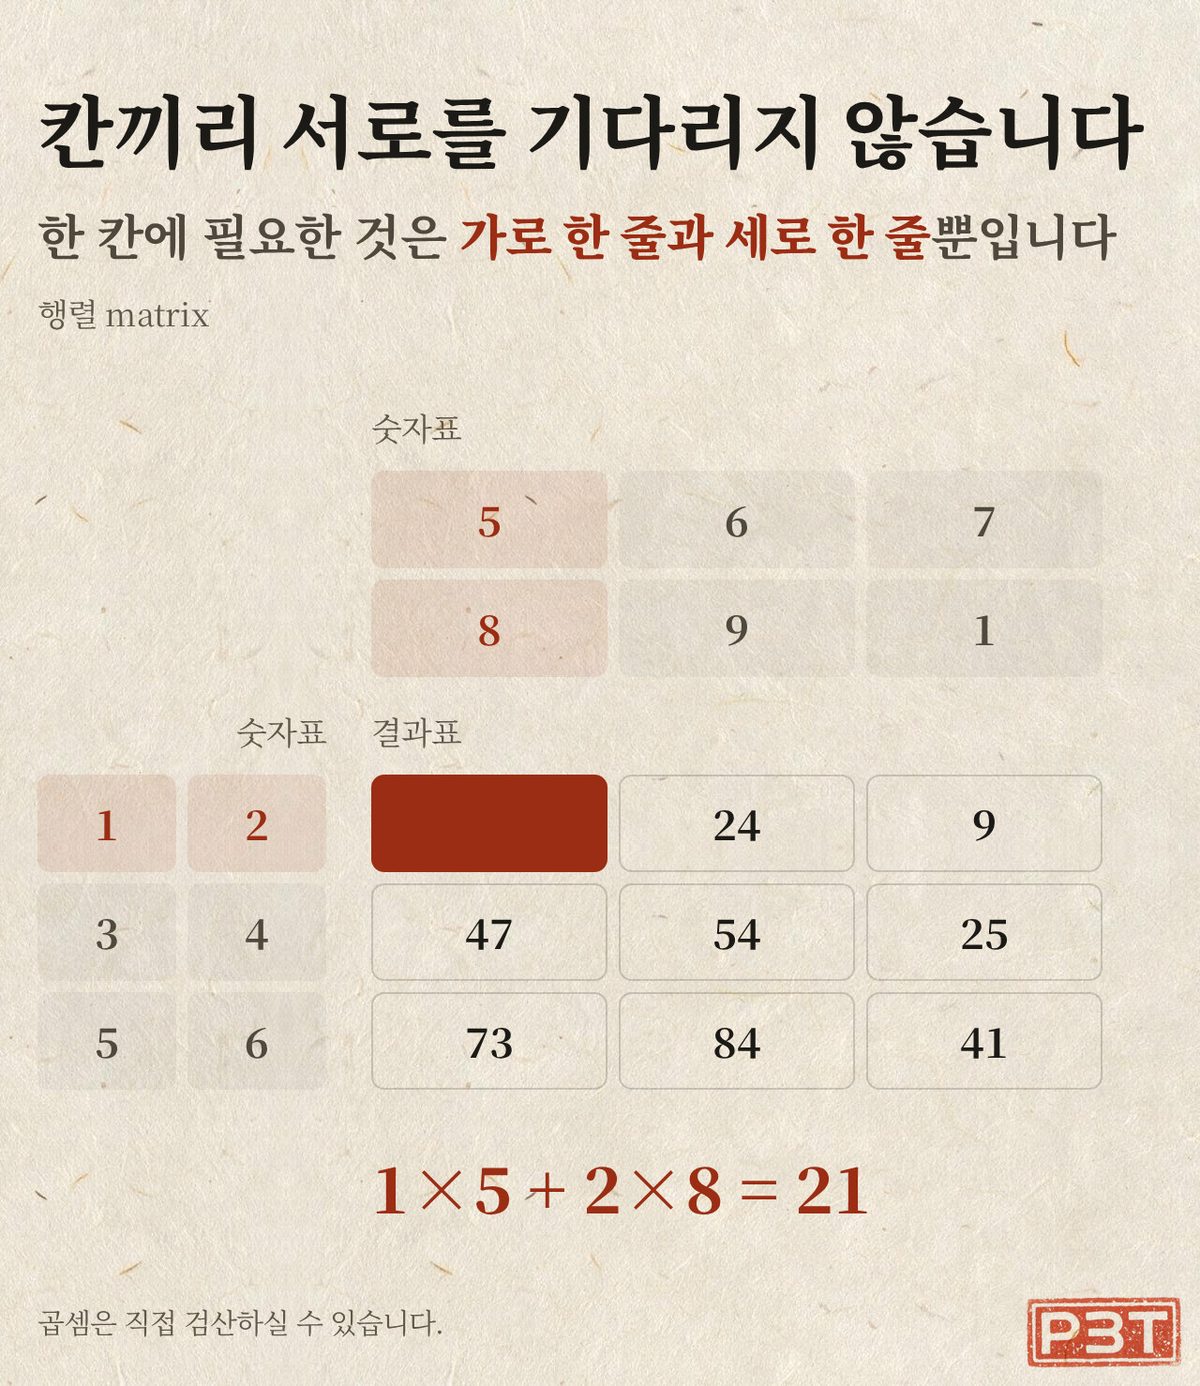
AI가 하는 계산의 큰 부분은 숫자가 담긴 표끼리 곱하는 일입니다.
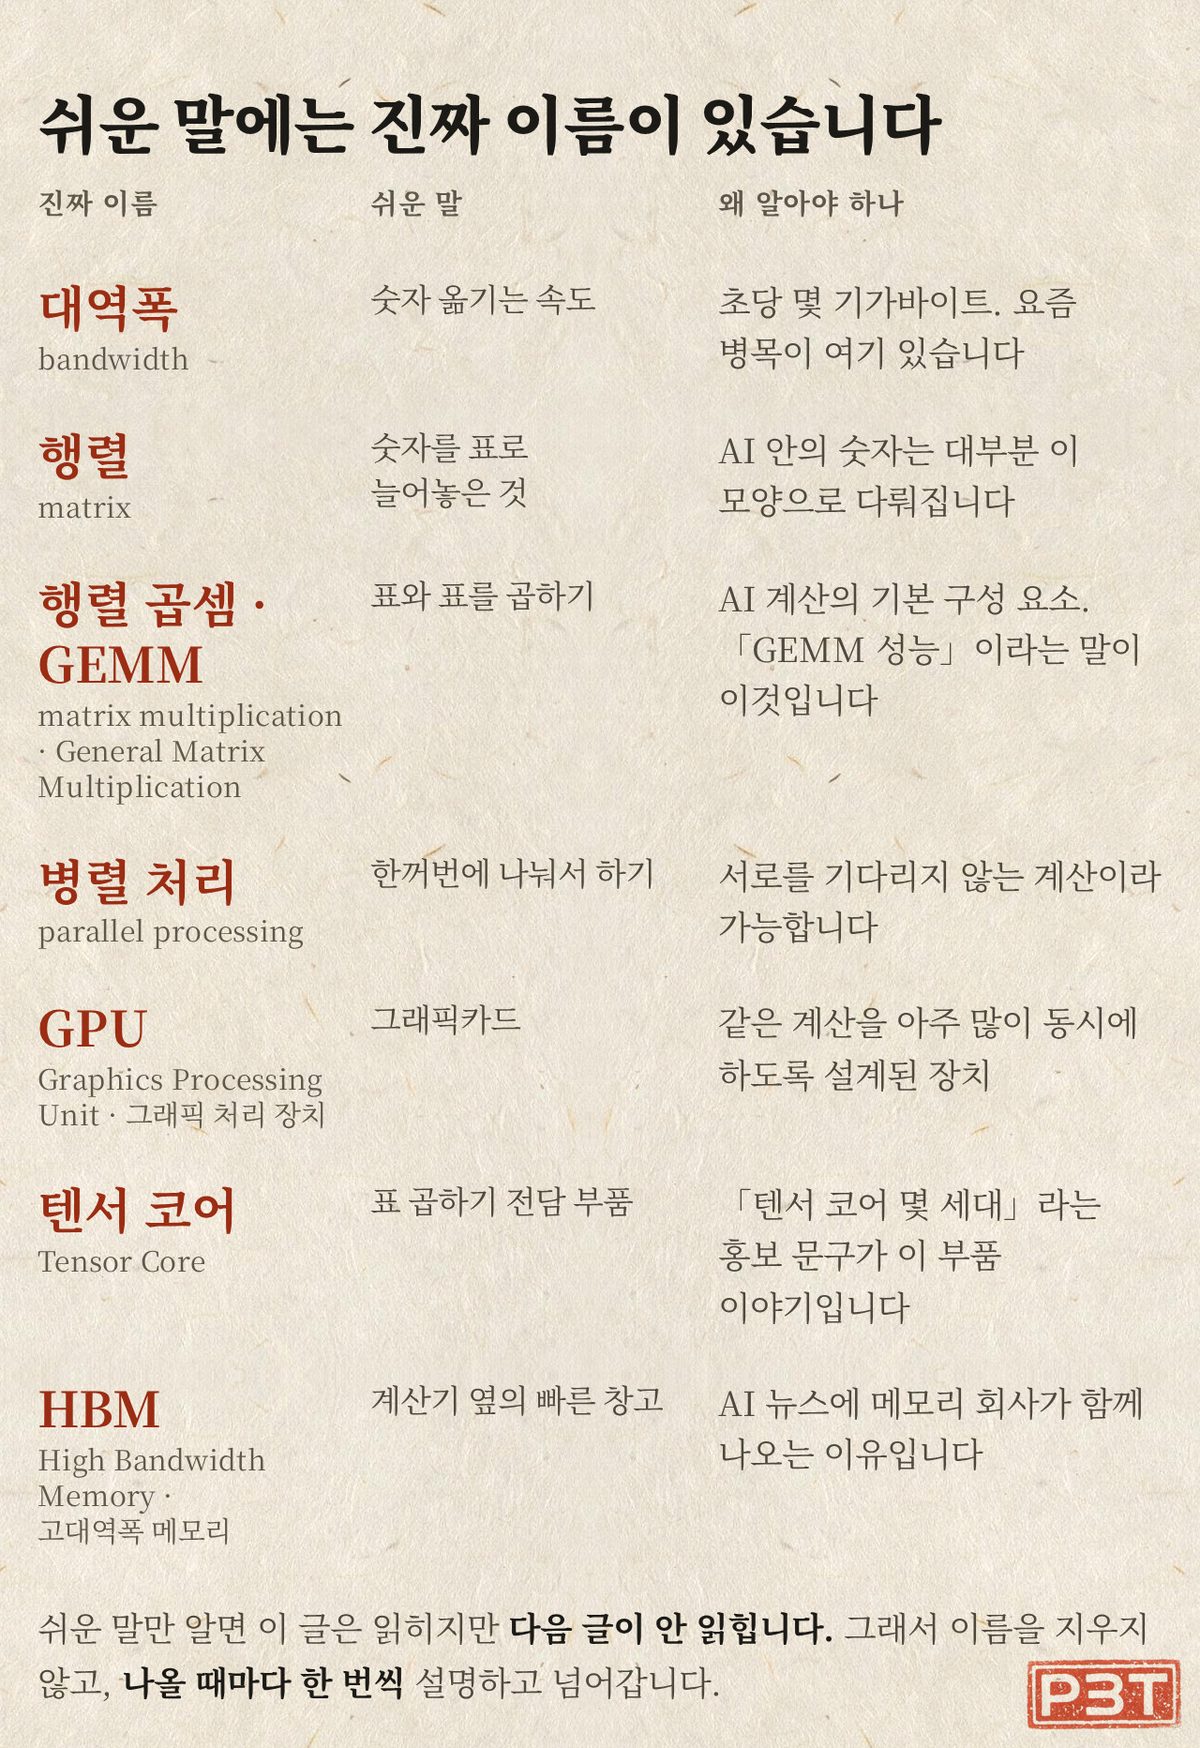
앞 편에서 토큰마다 숫자 묶음이 붙고, 어텐션이 그 숫자들을 비교해 섞는다고 했습니다. 이 숫자 묶음을 여러 줄로 쌓은 표를 행렬(matrix)이라고 합니다. 행렬끼리 곱하는 계산이 행렬 곱셈이며, 기술 문서에서는 GEMM이라는 이름도 자주 사용합니다.
엔비디아는 행렬 곱셈을 신경망의 여러 연산을 이루는 기본 요소로 설명합니다1. 실제 AI 성능 측정에서도 행렬 곱셈이 큰 비중을 차지합니다2.
행렬 곱셈은 많은 계산을 동시에 나눠 처리할 수 있습니다. 결과의 각 칸을 계산할 때 여러 곱셈과 덧셈이 필요하지만, 서로 다른 칸은 함께 계산할 수 있습니다. GPU가 AI에 잘 맞는 핵심 이유입니다.
그래서 GPU입니다
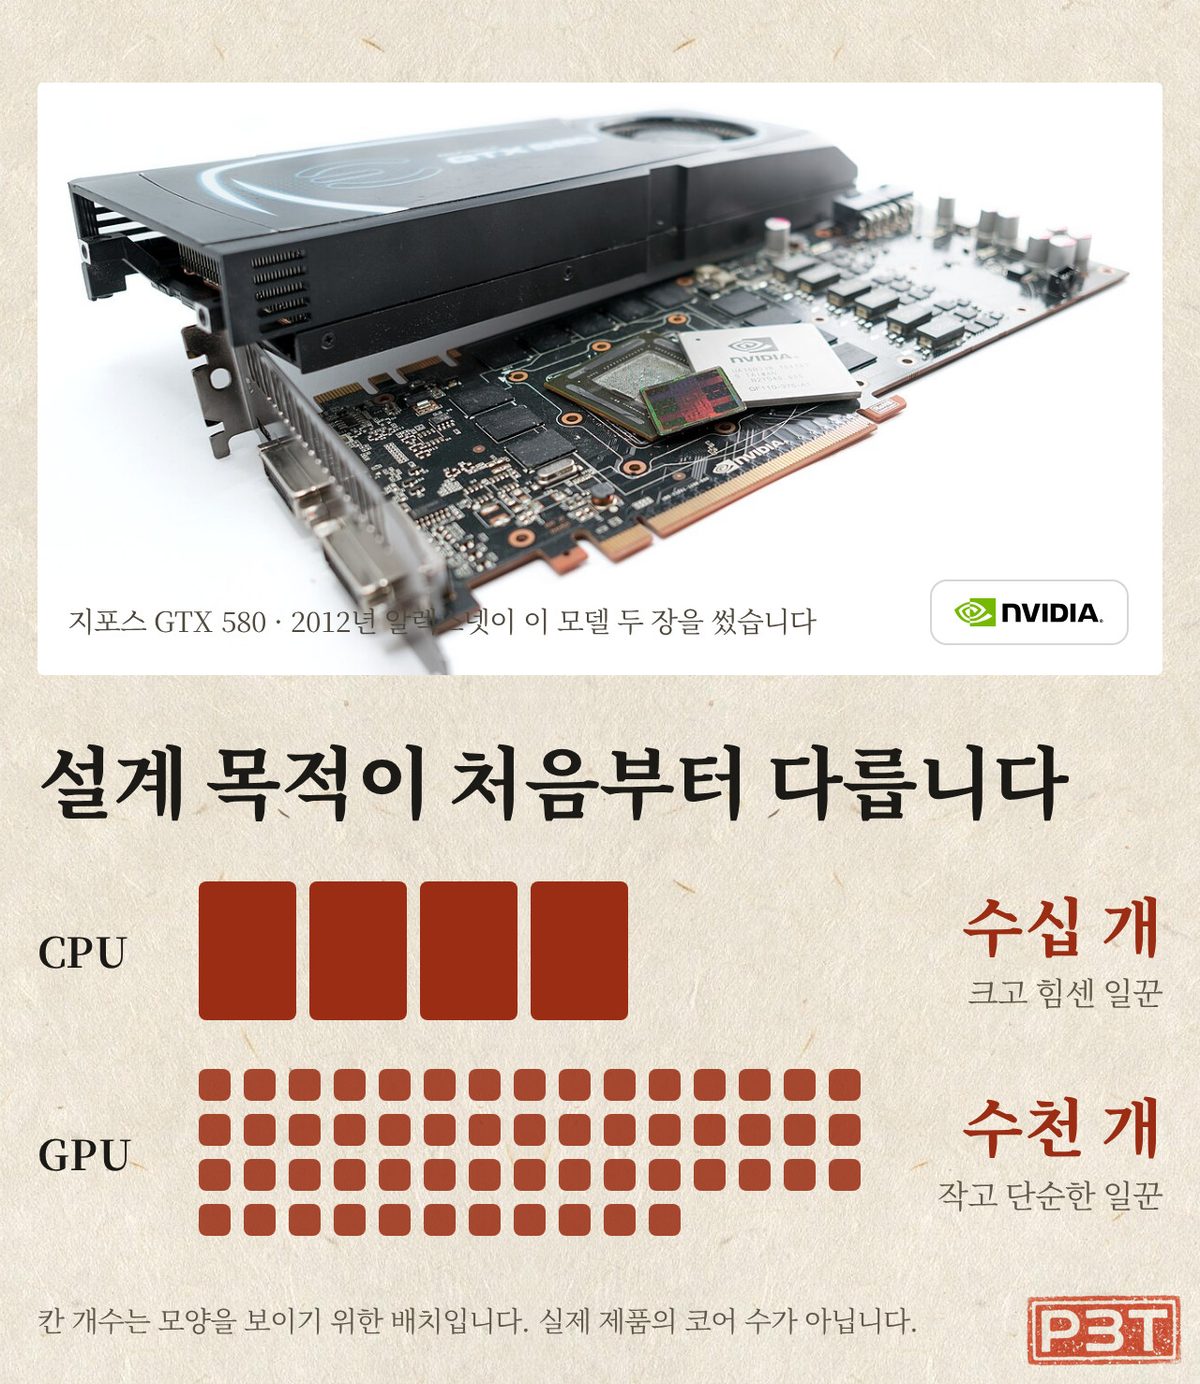
CPU는 복잡한 작업을 빠르게 차례로 처리하는 데 강합니다. GPU는 비교적 단순하고 비슷한 계산을 아주 많이 동시에 처리하도록 설계됐습니다. 엔비디아의 CUDA 문서도 CPU는 빠른 순차 처리에, GPU는 많은 작업을 동시에 처리하는 데 초점을 둔다고 설명합니다3.
GPU는 복잡한 흐름을 관리하는 부분보다 실제 계산을 수행하는 부분에 더 많은 자원을 사용합니다4. 게임 화면의 수많은 픽셀을 동시에 계산하도록 발전한 구조가 AI의 대규모 행렬 계산과도 잘 맞았습니다.
최근 GPU에는 행렬 계산을 위한 전용 장치도 들어 있습니다. 엔비디아는 텐서 코어(Tensor Core)를 행렬의 곱셈과 덧셈을 빠르게 처리하는 연산 장치라고 설명합니다5.
트랜스포머가 계산을 여러 갈래로 나누기 쉽다는 특성과 GPU의 구조가 여기서 만납니다. GPU는 이렇게 나눠진 계산을 동시에 처리할 수 있습니다. 트랜스포머와 GPU가 잘 맞는 이유입니다.
답을 쓰는 동안 병목은 계산이 아니라 메모리입니다
GPU의 계산 성능만 높이면 AI도 항상 빨라질까요? 그렇지는 않습니다.
AI가 긴 입력을 한꺼번에 읽을 때는 계산 성능이 중요합니다. 반면 답을 한 토큰씩 만들 때는 모델의 값을 메모리에서 가져오는 속도가 병목이 되기 쉽습니다. 특히 한 번에 처리하는 요청이 적을 때 이런 현상이 두드러집니다.
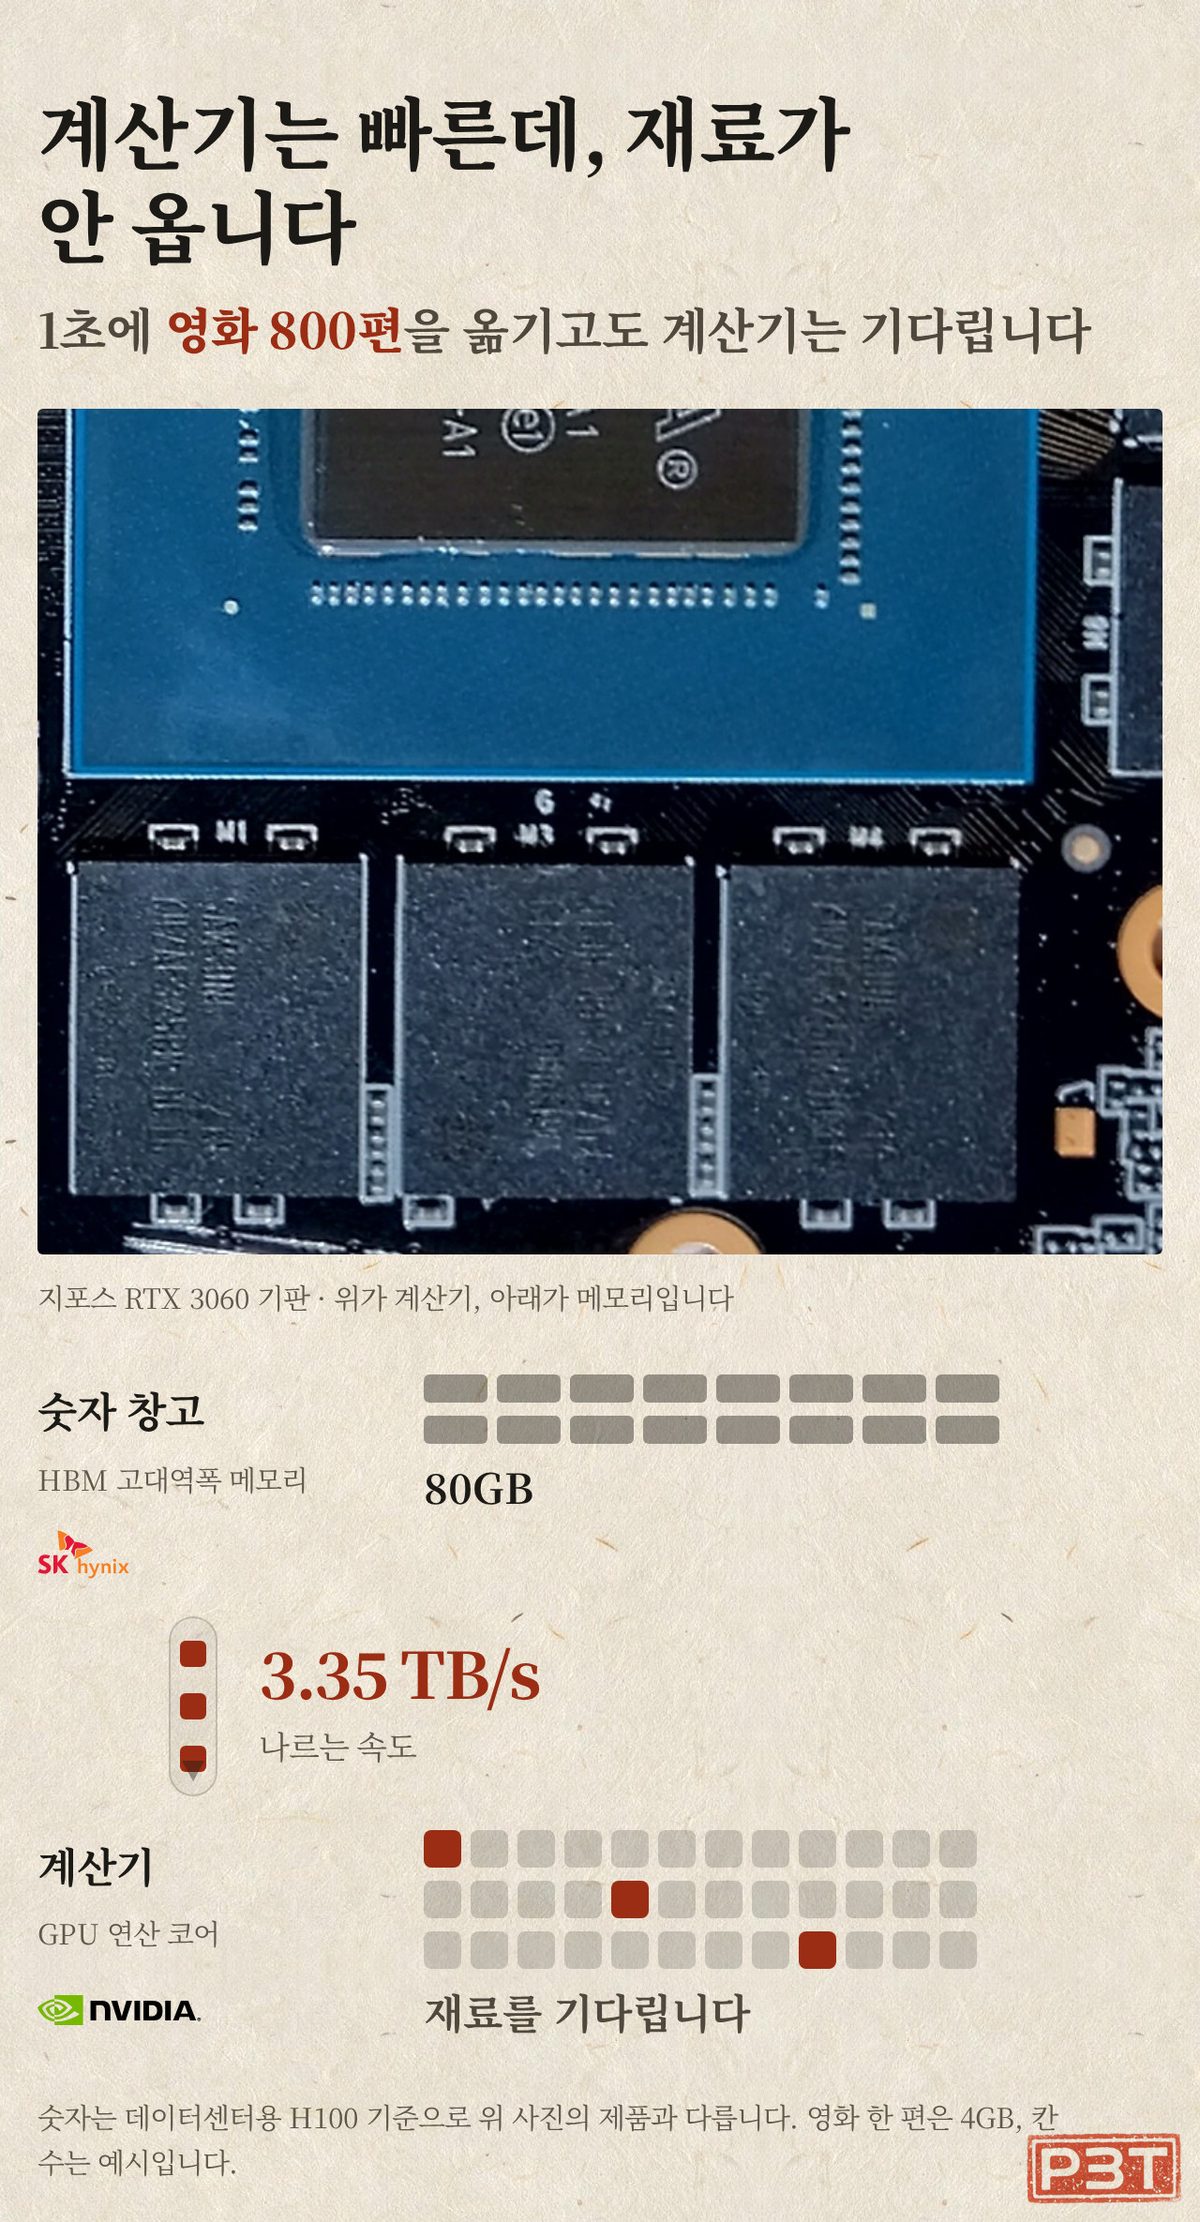
GPU는 모델의 수많은 숫자를 메모리에 저장해 두고 계산할 때마다 불러옵니다. 이때 1초 동안 옮길 수 있는 데이터의 양을 메모리 대역폭(bandwidth)이라고 합니다.
데이터센터용 AI GPU에는 주로 HBM(High Bandwidth Memory), 즉 고대역폭 메모리가 사용됩니다. 많은 데이터를 빠르게 옮기기 위해 만든 고대역폭 메모리입니다. 구글 연구진의 2022년 논문도 대규모 트랜스포머가 토큰을 생성하는 과정에서 메모리 대역폭의 제약을 받을 수 있다고 설명합니다6.
암산을 잘하는 사람들에게 문제지를 나눠 주는 장면을 떠올려 보세요. 계산은 순식간에 끝나지만 문제지를 나눠 주는 속도가 느리다면 전체 작업은 느려집니다. GPU의 연산 장치와 메모리 사이에서도 비슷한 일이 생깁니다.
숫자를 보면 감이 옵니다. 데이터센터용 H100 GPU의 메모리는 80GB입니다7. 같은 H100의 SXM 모델은 메모리 대역폭이 초당 3.35테라바이트라고 엔비디아가 적어 뒀습니다8. 영화 한 편을 4기가바이트로 잡으면 1초에 팔백 편 넘게 옮기는 속도입니다. 빠른 값이지만, 거대한 모델의 수많은 값을 토큰마다 불러오기에는 여전히 부족할 수 있습니다.
그래서 무엇이 달라지나
AI 뉴스에 GPU와 HBM이 함께 등장하는 이유가 여기에 있습니다.
엔비디아, 삼성전자, SK하이닉스 이야기가 계속 나오는 것은 브랜드 때문이 아닙니다. GPU는 행렬 계산을 동시에 많이 처리하고, HBM은 그 계산에 필요한 숫자를 빠르게 공급합니다. 계산 장치만 빨라도 안 되고, 메모리만 빨라도 안 됩니다. 둘 사이의 균형이 중요합니다.
AI가 답을 한 토큰씩 이어 쓰는 속도에도 메모리 대역폭이 영향을 줍니다. 다만 서비스 속도는 요청 수, 모델 크기, 네트워크, 서버 설정에도 달려 있으므로 느린 원인을 메모리 하나로만 단정할 수는 없습니다.
개인 컴퓨터에 큰 모델을 올릴 때는 GPU 메모리 용량이 먼저 문제가 되는 경우가 많습니다. 모델의 숫자와 계산 중 생기는 데이터를 메모리에 담아야 하기 때문입니다. 용량이 부족하면 더 작은 모델을 쓰거나 숫자의 정밀도를 낮추는 방법이 필요합니다. 이 내용은 마지막 편에서 다시 봅니다.
실물이 궁금하다면 엔비디아 H200 제품 페이지에서 최신 AI용 GPU와 HBM 구성을 볼 수 있습니다.
nvidia.com/en-us/data-center/h200
HBM이 어떻게 발전하는지는 SK하이닉스가 공개한 12단 HBM4 샘플 출하 자료에서도 확인할 수 있습니다. CPU와 GPU의 설계 차이는 docs.nvidia.com의 CUDA 프로그래밍 가이드에 설명돼 있습니다.
다음 편에서는 AI가 이런 계산에 필요한 숫자를 어떻게 갖게 되는지, 학습 과정을 살펴봅니다.
읽고 나서 해 볼 것
AI 기사에서 「HBM」이나 「대역폭」이라는 말이 나오면 계산기 속도 이야기가 아닙니다. 계산할 숫자를 얼마나 많이 담고 얼마나 빠르게 옮기는지에 대한 말로 읽어 보세요.
출처
각주 8개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 엔비디아 공식 문서는 행렬 곱셈(GEMM)을 신경망 여러 연산의 기본 구성 요소라고 적는다GEMMs (General Matrix Multiplications) are a fundamental building block for many operations in neural networks, for example fully-connected layers, recurrent layers such as RNNs, LSTMs or GRUs, and convolutional layers.https://docs.nvidia.com/deeplearning/performance/dl-performance-matrix-multiplication/index.html확인 2026-09-02↩
- 엔비디아 기술 글은 AI와 머신러닝 벤치마크 연산의 상당 부분이 행렬 곱셈이라고 적는다A significant fraction of operations in AI and machine learning benchmarks are general matrix multiplications (GEMMS), which are also referred to as matmul functions.https://developer.nvidia.com/blog/new-cublas-12-0-features-and-matrix-multiplication-performance-on-nvidia-hopper-gpus/확인 2026-09-02↩
- 엔비디아 개발 문서는 CPU가 한 줄기 작업을 최대한 빨리 해내도록, GPU는 수천 줄기를 동시에 해내도록 설계됐다고 적는다While the CPU is designed to excel at executing a sequence of operations, called a thread, as fast as possible and can execute a few tens of these threads in parallel, the GPU is designed to excel at executing thousands of them in parallel.https://docs.nvidia.com/cuda/cuda-c-programming-guide/확인 2026-09-02↩
- 같은 문서는 GPU가 데이터 저장이나 흐름 통제보다 계산 처리에 더 많은 트랜지스터를 배정하도록 설계됐다고 적는다The GPU is specialized for highly parallel computations and therefore designed such that more transistors are devoted to data processing rather than data caching and flow control.https://docs.nvidia.com/cuda/cuda-c-programming-guide/확인 2026-09-02↩
- 엔비디아는 텐서 코어를 행렬 곱셈과 누산 연산을 위한 특화 고성능 연산 코어라고 설명한다Tensor Cores are specialized high-performance compute cores for matrix multiply and accumulate (MMA) math operations that provide groundbreaking performance for AI and HPC applications.https://developer.nvidia.com/blog/nvidia-hopper-architecture-in-depth/확인 2026-09-02↩
- 구글 연구진의 2022년 논문은 토큰 하나를 만들 때마다 칩 밖 메모리에서 저장 값을 불러와야 하고 그동안 칩의 계산 코어가 사실상 논다고 적었다The on-chip memory needs to load this KV cache from off-chip memory once for every token generated during which the computational core of the chip is essentially idle.https://arxiv.org/abs/2211.05102확인 2026-09-02↩
- 엔비디아 H100 한 장의 GPU 메모리는 80GB 다GPU Memory — 80GBhttps://www.nvidia.com/en-us/data-center/h100/확인 2026-09-02NVIDIA H100 SXM GPUshttps://docs.cloud.google.com/compute/docs/gpus확인 2026-09-02↩
- 엔비디아는 H100 SXM 의 메모리 대역폭을 초당 3.35테라바이트로 적는다GPU Memory Bandwidth — 3.35TB/shttps://www.nvidia.com/en-us/data-center/h100/확인 2026-09-02↩