 P3T
AI 학습 원리, 「틀렸어」 해도 바로 안 배우는 이유
그 말은 지금 대화에만 반영됩니다 — 모델 안의 값은 그대로입니다
- 무슨 일
- AI 에게 「그건 틀렸어」라고 말하면 다음 답이 달라집니다.
- 확인된 것
- 대화할 때 AI 는 학습을 마친 값을 고정한 채 답만 만듭니다.
- 왜 중요한가
- 고쳐 놨다고 믿은 것이 새 창에서는 다시 그대로 돌아옵니다.
- 오늘 할 일
- 고쳐야 할 지시는 대화가 아니라 프롬프트에 적어 둡니다.
AI 학습은 틀린 정도를 손실로 만들고, 그 손실이 줄어들도록 내부 값을 반복해서 바꾸는 과정입니다.
AI가 이상한 답을 내면 「그거 틀렸어」라고 말하고 싶어집니다. AI는 그 말을 참고해 현재 대화에 반영하고 다음 답을 고칠 수는 있습니다. 하지만 일반적인 대화 한 번으로 모델 내부의 값이 바뀌지는 않습니다. 모델을 학습시키려면 무엇이 얼마나 틀렸는지, 그리고 내부 값을 어느 방향으로 얼마나 바꿀지를 숫자로 계산해야 합니다. 오늘은 이 과정을 살펴봅니다.
먼저, 얼마나 틀렸는지를 숫자로 만듭니다
AI 학습은 답이 정답에서 얼마나 벗어났는지 숫자로 재고, 그 숫자가 작아지도록 내부 값을 조금씩 바꾸는 일을 반복하는 과정입니다.
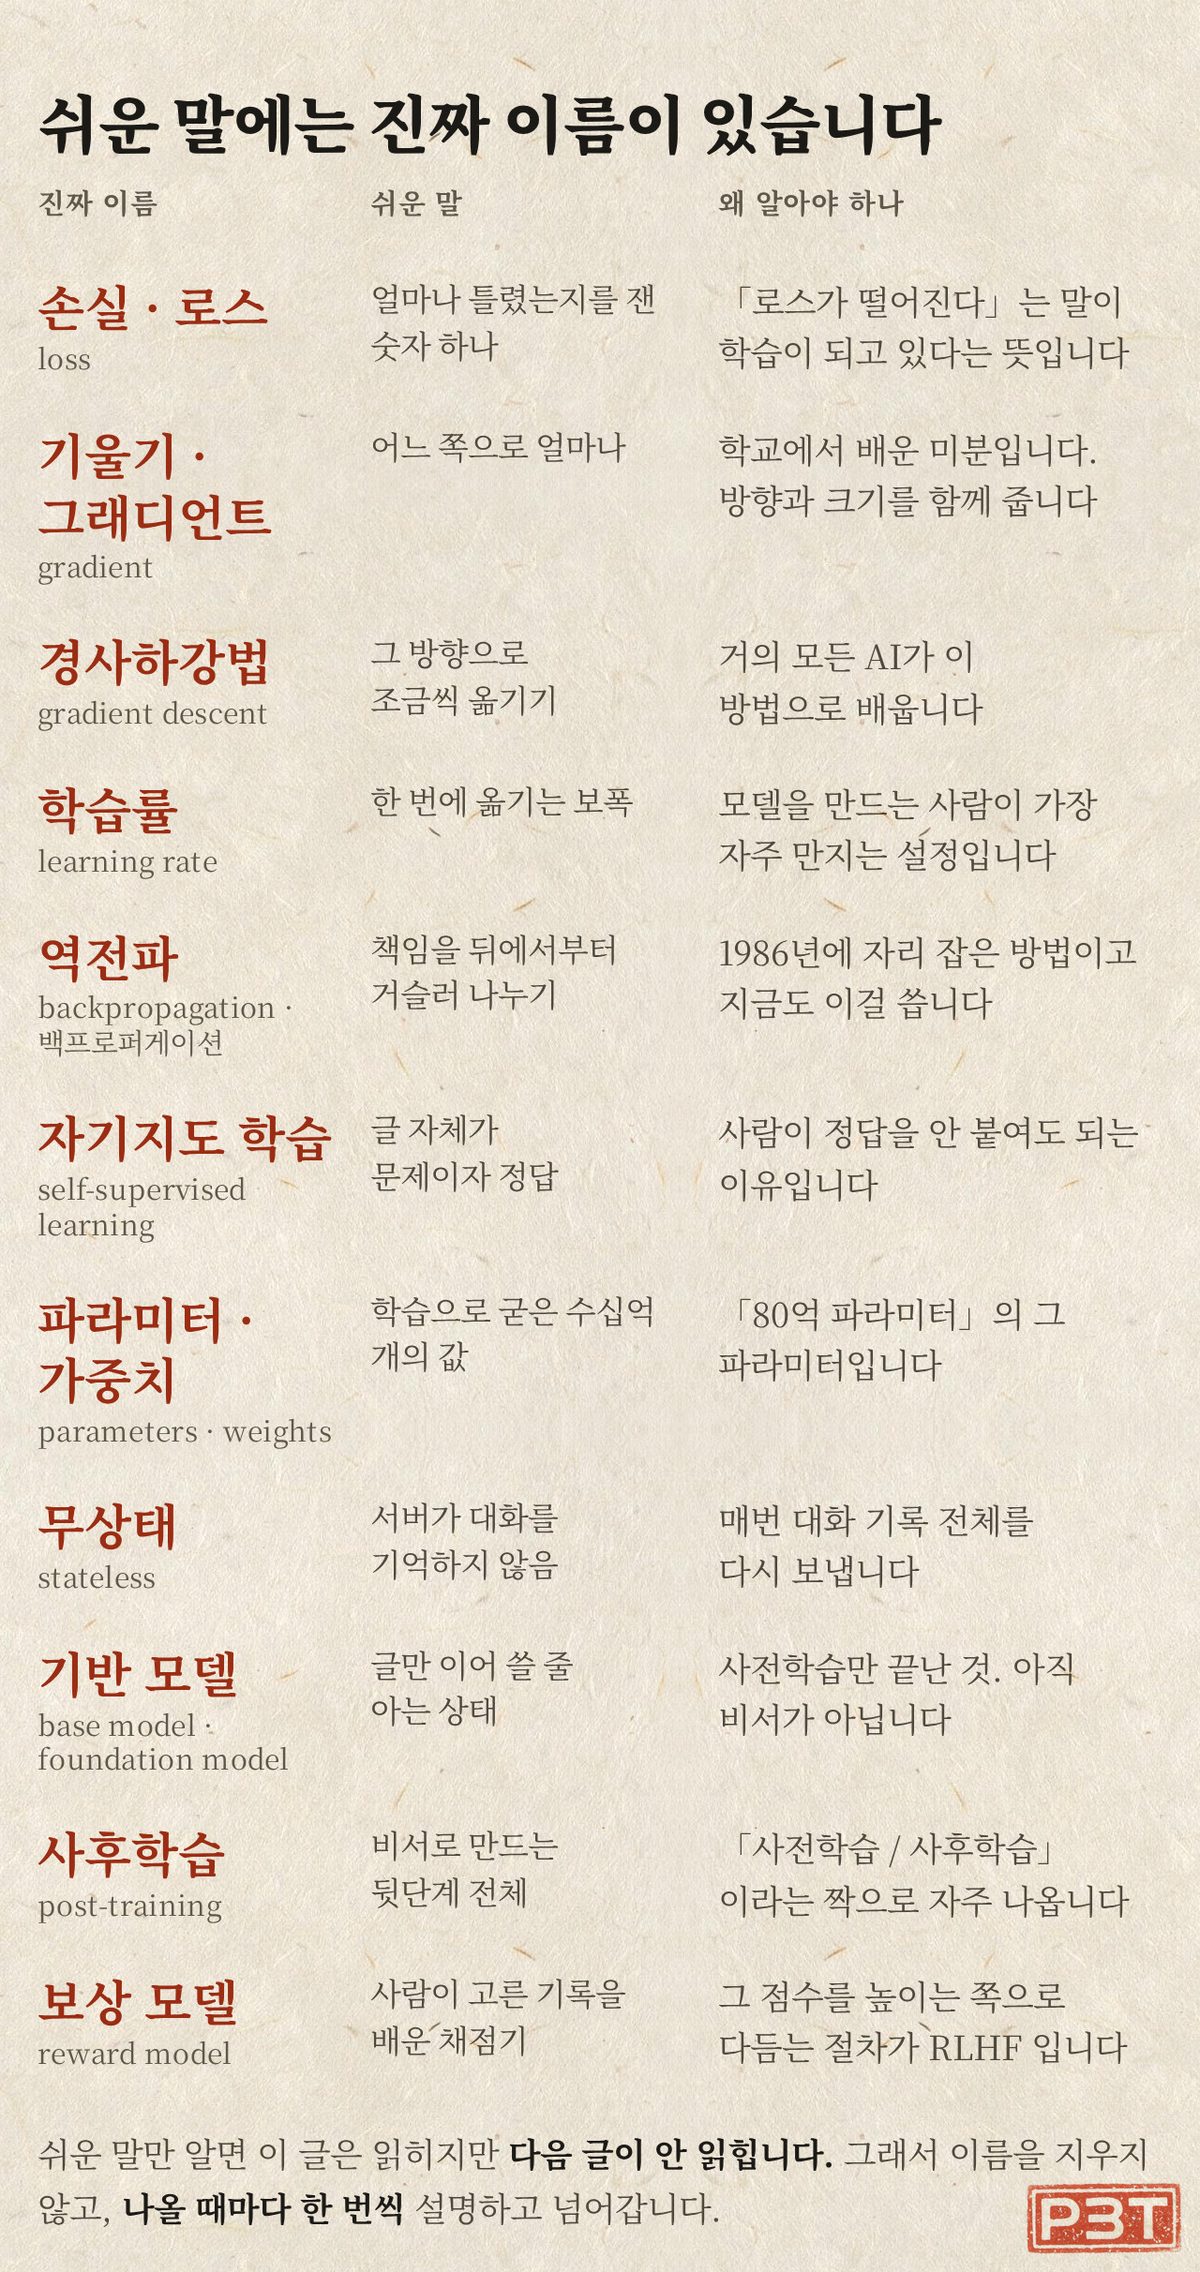
틀린 정도를 나타내는 숫자를 손실(loss)이라고 합니다. 파이토치는 손실 함수가 예측값과 정답의 차이를 측정하며, 학습은 이 값을 줄이는 과정이라고 설명합니다1.
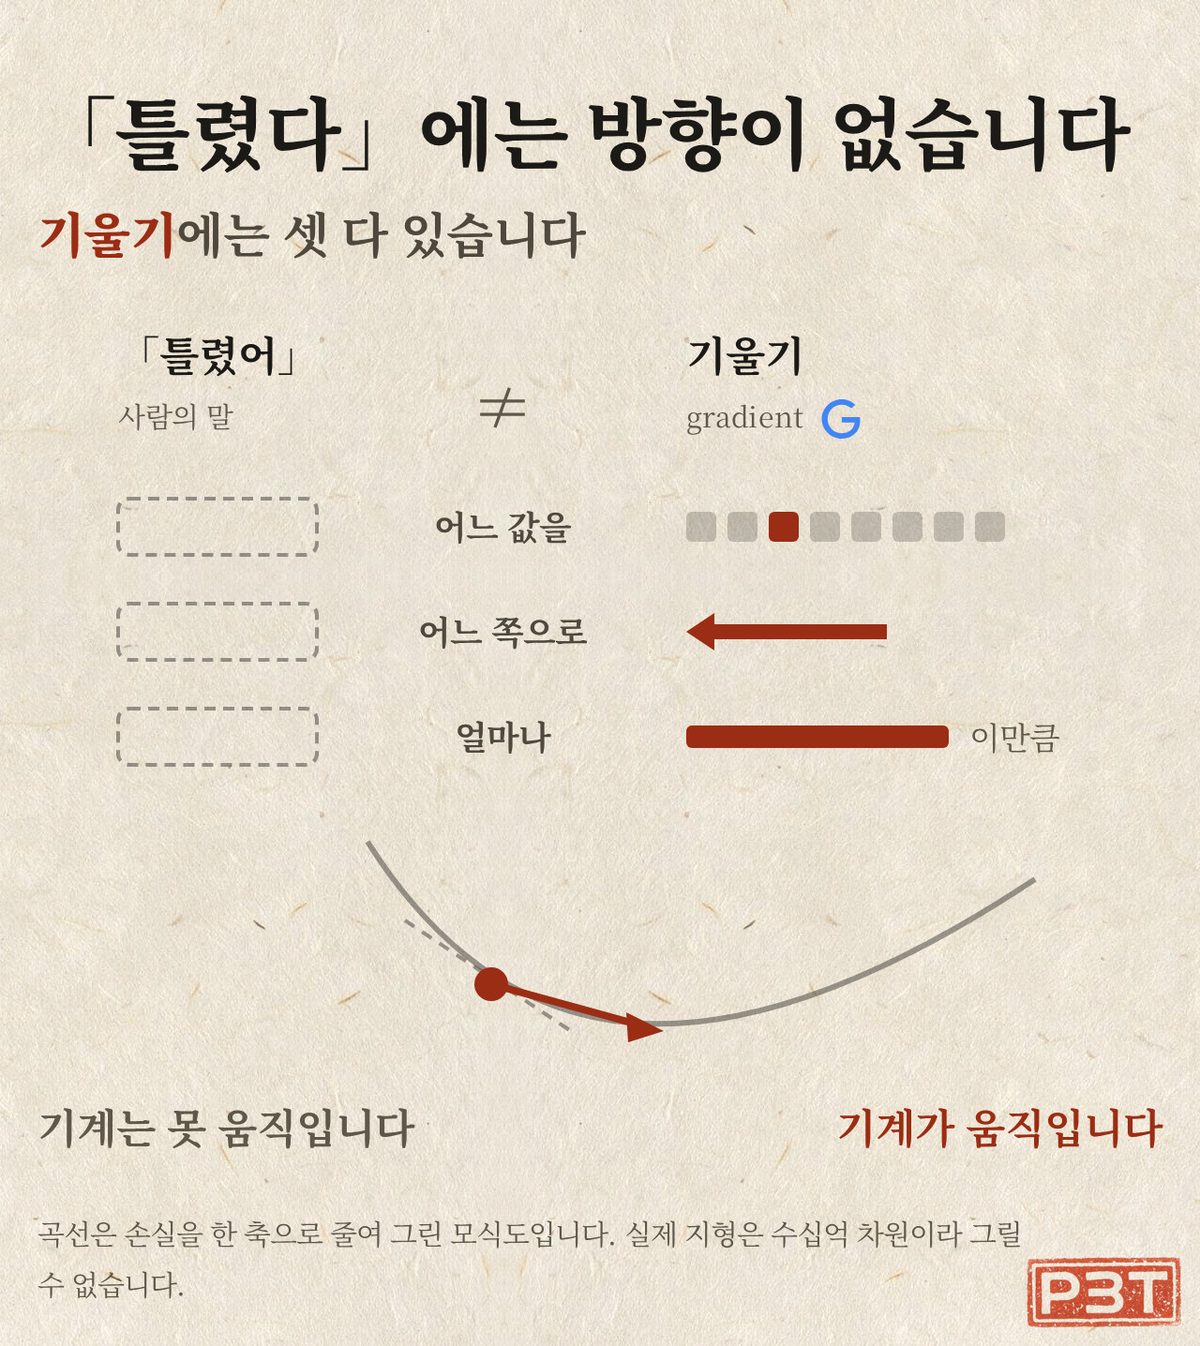
왜 숫자로 바꿀까요? 「이 부분은 어색하고 저기는 사실이 틀렸다」는 말은 사람에게는 통하지만 AI에게는 통하지 않습니다. 말로는 수십억 개나 되는 AI 모델의 내부 값 가운데 무엇을 어느 쪽으로 얼마나 바꿀지 계산할 수 없기 때문입니다.
손실을 구하는 방법은 여러 가지입니다. 예를 들어 숫자를 예측할 때는 정답과의 차이를 제곱해 더할 수 있습니다. 차이를 제곱하면 양수와 음수가 서로 지워지지 않습니다.
다음 토큰을 맞히는 언어 모델은 주로 교차 엔트로피(cross-entropy)를 사용합니다. 정답 토큰에 낮은 확률을 줄수록 손실이 커지고, 높은 확률을 줄수록 작아집니다.
다음 토큰 학습에서는 원문이 곧 정답지가 됩니다. 글의 뒷부분을 가리고 앞부분만 보여 준 뒤, 바로 다음 토큰을 맞히게 하는 방법입니다. 사람이 문제마다 정답을 따로 만들지 않아도 많은 글을 학습 자료로 사용할 수 있습니다.
2019년 오픈AI 논문도 앞부분 토큰들을 보고 다음 토큰이 나올 확률(조건부 확률)을 구한 뒤, 그 확률들을 차례로 곱해 글 전체의 확률을 만드는 방식이 언어 모델에서 일반적이라고 적었습니다2.
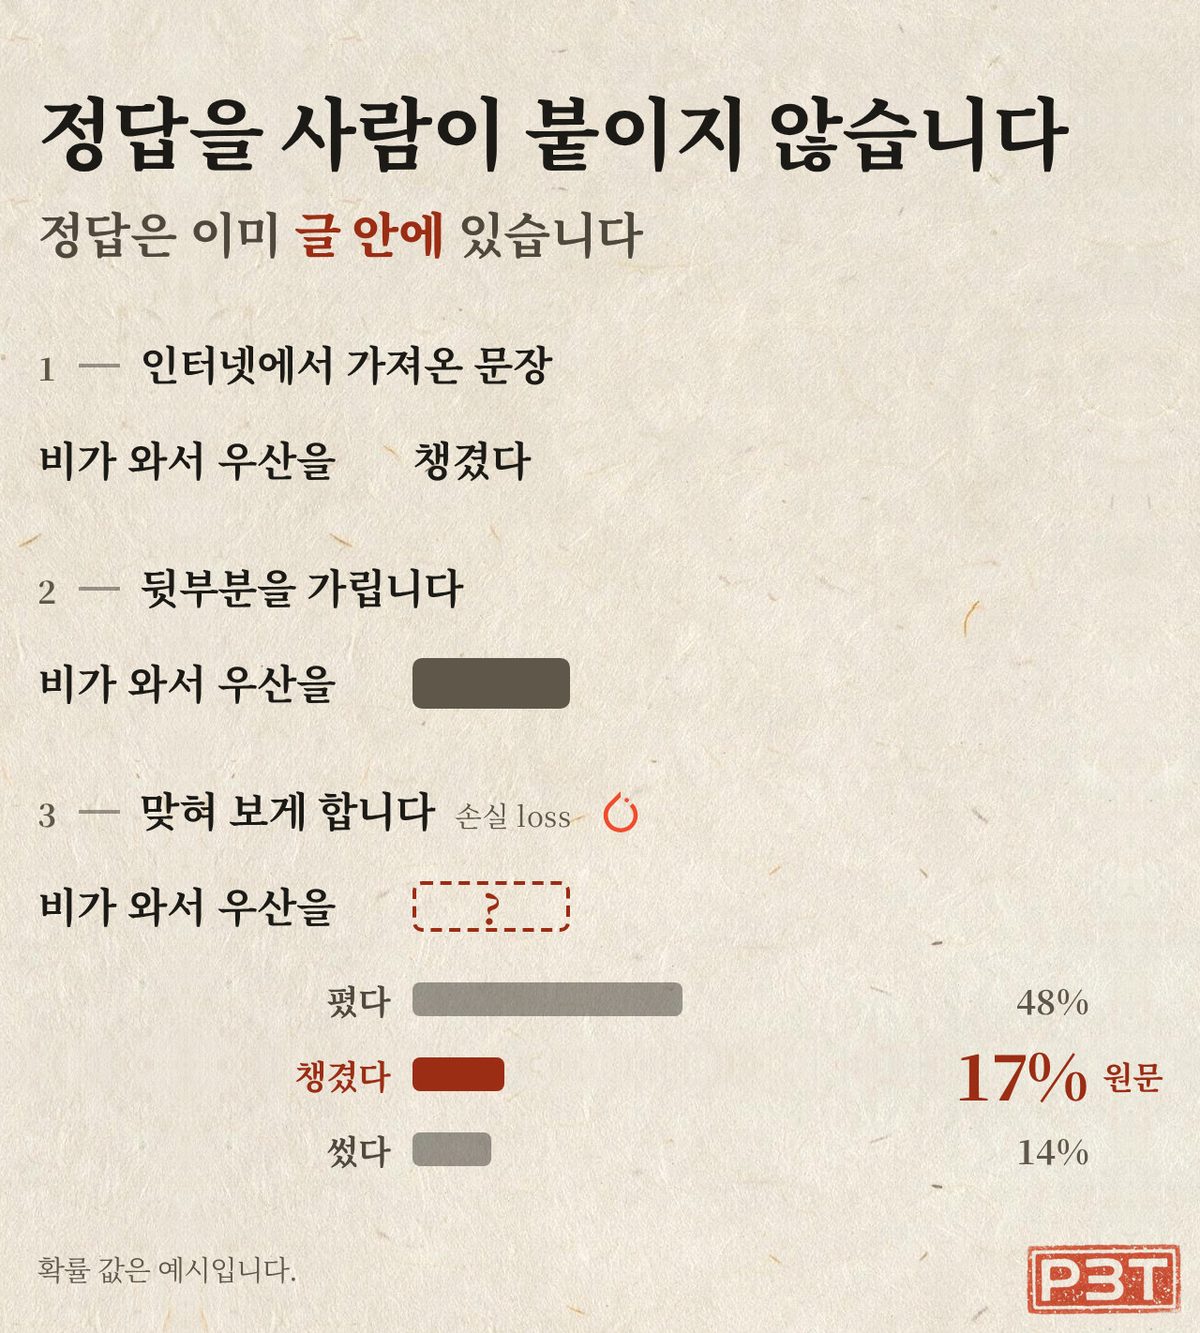
어느 방향으로 얼마나 바꿀까요?
손실을 줄이려면 두 가지를 알아야 합니다. 내부 값을 어느 쪽으로, 얼마나 움직일지.
AI 안에서 학습을 통해 조정되는 숫자를 파라미터(parameter)라고 합니다. 가중치와 편향이 대표적입니다. 「700억 파라미터 모델」이라는 말은 이런 조정값이 약 700억 개 있다는 뜻입니다.
파라미터를 조금 바꿨을 때 손실이 어떻게 달라지는지를 나타내는 값이 기울기(gradient)입니다. 구글의 머신러닝 강의도 기울기가 손실이 커지는 방향을 가리키면, 그 반대쪽으로 파라미터를 움직이면 손실을 줄일 수 있다고 설명합니다3.
이를 경사하강(gradient descent)이라고 합니다. 한 번에 얼마나 움직일지는 학습률(learning rate)이 정합니다. 너무 작으면 학습이 느리고, 너무 크면 좋은 지점을 지나쳐 학습이 불안정해질 수 있습니다.
문제는 파라미터가 수십억 개에 이른다는 점입니다. 각 파라미터가 손실에 미친 영향을 모두 계산해야 합니다.
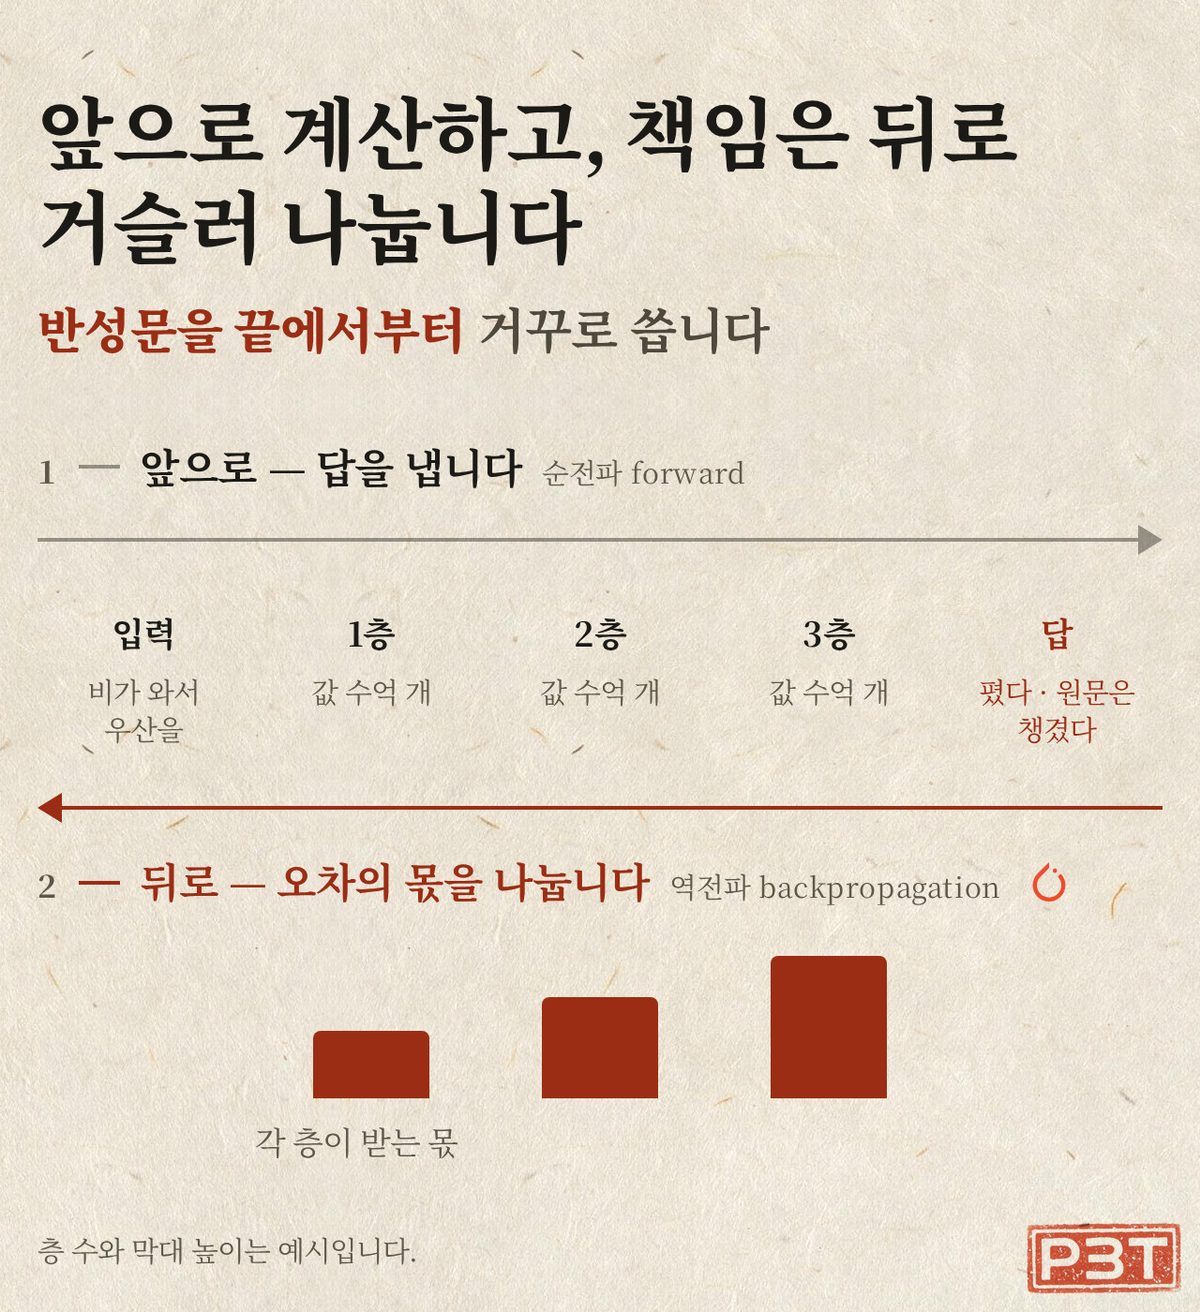
이때 사용하는 방법이 역전파(backpropagation)입니다. 먼저 입력에서 출력 방향으로 계산해 답과 손실을 구합니다. 그다음 계산 과정을 뒤에서부터 거슬러 올라가며 각 파라미터의 기울기를 구합니다4.
쉽게 말하면 결과가 틀렸을 때 마지막 단계만 나무라지 않고, 「넌 뭘 했냐」를 뒤에서부터 한 단계씩 되짚어 가며 각자의 몫을 적어 주는 일입니다. 반성문을 끝에서부터 거꾸로 쓰는 셈입니다.
전체 흐름을 정리하면 이렇습니다. 답을 만들고, 손실을 재고, 역전파로 기울기를 구한 뒤, 파라미터를 조금 바꿉니다. AI는 데이터 묶음을 바꿔가며 이 과정을 수없이 반복합니다.
여기까지 만든 것은 아직 아이언맨의 자비스 같은 AI 비서가 아닙니다
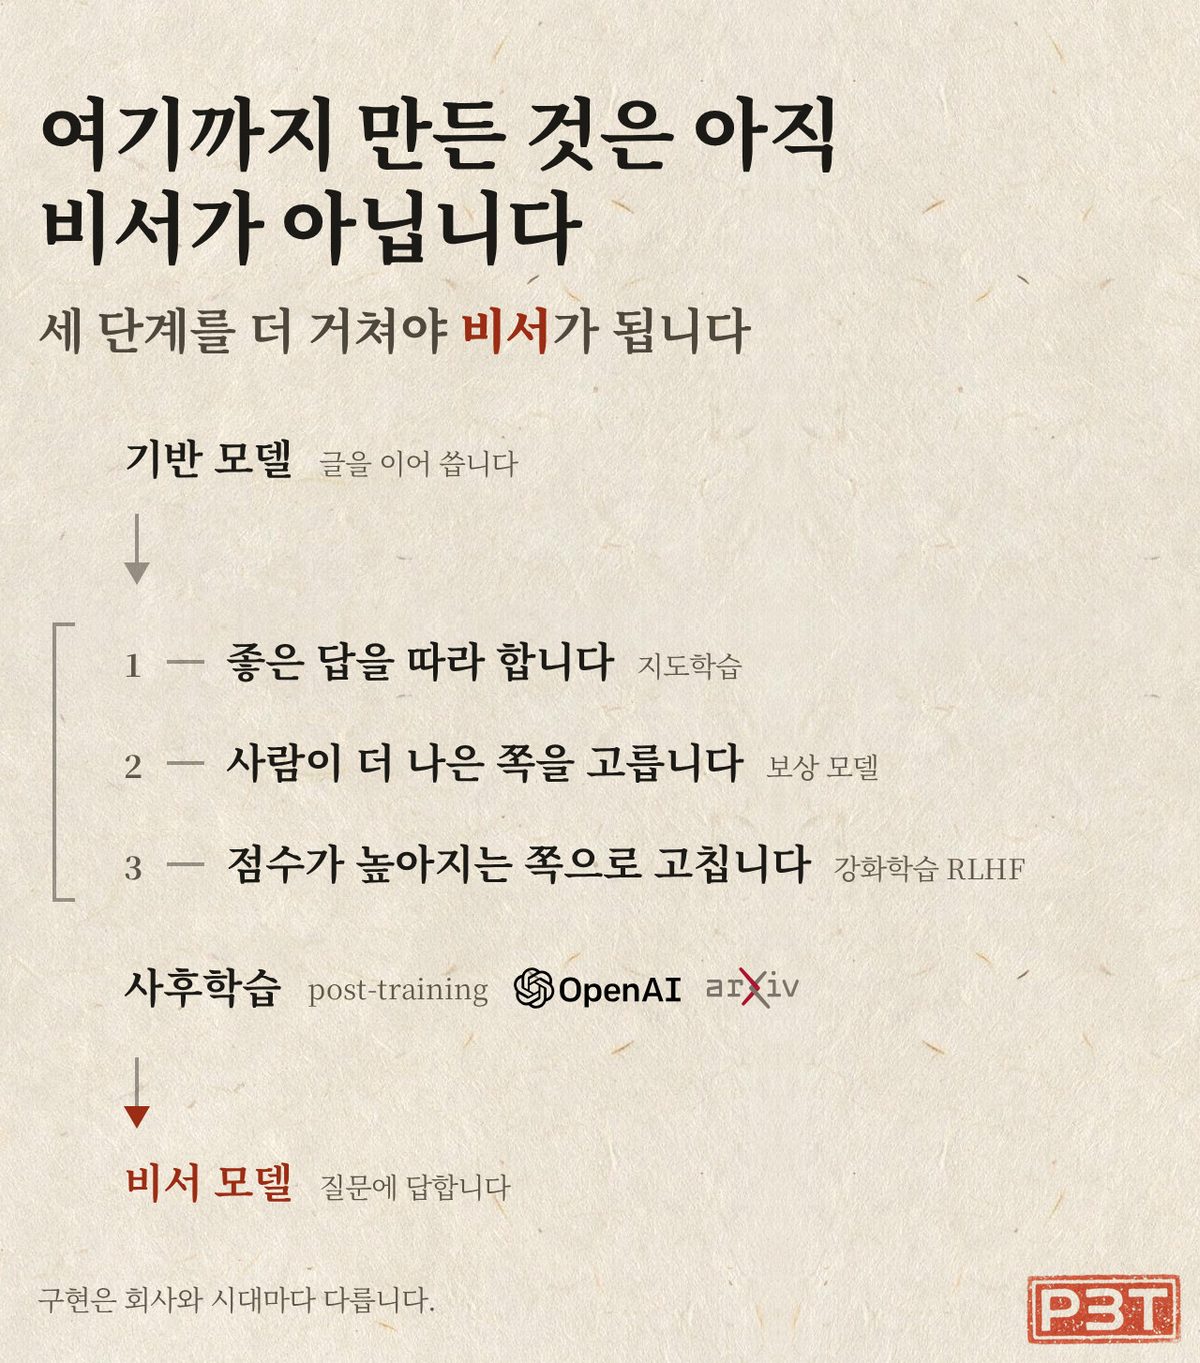
여기가 많은 분이 놀라시는 대목입니다. 지금까지 만든 것은 다음 토큰을 잘 예측하는 모델이지, 아직 사용자의 요청을 잘 따르는 비서가 아닙니다.
이런 초기 상태를 기반 모델(base model)이라고 부릅니다. 질문을 입력해도 답을 하는 대신, 비슷한 질문을 이어 쓰거나 인터넷 글의 다음 문장처럼 내용을 계속 만들 수 있습니다.
2022년 오픈AI 논문이 이 문제를 정면으로 다뤘습니다. 첫 문장이 이렇습니다. 언어 모델을 더 크게 만든다고 해서 그 자체로 사용자의 의도를 더 잘 따르게 되지는 않는다5.
그래서 기반 모델을 만든 뒤 사후학습(post-training)을 거칩니다. 당시 연구진은 InstructGPT에 사람이 작성한 좋은 답을 먼저 보여 주며 지도학습으로 조정했습니다. 다음에는 모델이 만든 여러 답을 사람이 비교하고, 어느 답이 더 나은지 고르게 했습니다6.
이 선호 자료로 보상 모델(reward model)을 만든 뒤, 더 높은 보상을 받는 답을 생성하도록 언어 모델을 조정했습니다. 이를 사람 피드백 기반 강화학습(RLHF)이라고 합니다.
연구진이 수집한 질문 모음으로 평가했을 때는, 사람들은 13억 파라미터 InstructGPT의 답을 1,750억 파라미터 GPT-3의 답보다 더 많이 선택됐습니다7. 파라미터 크기가 100배 이상 작아도 사용자의 요청에는 더 잘 맞을 수 있었던 것입니다.
그렇다고 모든 능력이 더 뛰어났다는 뜻은 아닙니다. 특정 질문에 대한 답을 사람이 비교한 결과입니다. 논문은 기존 공개 평가의 성능도 크게 떨어뜨리지 않았다고 보고했습니다8.
많이 아는 것과 사용자의 요청에 맞게 답하는 것은 서로 다른 능력입니다.
대화 중에는 모델이 새로 학습하지 않습니다
여기까지가 모델을 만드는 과정입니다. 사용자가 AI와 대화할 때는 이 학습 과정이 돌아가지 않습니다. 학습을 마친 모델의 파라미터를 고정한 채 답을 만드는 과정을 추론(inference)이라고 합니다.
대화 중 「그건 틀렸어」라고 말하면 AI는 그 내용을 참고해 현재 대화 안에서 다음 답을 고칠 수는 있습니다. 하지만 그 말만으로 모델의 파라미터가 새로 학습되지는 않습니다. 서비스가 대화를 저장했다가 나중에 학습 자료로 사용하는 것은 별도의 과정입니다.
대화 중에 배우지 않는다는 것은 다른 데서도 드러납니다. 앤트로픽 공식 문서는 메시지 API가 기본적으로 무상태(stateless)라서 매번 대화 기록 전체를 보내야 한다고 적습니다9. 이전 대화를 이어 가려면 필요한 대화 내용을 매번 다시 보내야 합니다.
다만 일반 사용자용 서비스는 대화 기록이나 메모리를 따로 저장했다가 다음 대화에 다시 넣어 줄 수 있습니다. 이것도 모델의 파라미터가 대화하면서 바뀐 것과는 다른 방식입니다.
역전파를 직접 보고 싶다면 안드레이 카파시의 micrograd를 추천합니다. 약 100줄의 핵심 코드로 자동 미분을 구현한 교육용 프로젝트입니다.
github.com/karpathy/micrograd
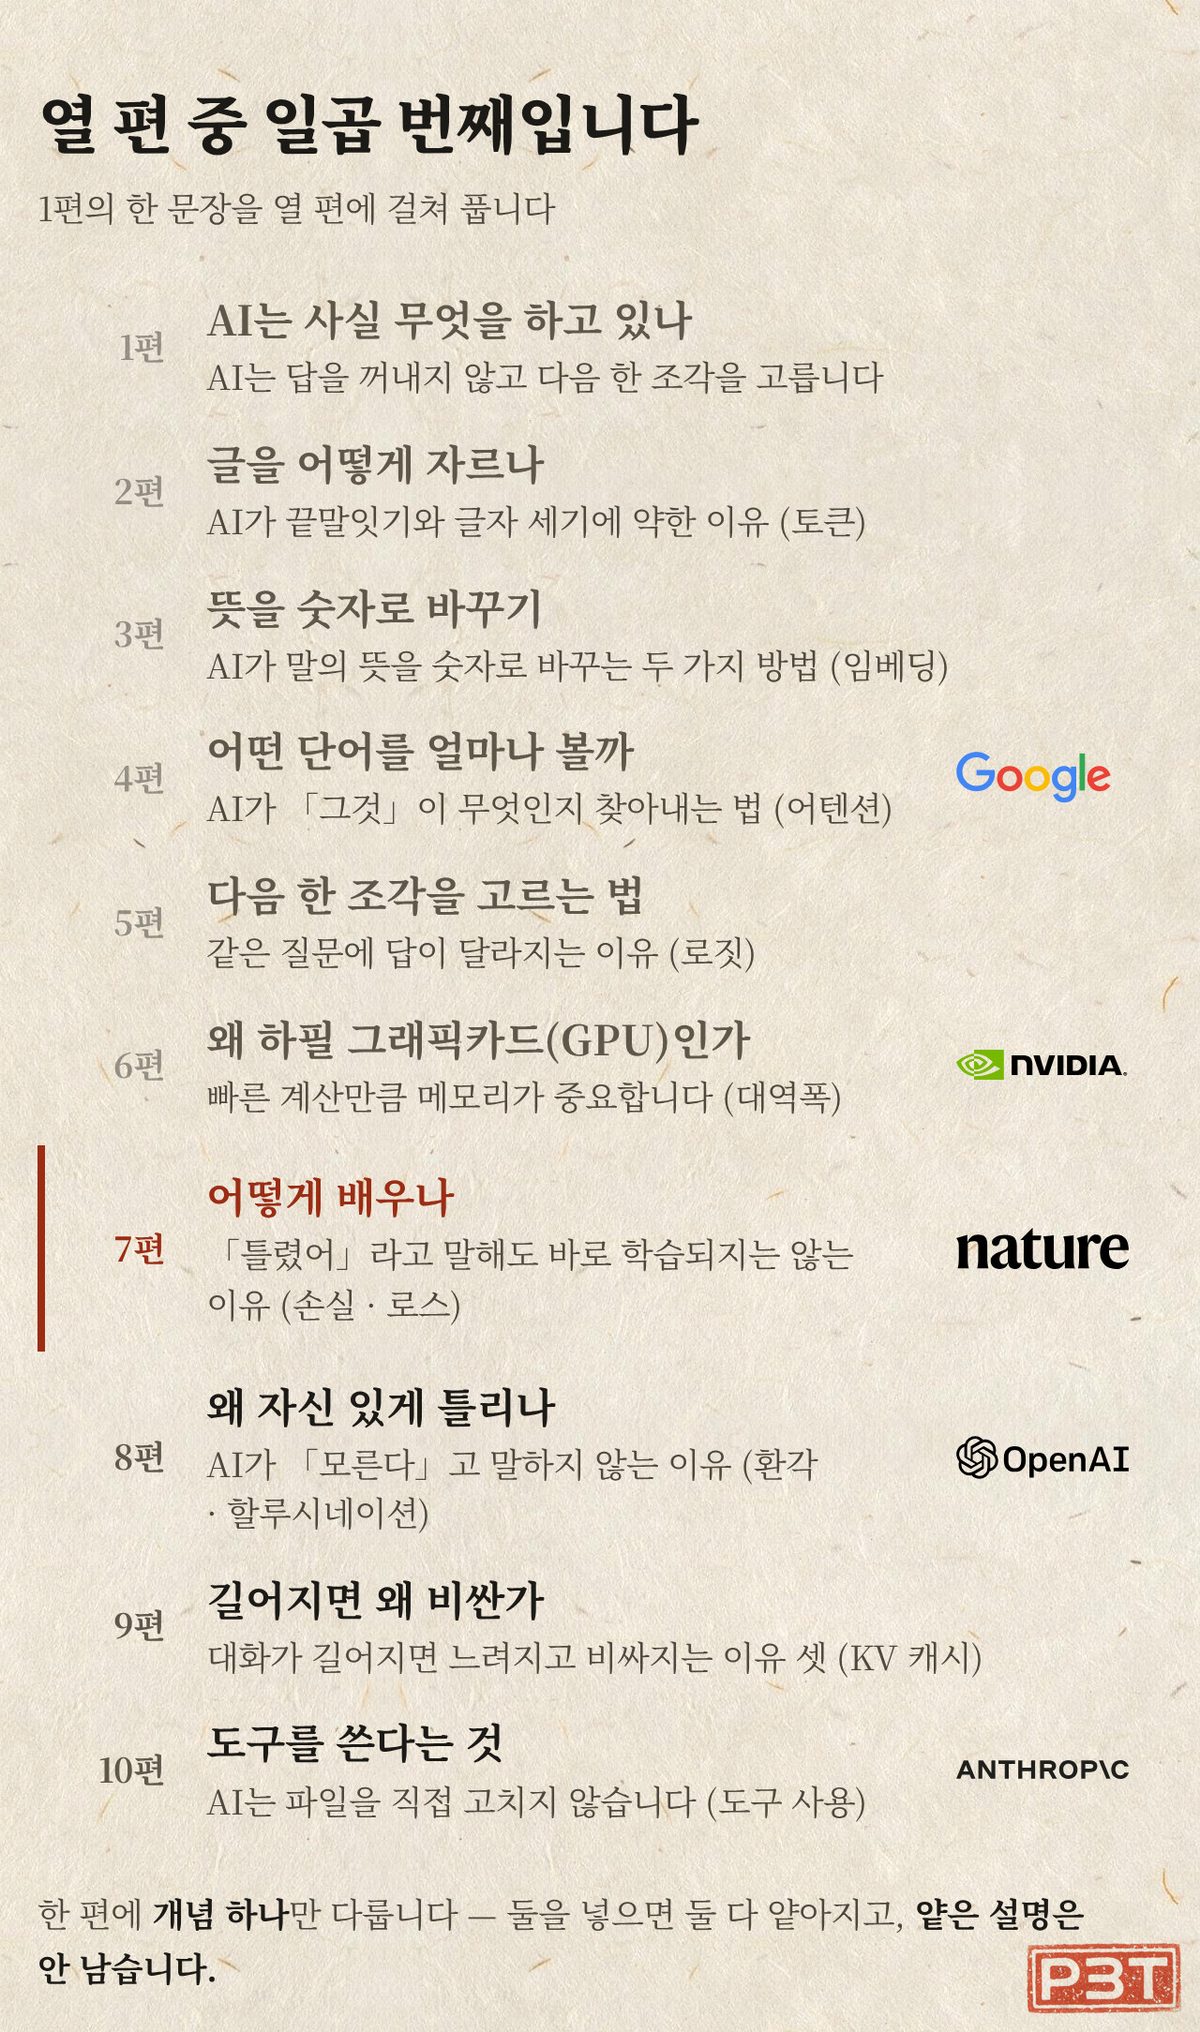
다음 편에서는 AI가 왜 모르는 내용도 자신 있게 말하는지 살펴봅니다.
읽고 나서 해 볼 것
AI의 답이 마음에 들지 않을 때는 「다시 해 봐」보다 틀린 부분과 원하는 기준을 구체적으로 적어 주세요. 그러면 AI가 지금 대화 안에서 답을 훨씬 잘 고칩니다. 다만 친절하고 자연스러운 말투가 사실까지 보장하지는 않으므로, 중요한 내용은 출처에서 다시 확인해야 합니다.
출처
각주 9개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 파이토치 공식 문서는 손실 함수가 결과와 목표값의 차이를 재는 것이며 학습 중 최소화 대상이라고 설명한다Loss function measures the degree of dissimilarity of obtained result to the target value, and it is the loss function that we want to minimize during training.https://docs.pytorch.org/tutorials/beginner/basics/optimization_tutorial.html확인 2026-09-02↩
- 2019년 오픈AI 논문은 앞선 기호들에 대한 조건부 확률의 곱으로 전체 확률을 분해하는 것이 일반적이라고 적었다it is common to factorize the joint probabilities over symbols as the product of conditional probabilitieshttps://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf확인 2026-09-02↩
- 구글 머신러닝 공식 강의 문서는 손실을 줄이는 쪽으로 가중치와 편향을 움직일 방향을 정하는 일이라고 적는다Determine the direction to move the weights and bias that reduce loss.https://developers.google.com/machine-learning/crash-course/linear-regression/gradient-descent확인 2026-09-02↩
- 파이토치 공식 문서는 역전파에서 신경망이 오차에 비례해 파라미터를 조정하며 출력에서 뒤로 거슬러 미분값을 모아 경사하강으로 최적화한다고 설명한다In backprop, the NN adjusts its parameters proportionate to the error in its guess. It does this by traversing backwards from the output, collecting the derivatives of the error with respect to the parameters of the functions (gradients), and optimizing the parameters using gradient descent.https://docs.pytorch.org/tutorials/beginner/blitz/autograd_tutorial.html확인 2026-09-02↩
- 2022년 오픈AI 논문은 언어 모델을 더 크게 만든다고 해서 그 자체로 사용자의 의도를 더 잘 따르게 되지는 않는다고 적었다Making language models bigger does not inherently make them better at following a user's intent.https://arxiv.org/abs/2203.02155확인 2026-09-02↩
- 같은 논문은 사람이 쓴 바람직한 응답 예시로 지도학습 미세조정을 한 뒤 모델 출력을 견주어 고른 자료로 사람 피드백 기반 강화학습을 통해 다시 미세조정한다고 적었다we collect a dataset of labeler demonstrations of the desired model behavior, which we use to fine-tune GPT-3 using supervised learning. We then collect a dataset of rankings of model outputs, which we use to further fine-tune this supervised model using reinforcement learning from human feedback.https://arxiv.org/abs/2203.02155확인 2026-09-02↩
- arXiv 2203.02155 는 자신들의 프롬프트 분포에서 사람 평가 결과 13억 파라미터 InstructGPT 출력이 1,750억 파라미터 GPT-3 출력보다 선호됐다고 적었다In human evaluations on our prompt distribution, outputs from the 1.3B parameter InstructGPT model are preferred to outputs from the 175B GPT-3, despite having 100x fewer parameters.https://arxiv.org/abs/2203.02155확인 2026-09-02In human evaluations on our prompt distribution, outputs from the 1.3B parameter InstructGPT model are preferred to outputs from the 175B GPT-3, despite having 100x fewer parameters.https://proceedings.neurips.cc/paper_files/paper/2022/hash/b1efde53be364a73914f58805a001731-Abstract-Conference.html확인 2026-09-02↩
- 같은 논문은 InstructGPT 가 진실성 개선과 유해 출력 감소를 보이면서 공개 NLP 데이터셋에서의 성능 하락은 최소였다고 적었다Moreover, InstructGPT models show improvements in truthfulness and reductions in toxic output generation while having minimal performance regressions on public NLP datasets.https://arxiv.org/abs/2203.02155확인 2026-09-03↩
- 앤트로픽 공식 문서는 메시지 API가 무상태라서 매번 대화 기록 전체를 보내야 한다고 적는다The Messages API is stateless, which means that you always send the full conversational history to the API.https://platform.claude.com/docs/en/build-with-claude/working-with-messages확인 2026-09-02↩