 P3T
엔비디아 GPU 10만 장, 값으로 최대 7조 5천억
오픈AI 가 낸 돈이 아니라 오라클이 구축한 장비의 시장 추정가입니다
- 무슨 일
- 오픈AI 가 GPT-6 아스트라를 GPU 10만 장 넘게로 학습시켰고, 장비값은 최대 7조 5천억 원입니다.
- 확인된 것
- 그 랙을 산 곳은 오라클이고, 엔비디아는 랙 정가를 한 번도 낸 적이 없어 값은 전부 외부 추정입니다.
- 왜 중요한가
- 이 숫자를 「오픈AI 가 7조 5천억을 썼다」로 옮기면, 아무도 확인한 적 없는 지출이 사실이 됩니다.
- 오늘 할 일
- AI 비용 기사에서 「환산하면」「추정」이라는 말이 있는지 먼저 찾습니다.
GPU 10만 장 장비값은 최대 7조 5천억 원, 한국 최대 모델 연산량은 기록 최대의 130분의 1입니다.
GPT-6 아스트라는 텍사스의 데이터센터 한 곳에서 엔비디아 GPU 10만 장 이상을 써서 학습됐습니다. 같은 수량의 장비를 시장 추정가로 환산하면 5조 4천억~7조 5천억 원이 나옵니다. 다만 오픈AI 가 이 돈을 실제로 냈다는 뜻은 아닙니다. 오라클이 구축한 장비를 시장 추정가로 환산한 구매가치입니다.
- GPT-6 아스트라는 텍사스 데이터센터 한 곳에서 엔비디아 GPU 10만 장 이상으로 학습됐습니다. 같은 수량의 장비를 시장 추정가로 환산하면 5조 4천억~7조 5천억 원인데, 랙을 산 곳은 오라클이어서 오픈AI 가 실제로 쓴 돈이 아닌 장비 구매가치입니다.
- 엔비디아는 GB200 NVL72 랙의 정가를 공개한 적이 없습니다. 외부 추정으로 랙 한 대가 39억~47억 원이고, 어느 가격을 쓰느냐에 따라 10만 장의 계산값이 약 2조 원까지 벌어집니다.
- 한국도 대규모 모델을 만듭니다. 다만 한국 최대 모델 EXAONE 4.5 의 학습 연산량은 값이 기록된 최대 모델 Grok 4 의 130분의 1이고, 오픈AI·앤트로픽·구글 딥마인드의 2026년 모델은 학습 연산량이 집계표에 적혀 있지 않습니다.
텍사스 한 곳에 GPU 10만 장 — 회사가 밝힌 값입니다
오픈AI 는 2026년 9월 3일 아스트라를 공개하면서, 텍사스 스타게이트 데이터센터에서 GPU 10만 장 이상을 사용해 학습했다고 밝혔습니다1. 회사 역사상 가장 큰 학습이자, 10만 장 이상의 GPU 로 사전학습한 첫 사례입니다1. 오픈AI 공동 창업자이자 사장인 그레그 브록먼은 「쉽게 던지는 숫자지만 그 규모를 생각해 보라」고 말했습니다1.
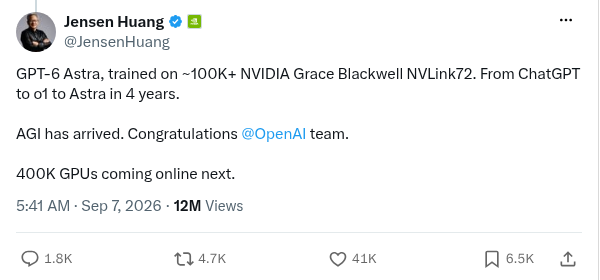
젠슨 황(엔비디아 CEO)은 X 에 「GPT-6 아스트라는 약 10만 이상의 엔비디아 그레이스 블랙웰 NVLink72 로 학습했다」고 쓰고, 「다음에는 GPU 40만 장이 온라인에 올라온다」고 덧붙였습니다2. 첫 숫자에는 단위가 빠져 있지만, 오픈AI 의 발표와 뒤따르는 「GPU 40만 장」이라는 표현을 근거로 이 글에서는 GPU 장수로 읽습니다.
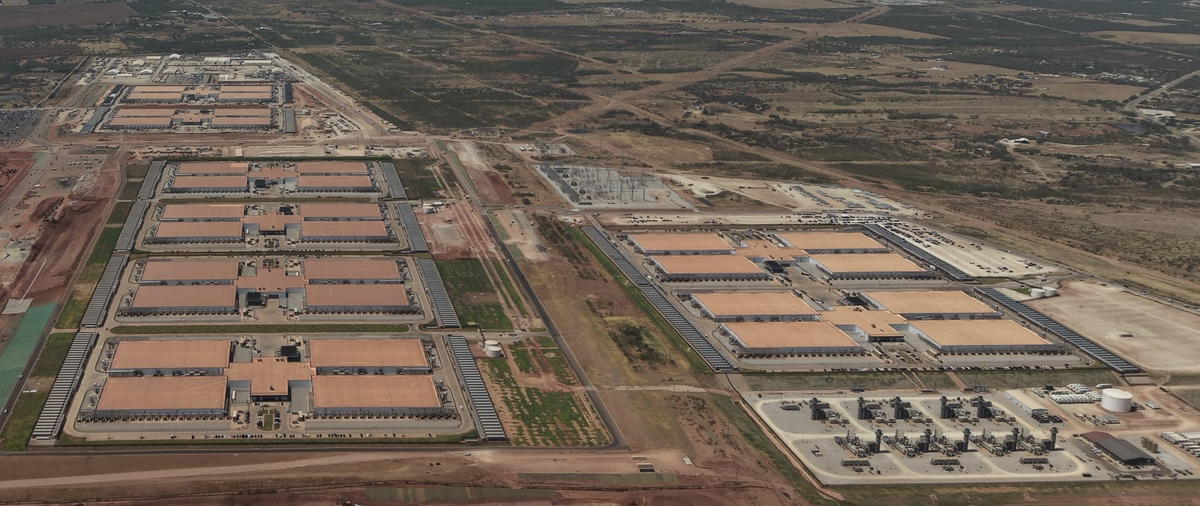
이 데이터센터는 텍사스 애빌린에 있습니다. 이 단지는 데이터센터 회사 크루소가 짓고 있는데, 건물 여덟 동을 계획했고 오라클은 2025년 6월부터 그 안에 엔비디아 GB200 랙을 설치해 왔습니다3. 완공되면 GPU 수십만 장을 하나의 네트워크로 묶을 수 있는 규모입니다3. 아래에서는 이 장비를 GB200 NVL72 랙으로 부르겠습니다.
여기까지가 회사들이 공개한 사실이고, 지금부터의 가격은 외부 자료로 계산한 추정입니다.
엔비디아는 정가표를 안 냅니다 — 랙 한 대가 39억에서 47억
엔비디아는 GB200 NVL72 의 공식 정가를 공개한 적이 없습니다. 미국의 하드웨어 전문 매체 톰스하드웨어는 엔비디아가 정가를 확인해 준 적이 없다고 보도했고4, 다른 자료도 엔비디아와 클라우드 사업자가 랙 가격을 공개하지 않는다고 설명했습니다5.
GB200 NVL72 는 GPU 를 한 장씩 사는 물건이 아니라 랙 단위로 공급되는 장비입니다. 랙 한 대에는 그레이스 CPU 36개와 블랙웰 GPU 72장, 액체냉각 장비 등이 함께 들어갑니다6. 그래서 아래 계산은 「랙 장비값」이지 「GPU 가격」이 아닙니다.
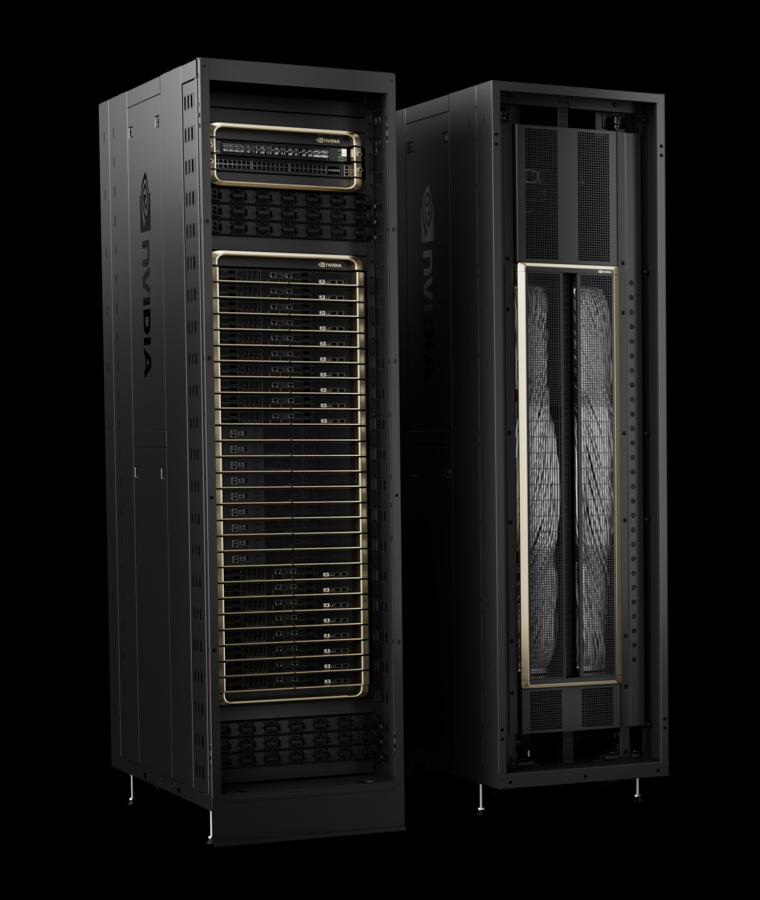
톰스하드웨어는 업계 소식통을 인용해 랙 가격을 280만~340만 달러로 보도했습니다4. 반도체·AI 인프라 분석사 세미애널리시스는 랙만 310만 달러, 부속 장비까지 더한 「올인」 값은 390만 달러로 추정했습니다5. 올인은 랙에 랙끼리 잇는 네트워크 장비 같은 부속을 더한 값을 가리키는 업계 말이고, 건물이나 설치 비용은 들어 있지 않습니다. 2026년 9월 17일 장중 환율(1달러 1,384.5원)을 1,380원으로 반올림해 계산하면7, 랙 한 대가 약 39억~47억 원이고, 부속 장비까지 더하면 약 54억 원이 됩니다.
GPU 10만 장은 랙으로 최소 1,389대입니다. 여기에 랙 가격을 단순히 곱하면 약 5조 4천억~6조 5천억 원이 나오고, 부속 장비까지 더한 값으로 계산하면 약 7조 5천억 원입니다. 건물과 전력 설비는 뺀 금액입니다.
같은 10만 장인데도 어느 가격을 쓰느냐에 따라 계산값이 약 2조 원까지 벌어집니다.
더 중요한 조건이 하나 있습니다. 이 랙을 산 곳은 오픈AI 가 아니라 오라클입니다3. 오픈AI 는 오라클과 함께 구축한 슈퍼클러스터(GPU 랙 여러 대를 묶은 대형 연산 설비)를 사용합니다8. 따라서 7조 5천억 원은 오픈AI 가 실제로 쓴 돈이 아니라, 학습에 쓰인 10만 장만큼 장비를 샀다고 가정했을 때의 추정치입니다.
단가보다 크게 달라진 것은 수량입니다. 메타가 2024년에 라마 3.1 학습에 쓴 H100 은 1만 6천 장 이상이었습니다9. 아스트라는 10만 장 이상이니 약 6배 규모입니다.
다음은 40만 장입니다 — 그리고 학습 한 번의 비용이 전부가 아닙니다
젠슨 황이 말한 「다음 40만 장」은 아직 계획입니다. 오라클도 애빌린 슈퍼클러스터가 엔비디아 GPU 수십만 장을 연결하는 구조라고 밝혔습니다8.
GPU 40만 장은 랙으로 약 5,556대입니다. 앞서 계산한 랙당 가격(약 39억~47억 원)을 적용하면 랙만 약 21조~26조 원, 부속 장비까지 더하면 약 29조 9천억 원이 됩니다. 실제 구매액은 아니고, 앞으로 들어설 장비 규모의 단순 환산치입니다.
장비 구축비가 개발비의 전부인 것도 아닙니다. AI 학습 규모와 비용을 추적하는 연구기관 에포크 AI 의 분석에서, 오픈AI 의 연구개발 컴퓨트 가운데 최종 학습에 쓰인 몫은 9.6% 였습니다10. 나머지 90% 는 최종 학습이 아닌 연구개발에 들어갔습니다10. 최종 학습 한 번에 드는 컴퓨트의 거의 열 배가 연구개발에 쓰인다는 뜻입니다.
그리고 이 비용 문턱은 해마다 높아집니다. 에포크 AI 는 가장 큰 학습 한 번의 비용이 2016년 이후 매년 약 2.4배씩 늘었고, 추세가 이어지면 2027년에는 10억 달러를 넘을 것으로 봤습니다11. 최전선 모델을 만들려는 곳은 랙 수천 대를 확보하고, 최종 학습의 열 배 가까이를 연구개발에 쓰고, 해마다 높아지는 이 문턱을 따라가야 합니다. 그렇다면 한국은 어디쯤에 있을까요.
한국도 만듭니다 — 다만 130배 차이입니다
에포크 AI 는 학습 컴퓨트(학습에 들어간 총 연산량)가 10²³ FLOP(연산 횟수를 세는 단위)을 넘는 모델을 「대규모 모델」로 따로 모읍니다12. 이 명단에 2026년 8월까지 한국 조직이 낸 모델이 22건 올라 있고, LG AI연구원, 삼성, 네이버, SK텔레콤, KT, 엔씨소프트, 업스테이지 같은 이름이 보입니다12.
그중 가장 큰 것은 LG AI연구원이 2026년 4월에 낸 EXAONE 4.5 로, 학습 컴퓨트가 3.85×10²⁴ FLOP 입니다12. 같은 명단에서 컴퓨트 값이 기록된 가장 큰 모델은 xAI 가 2025년 7월에 낸 Grok 4 로 5×10²⁶ FLOP 입니다12. 둘의 차이는 약 130배입니다.
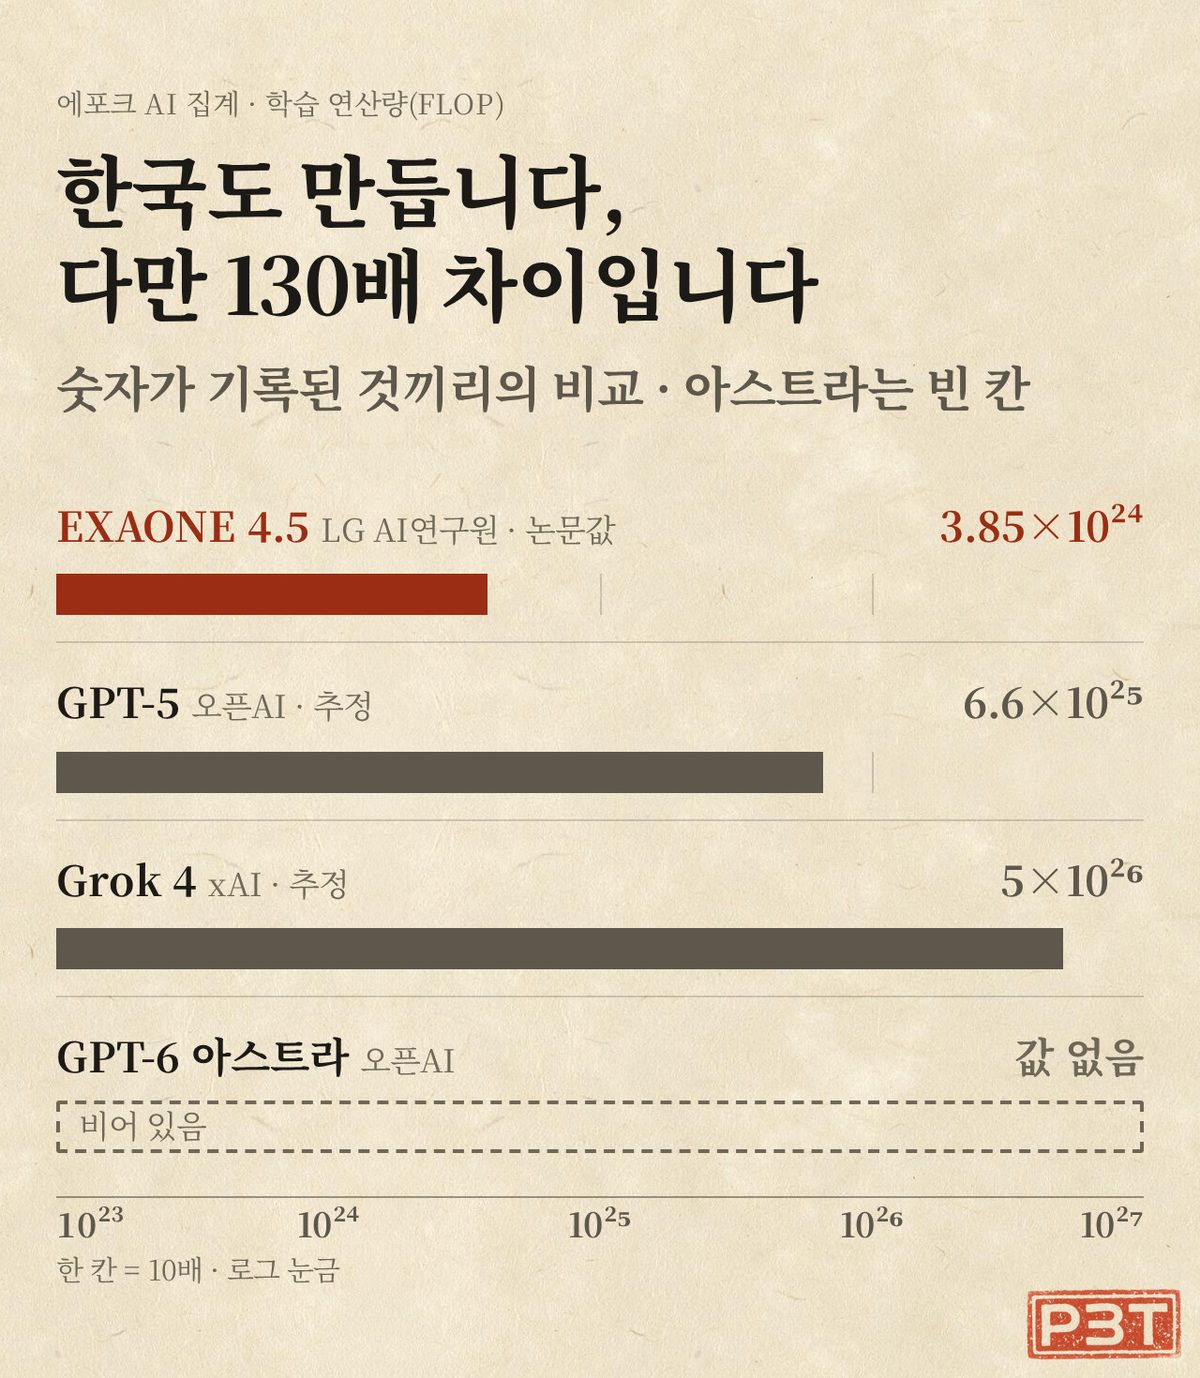
이 130배에는 조건이 둘 붙습니다. 첫째, 값이 기록된 것끼리의 비교입니다. Grok 4 의 값은 에포크 AI 의 추정치라 실제와 최대 30배까지 다를 수 있고, EXAONE 4.5 는 논문 표에서 가져온 값이라 오차가 3배 이내입니다12. 둘째, 아스트라는 이 비교에 없습니다. 학습 컴퓨트 칸이 표에서 비어 있기 때문입니다.
에포크 AI 가 2026년에 나온 모델로 기록한 71개 가운데 컴퓨트 값이 적힌 것은 18개뿐입니다13. 그 18개는 중국 8개, 한국 5개, 미국 5개이고, 오픈AI·앤트로픽·구글 딥마인드의 2026년 모델은 칸이 전부 비어 있습니다13. 이 세 회사의 모델 가운데 마지막으로 값이 적힌 것은 2025년 8월의 GPT-5 로, 6.6×10²⁵ FLOP 이라는 추정값입니다13.
에포크 AI 가 칸을 비운 이유를 설명한 적은 없습니다. 다만 컴퓨트를 계산하려면 파라미터 수와 학습 토큰 수, 또는 GPU 수와 학습 시간이 있어야 합니다. 아스트라 발표에서 확인되는 숫자는 GPU 장수입니다1. 나머지 재료가 없으니 칸이 빈 것으로 보이고, 이 글이 학습비 대신 장비 구매가치로 계산한 이유도 같습니다.
읽고 나서 해 볼 것
AI 비용 기사를 볼 때는 회사가 공개한 값인지 외부 추정인지, 실제 지출액인지 장비 구매가치인지부터 확인해 보세요. 어느 쪽으로 계산해도 최전선 AI 모델 하나에는 천문학적인 돈이 들어가고 있는데, 그 돈의 정확한 액수는 점점 밖에서 확인할 길이 없어지고 있습니다.
출처
각주 13개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 오픈AI 는 GPT-6 아스트라를 텍사스 스타게이트 데이터센터에서 GPU 10만 장 넘게 써서, 회사 역사상 가장 큰 학습으로 만들었다고 밝혔다 — 연구 부사장 에이든 클라크는 「10만 장 넘는 GPU 로 사전학습한 것은 처음」이라 했고, 사장 그레그 브록먼은 「10만 장 넘는 GPU 로 학습한 첫 실행」이라며 「쉽게 던지는 숫자지만 그 규모를 생각해 보라」고 했다Between the lines: OpenAI said that Astra was built on its largest-ever training run, using more than 100,000 GPUs at its Stargate site in Texas. (Ina Fried · Sep 3, 2026)https://www.axios.com/2026/09/03/openai-astra-gpt-6-agi-brockman확인 2026-09-15"It's the first time we've pretrained on more than 100,000 GPUs at our Stargate site in Texas." — Aidan Clark, OpenAI vice president of research (Emily Forlini · September 3, 2026) / "OpenAI cofounder and president Greg Brockman told reporters today." (09-17 추가 — 본문1.1 「공동 창업자이자 사장인」 서술어 근거 · Ryan 인라인 편집)https://fortune.com/2026/09/03/openai-debuts-gpt-6-astra-computer-use-greg-brockman-says-start-of-agi/확인 2026-09-15We're talking about the fact that this is the first run that we've trained on more than 100,000 GPUs, which is an easy number to throw around, but just think about the scale of that. (Greg Brockman · September 4, 2026)https://stratechery.com/2026/an-interview-with-openai-president-greg-brockman-about-astra-and-alignment/확인 2026-09-15↩
- 젠슨 황은 X 에 「GPT-6 아스트라는 약 10만 장 넘는(~100K+) 엔비디아 그레이스 블랙웰 NVLink72 로 학습했다」고 적고 「400K GPUs coming online next(다음은 GPU 40만 장이 온라인에 올라온다)」고 덧붙였다GPT-6 Astra, trained on ~100K+ NVIDIA Grace Blackwell NVLink72. From ChatGPT to o1 to Astra in 4 years. AGI has arrived. Congratulations @OpenAI team. 400K GPUs coming online next. (5:41 AM · Sep 7, 2026 화면 표시)https://x.com/JensenHuang/status/2096700264569090384확인 2026-09-15↩
- Crusoe 는 텍사스 애빌린 스타게이트 단지에 대해 2024년 6월 착공 · 2025년 6월부터 오라클이 엔비디아 GB200 랙을 들이기 시작 · 건물 여덟 동을 다 지으면 GPU 수십만 장을 한 네트워크로 묶을 수 있다고 밝혔다Construction of the multi-building campus began in June 2024. Within a year, the first two buildings were energized ... Oracle began delivering the first NVIDIA GB200 racks in June 2025 / At completion, the planned eight building campus will be able to support hundreds of thousands of GPUs on a single integrated network fabric. (September 30, 2025)https://www.crusoe.ai/resources/newsroom/crusoe-announces-flagship-abilene-data-center-is-live확인 2026-09-15↩
- 톰스하드웨어는 업계 소식통을 인용해 GB200 NVL72 랙 한 대가 280만~340만 달러(GB300 NVL72 는 600만~650만 달러)라고 보도했고, 엔비디아는 NVL72 제품의 정가를 한 번도 확인해 준 적이 없다고 적었다a Blackwell-based NVL72 rack-scale system costs $2.8 – $3.4 million for an AI training and HPC-optimized NVL72 GB200 and $6 million to $6.5 million for an AI inference-optimized NVL72 GB300 system, according to a Tom's Hardware source with knowledge of the matter. / Nvidia has never confirmed the list prices of its NVL72 or NVL144 products. (Anton Shilov · March 24, 2026)https://www.tomshardware.com/tech-industry/artificial-intelligence/price-of-nvidias-vera-rubin-nvl72-racks-skyrockets-to-as-much-as-usd8-8-million-apiece-but-server-makers-margins-will-be-tight-nvidia-is-moving-closer-to-shipping-entire-full-scale-systems확인 2026-09-15↩
- 바깥 집계는 GB200 NVL72 랙 한 대를 300만 달러 안팎으로 본다 — 세미애널리시스는 랙만 약 310만 달러 · 네트워크 등까지 얹은 올인 약 390만 달러(2026-08-16 확인 · Spheron 재인용) · 울프리서치 보도를 실은 Investing.com 은 「보도가 약 300만 달러」 — 그리고 엔비디아도 클라우드 회사도 랙 가격을 공개하지 않는다Checked on 16 Aug 2026, SemiAnalysis put GB200 NVL72 at roughly $3.1M bare and $3.9M all-in. / Neither NVIDIA nor the cloud providers publish rack pricing, and unlike most spec questions this one does not resolve cleanly.https://www.spheron.network/blog/gb300-nvl72-vs-gb200-nvl72-pricing-availability-2026/확인 2026-09-15Reported prices are about $3 million for GB200 NVL72 racks and $4.3 million for GB300 NVL72 / Those boards account for about 75% of the final rack price, according to Wolfe's supply chain checks. (Investing.com · Pratyush Thakur · January 30, 2026)https://ca.finance.yahoo.com/news/wolfe-lifts-nvidia-target-25-145211458.html확인 2026-09-15↩
- 엔비디아는 GB200 NVL72 가 랙 한 대에 그레이스 CPU 36개와 블랙웰 GPU 72장을 액체 냉각으로 묶은 구조라고 밝혔다The NVIDIA GB200 NVL72 connects 36 Grace CPUs and 72 Blackwell GPUs in a rack-scale, liquid-cooled design.https://www.nvidia.com/en-us/data-center/gb200-nvl72/확인 2026-09-15↩
- 2026년 9월 17일 오전 서울외환시장 장중 원/달러 환율은 1,384.5원이다 (전일 오후 3시 30분 종가 대비 15.9원 상승 · 장중값)원·달러 환율은 전일대비(오후 3시30분 종가기준) 15.9원(1.16%) 급등한 1384.5원을 기록했다 (2026.09.17 11:15 · 김남현 기자 · 「매파 연준, 환율 1385원 턱밑까지 급등」)https://www.etoday.co.kr/news/view/2626732확인 2026-09-17↩
- Oracle 은 OCI Zettascale10 이 「수십만 장의 엔비디아 GPU 를 여러 데이터센터에 걸쳐 잇는」 구조이며, 텍사스 애빌린에서 오픈AI 와 함께 짓는 스타게이트 플래그십 슈퍼클러스터를 받치는 패브릭이라고 밝혔다OCI Zettascale10 connects hundreds of thousands of NVIDIA GPUs across multiple data centers to form multi-gigawatt clusters that deliver up to an unprecedented 16 zettaFLOPS of peak performance. OCI Zettascale10 is the fabric underpinning the flagship supercluster built in collaboration with OpenAI in Abilene, Texas, as part of Stargate. (Oct 14, 2025)https://www.oracle.com/news/announcement/ai-world-oracle-unveils-next-generation-oci-zettascale10-cluster-for-ai-2025-10-14/확인 2026-09-15↩
- 메타는 라마 3.1 405B 를 H100 GPU 1만 6천 장 이상으로, 15조 토큰 넘게 학습시켰다고 밝혔다over 16 thousand H100 GPUs / training Llama 3.1 405B on over 15 trillion tokens / making the 405B the first Llama model trained at this scalehttps://ai.meta.com/blog/meta-llama-3-1/확인 2026-09-11↩
- Epoch AI 는 최종 학습(final training run)이 회사 전체 연구개발 컴퓨트 지출에서 소수를 차지한다고 분석했다 — 오픈AI 9.6%, MiniMax 22.6%, Z.ai 12.3% 다For all of OpenAI, Z.ai, and MiniMax, final training runs account for a small fraction of total R&D compute spending: 9.6% for OpenAI, 22.6% for MiniMax, and 12.3% for Z.ai.https://epoch.ai/gradient-updates/r-and-d-vs-training-compute확인 2026-09-11↩
- Epoch AI 는 GPT-3·OPT-175B·GPT-4·제미나이 울트라 네 모델의 개발비를 추정해 하드웨어(칩·서버 부품·연결 장비 합계) 47~67%, 연구인력(주식 보상 포함) 29~49%, 에너지 2~6% 로 쪼갰고, 비용이 2016년 이후 연 2.4배로 늘어 2027년에는 가장 큰 학습 한 번이 10억 달러를 넘을 것으로 봤다The combined cost of AI accelerator chips, other server components and interconnect hardware makes up 47–67% of the total, whereas R&D staff costs are 29–49% (including equity). Energy consumption makes up the remaining 2–6% of the cost. / We applied this approach to GPT-3, OPT-175B (notable as a GPT-3 replication attempt by a team at Meta AI), GPT-4, and Gemini Ultra. / grown at a rate of 2.4x per year since 2016 / the largest training runs will cost more than a billion dollars by 2027https://epoch.ai/blog/how-much-does-it-cost-to-train-frontier-ai-models확인 2026-09-14the amortized cost to train the most compute-intensive models has grown precipitously at a rate of 2.4x per year since 2016 (90% CI: 2.0x to 2.9x). For key frontier models, such as GPT-4 and Gemini, the most significant expenses are AI accelerator chips and staff costs, each costing tens of millions of dollars. Other notable costs include server components (15-22%), cluster-level interconnect (9-13%), and energy consumption (2-6%). If the trend of growing development costs continues, the largest training runs will cost more than a billion dollars by 2027https://arxiv.org/abs/2405.21015확인 2026-09-14↩
- Epoch AI 의 대규모 모델 데이터셋(학습 컴퓨트 10^23 FLOP 초과 모델 · 2026-08-20 까지 529행)에서 한국 소재 조직이 낸 모델은 22건(LG AI Research · 삼성 · 업스테이지 · 네이버 · SK텔레콤 · KT · 엔씨소프트 · 코난테크놀로지 · 모티프 · 트릴리온랩스 등)이고, 그중 학습 컴퓨트가 가장 큰 것은 LG AI Research 의 EXAONE 4.5(2026-04-09 · 3.85×10^24 FLOP · 신뢰도 Confident)다. 같은 데이터셋에서 컴퓨트 값이 기록된 가장 큰 모델은 xAI 의 Grok 4(2025-07-09 · 5.0×10^26 FLOP · 신뢰도 Speculative)로, 둘의 비는 약 130배다열 이름 `Country (of organization)` 값 `South Korea` 행 22개(조직 문자열 12종 · LG 와 LG AI Research, NAVER 와 NAVER,Search Solutions 가 따로 적혀 있다) · `Training compute (FLOP)` 최대 = EXAONE 4.5 · LG AI Research · 2026-04-09 · 3.85e+24 · Confidence `Confident`(주석 「From Table 1 in paper」) · 전체 최대 = Grok 4 · xAI · 2025-07-09 · 5.0000000000001e+26 · Confidence `Speculative` · 5.0e26 / 3.85e24 = 129.87 (2026-09-16 curl 직독 · 1,097,984바이트 · 529행 · 최신 행 2026-08-20)https://epoch.ai/data/large_scale_ai_models.csv확인 2026-09-16Large-scale models are models that were trained with over 10^23 FLOP of compute, which is a static threshold that is used in some AI regulatory frameworks. / Records are labeled based on the uncertainty of their training compute, parameter count, and dataset size. "Confident" records are accurate within a factor of 3x, "Likely" records within a factor of 10x, and "Speculative" records within a factor of 30x, larger or smaller. / Updated Sep. 15, 2026https://epoch.ai/data/large-scale-ai-models확인 2026-09-16↩
- Epoch AI 의 주요 모델 데이터셋(notable · 2026-09-08 갱신 · 1,065행)에서 2026년에 나온 모델 71개 가운데 학습 컴퓨트 값이 적힌 것은 18개뿐이고(중국 8 · 한국 5 · 미국 5), 오픈AI(14행)·앤트로픽(6행)·구글 딥마인드(4행)의 2026년 모델은 컴퓨트 칸이 전부 비어 있다. GPT-6 아스트라(2026-09-03)도 명단에 있지만 컴퓨트 칸은 비어 있다. 이 세 회사 모델 중 마지막으로 값이 적힌 것은 GPT-5(2025-08-07 · 6.6×10^25 FLOP · 신뢰도 Speculative)다`Publication date` 2026 으로 시작하는 행 71 · 그중 `Training compute (FLOP)` 비어 있지 않은 행 18 — Composer 2.5(Cursor · 3.87e+25) · Composer 2(Cursor) · Kimi K3(Moonshot · 2.0001e+25) · LongCat-2.0(Meituan) · DeepSeek-V4-Pro(DeepSeek · 9.702e+24) · GLM-5(Z.ai) · MiMo-V2.5-Pro(Xiaomi) · Nemotron 3 Ultra(NVIDIA · 6.6e+24) · Kimi K2.5 · EXAONE 4.5(LG AI Research · 3.85e+24) · K-EXAONE 2.0(LG AI Research · 3.55e+24) · GLM-5.3-Flash · DeepSeek-V4-Flash · Inkling(Thinking Machines) · A.X K2(SK Telecom · 1.8e+24) · Motif-3(Motif Technologies · 1.1e+24) · Solar Open2 250B(Upstage · 1.05e+24) · MolmoAct 2 · `Country (of organization)` 첫 값 기준 China 8 · South Korea 5 · United States of America 5 / `Model` = GPT-6 Astra · `Organization` = OpenAI · `Publication date` = 2026-09-03 · `Training compute (FLOP)` = (빈 칸) / OpenAI 2026 행 14 · compute 0 · Anthropic 6 · 0 · Google DeepMind 4 · 0 / GPT-5 · OpenAI · 2025-08-07 · 6.6e+25 · Confidence `Speculative`(주석 「Fairly speculative, possibly around 6e25 [CI: 2e25 to 2e26] FLOP」) (2026-09-16 curl 직독 · 2,241,647바이트 · 1,065행 · 최신 행 2026-09-08)https://epoch.ai/data/notable_ai_models.csv확인 2026-09-16GPT-6 Astra | Epoch AI · Organization OpenAI · Release date Sep. 3, 2026 · Model accessibility Closed weights · Training — Parameters Unknown · Training compute Unknown · Training hardware Unknown · Training time Unknown · Training dataset size Unknownhttps://epoch.ai/models/gpt-6-astra확인 2026-09-16↩