 P3T
GPT-6 수능 만점, 그런데 조건이 붙었습니다
문항을 하나씩 줬을 때의 450점이고, 과목을 통째로 주면 448.5점입니다
- 무슨 일
- GPT-6 아스트라가 2026 수능 채점표에서 450점 만점을 받았습니다.
- 확인된 것
- 한 과목을 통째로 주면 448.5점으로 공동 1위입니다.
- 왜 중요한가
- 점수만 옮기면 처음 보는 문제를 푼 기록으로 읽힙니다.
- 오늘 할 일
- 점수 옆에 시험 조건이 적혀 있는지 먼저 봅니다.
GPT-6 아스트라의 수능 450점은 문항을 하나씩 제시했을 때의 기록이고, 한 과목 전체를 주면 448.5점으로 공동 1위입니다.
9월 초 GPT-6 아스트라가 2026학년도 수능에서 450점 만점을 받았습니다. 함께 시험을 치른 모델 가운데 만점은 아스트라 하나였습니다. 그런데 채점 대시보드에는 이런 표시가 붙어 있었습니다. 「시험 이후 공개된 자료를 학습했을 가능성 있음」 만점이라는 결과는 맞습니다. 다만 처음 보는 문제를 풀어 얻은 점수인지는 별개의 문제입니다.
- 450점은 문제를 한 문항씩 따로 줬을 때의 점수입니다. 한 과목을 통째로 주면 448.5점으로 GPT-5.6 Sol Pro와 공동 1위입니다.
- 같은 주에 발표된 AI 성과들도 검증 방식이 달랐습니다. 기계 검증부터 외부 시험, 개발사 자체 평가까지 섞여 있습니다.
- 결국 봐야 할 것은 점수만이 아닙니다. 누가 시험했는지, 원자료가 공개됐는지, 다른 사람이 다시 확인할 수 있는지가 중요합니다.
만점은 맞습니다. 조건이 하나 붙습니다
9월 6일 기준 대시보드에서 GPT-6 아스트라는 450점으로 1위였습니다1.
이 시험을 낸 곳은 오픈AI가 아닙니다. 여러 모델에 같은 시험지를 풀게 하고, 코드와 결과를 MIT 라이선스로 공개한 대시보드입니다2.
이틀 뒤 대시보드가 개편됐습니다. 모델들의 성능이 전반적으로 높아지자 만든 사람이 기존 「고난도」를 「일반」으로, 「일반」을 「쉬움」으로 바꿨습니다3.
현재 첫 화면에서 아스트라의 점수는 448.5점입니다. GPT-5.6 Sol Pro와 공동 1위입니다34. 점수가 깎인 것은 아닙니다. 문제를 주는 방식이 달라서 생긴 차이입니다.
- 문항을 하나씩 제시(「쉬움」 모드): 450점15 - 한 과목 전체를 한 번에 제시(「일반」 모드): 448.5점45
두 기록은 원래부터 함께 있었습니다. 개편 뒤 첫 화면에 표시되는 방식만 달라졌습니다35.
답이 달라진 문제는 사회문화 8번 하나였습니다. 아스트라는 문항을 따로 받았을 때는 5번을 골라 맞혔고, 과목 전체를 받았을 때는 4번을 골라 틀렸습니다5.
따라서 「수능 만점」에는 조건을 붙여야 합니다. 문항을 하나씩 제시했을 때의 만점입니다.
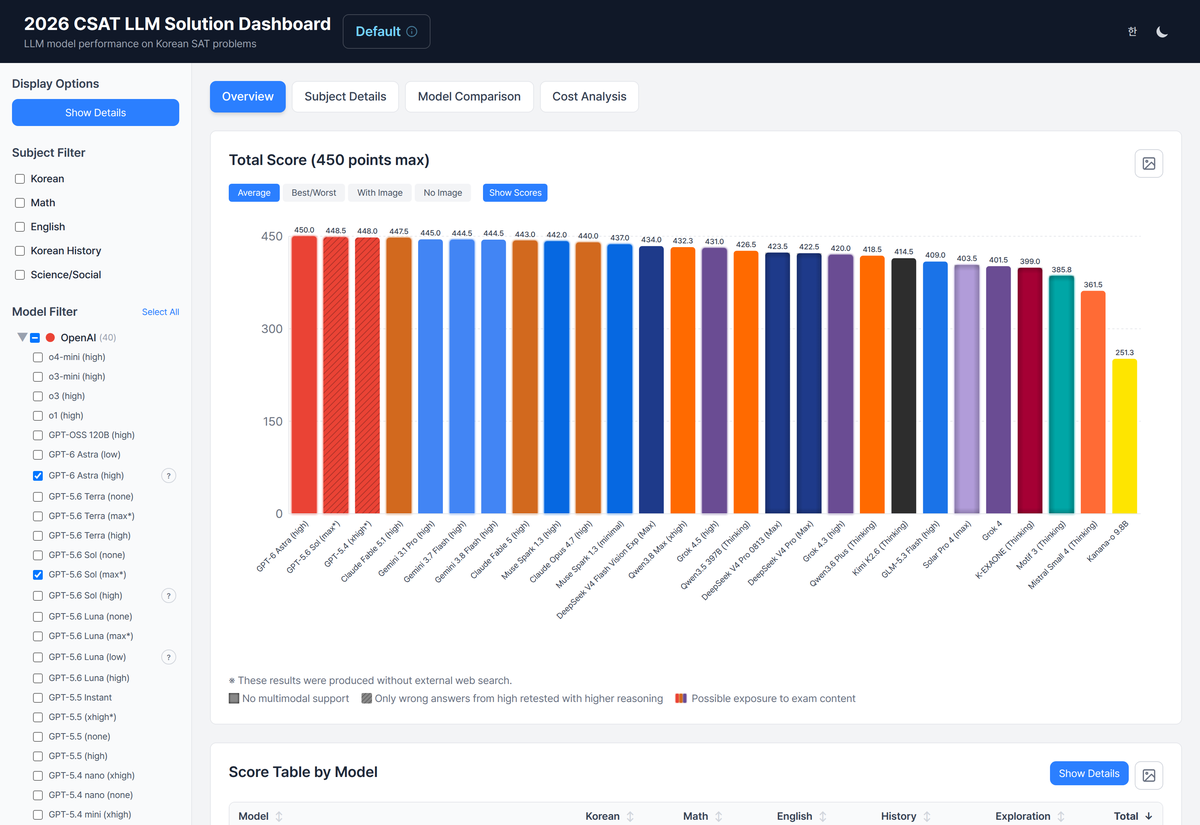
채점표 아래에는 작은 표시가 하나 더 있었습니다. 대시보드는 모델의 지식 컷오프가 시험 시행일보다 뒤에 있으면 「문제 학습 가능성 있음」이라는 표시를 붙입니다. 아스트라에도 이 표시가 있습니다6.
2026학년도 수능은 2025년 11월에 시행됐습니다. 아스트라의 지식 컷오프는 2026년 4월 30일입니다7. 시험이 끝난 뒤 공개된 문제와 해설이 학습 자료에 포함됐을 가능성을 배제할 수 없습니다.
그렇다고 점수가 가짜라는 뜻은 아닙니다. 시험 중 웹 검색과 외부 도구는 사용할 수 없었고2, 대시보드도 실제로 학습됐다고 단정하지 않고 「가능성」만 표시합니다6.
지금 말할 수 있는 범위는 여기까지입니다.
- 문항별로 주면 450점 - 과목 전체를 주면 448.5점 - 시험 자료에 노출됐을 가능성은 있음 - 처음 보는 시험에서도 같은 성적을 낼지는 확인되지 않음
같은 잣대로 그 주의 다른 AI 소식도 살펴보겠습니다.
페르마의 마지막 정리를 옮겼습니다 — 이번에는 기계가 검사했습니다
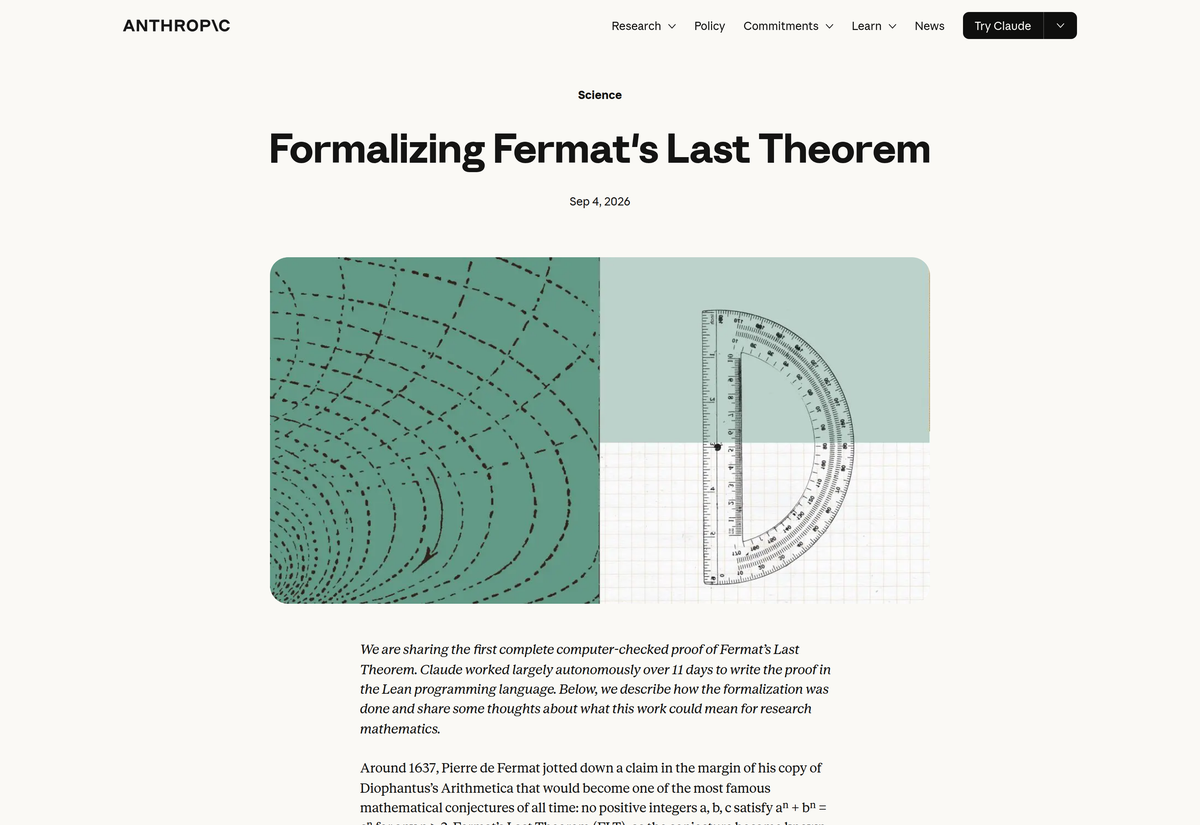
앤트로픽은 클로드가 페르마의 마지막 정리 증명을 린(Lean)이라는 형식 언어로 옮겼다고 발표했습니다. 약 11일 동안 1,300만 줄의 코드를 작성했습니다8.
새로운 증명을 발견한 것은 아닙니다. 1994년에 완성된 증명을 컴퓨터가 검사할 수 있는 형태로 옮긴 것입니다.
그래도 검증 방식은 탄탄합니다. 린이 증명의 논리를 단계별로 확인했고, 정리의 내용이 표준 라이브러리와 같은지도 기계적으로 대조했습니다. 발표한 회사의 연구자가 아니라 검증 프로그램이 결과를 판정한 셈입니다.
로봇 팔은 20번 중 19번 성공했습니다
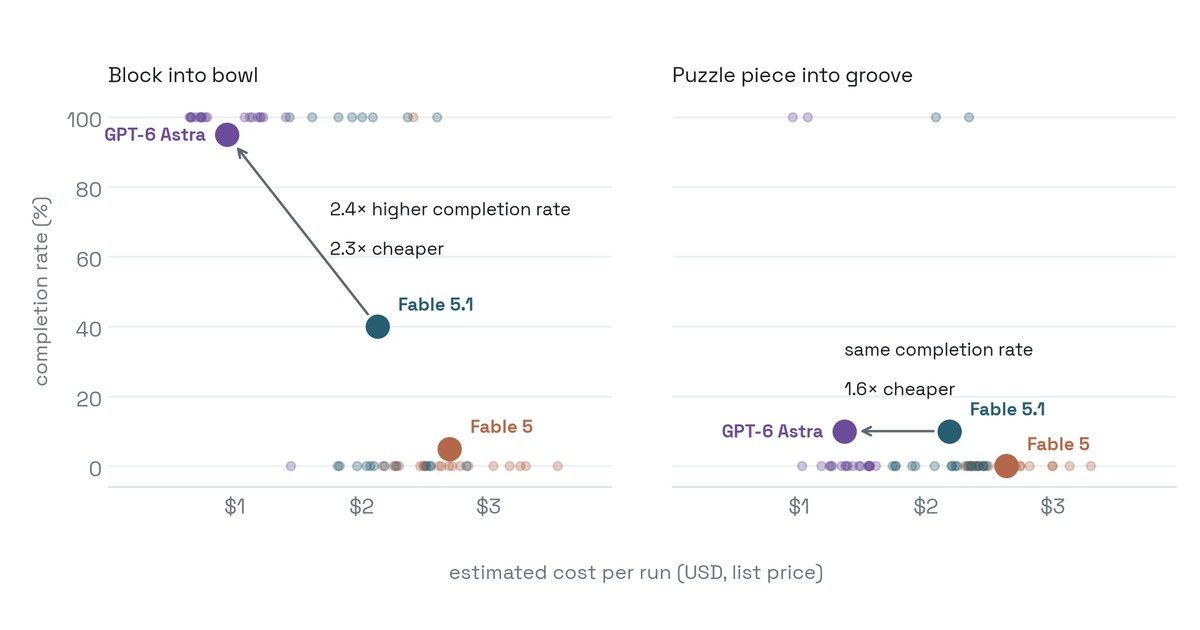
로보커브는 아스트라에 실제 로봇 팔을 맡겼습니다. 블록을 그릇에 넣는 과제에서 아스트라는 20회 중 19회, Fable 5.1은 20회 중 8회 성공했습니다. 아스트라의 성공률은 약 2.4배 높았고 회당 비용은 2.3배 낮았습니다.
오픈AI가 아닌 외부 회사가 같은 장비로 비교했고, 영상과 실행 기록도 공개했습니다. 다만 표본은 모델별 20회입니다. 더 어려운 퍼즐 조립에서는 두 모델 모두 2회 성공했습니다.
특정 과제에서는 큰 차이가 났지만, 이를 로봇 제어 능력 전체의 우위로 일반화하기는 어렵습니다.
「포털」을 끝까지 깼습니다 — 비용은 571달러였습니다
아스트라가 3D 퍼즐 게임 「포털」을 약 24시간 만에 완료한 사례도 공개됐습니다. 도구 호출은 3,336회, API 비용은 571달러였습니다.
게임 도중 사람이 직접 조작하지 않았다는 점은 흥미롭습니다. 하지만 환경과 도구는 사람이 미리 구성했고, 이 역시 한 개인이 공개한 단일 실행 사례입니다.
인상적인 데모인 것은 맞지만, 여러 모델을 같은 조건에서 반복한 표준 벤치마크는 아닙니다.
퍼플렉시티의 자체 시험에서는 1위였습니다
퍼플렉시티는 자사 제품에 아스트라를 추가하며 내부 평가에서 가장 좋은 결과를 냈다고 X에 밝혔습니다.
실제 제품 환경에서 모델을 비교했다는 점에는 의미가 있습니다. 그러나 문항과 채점 방식이 공개되지 않았고, 시험한 곳과 발표한 곳도 같습니다.
따라서 「아스트라가 가장 뛰어나다」보다 「퍼플렉시티의 내부 사용 조건에서 가장 높은 점수를 받았다」고 표현하는 편이 정확합니다.
제미나이 3.8 플래시는 가격을 낮췄습니다
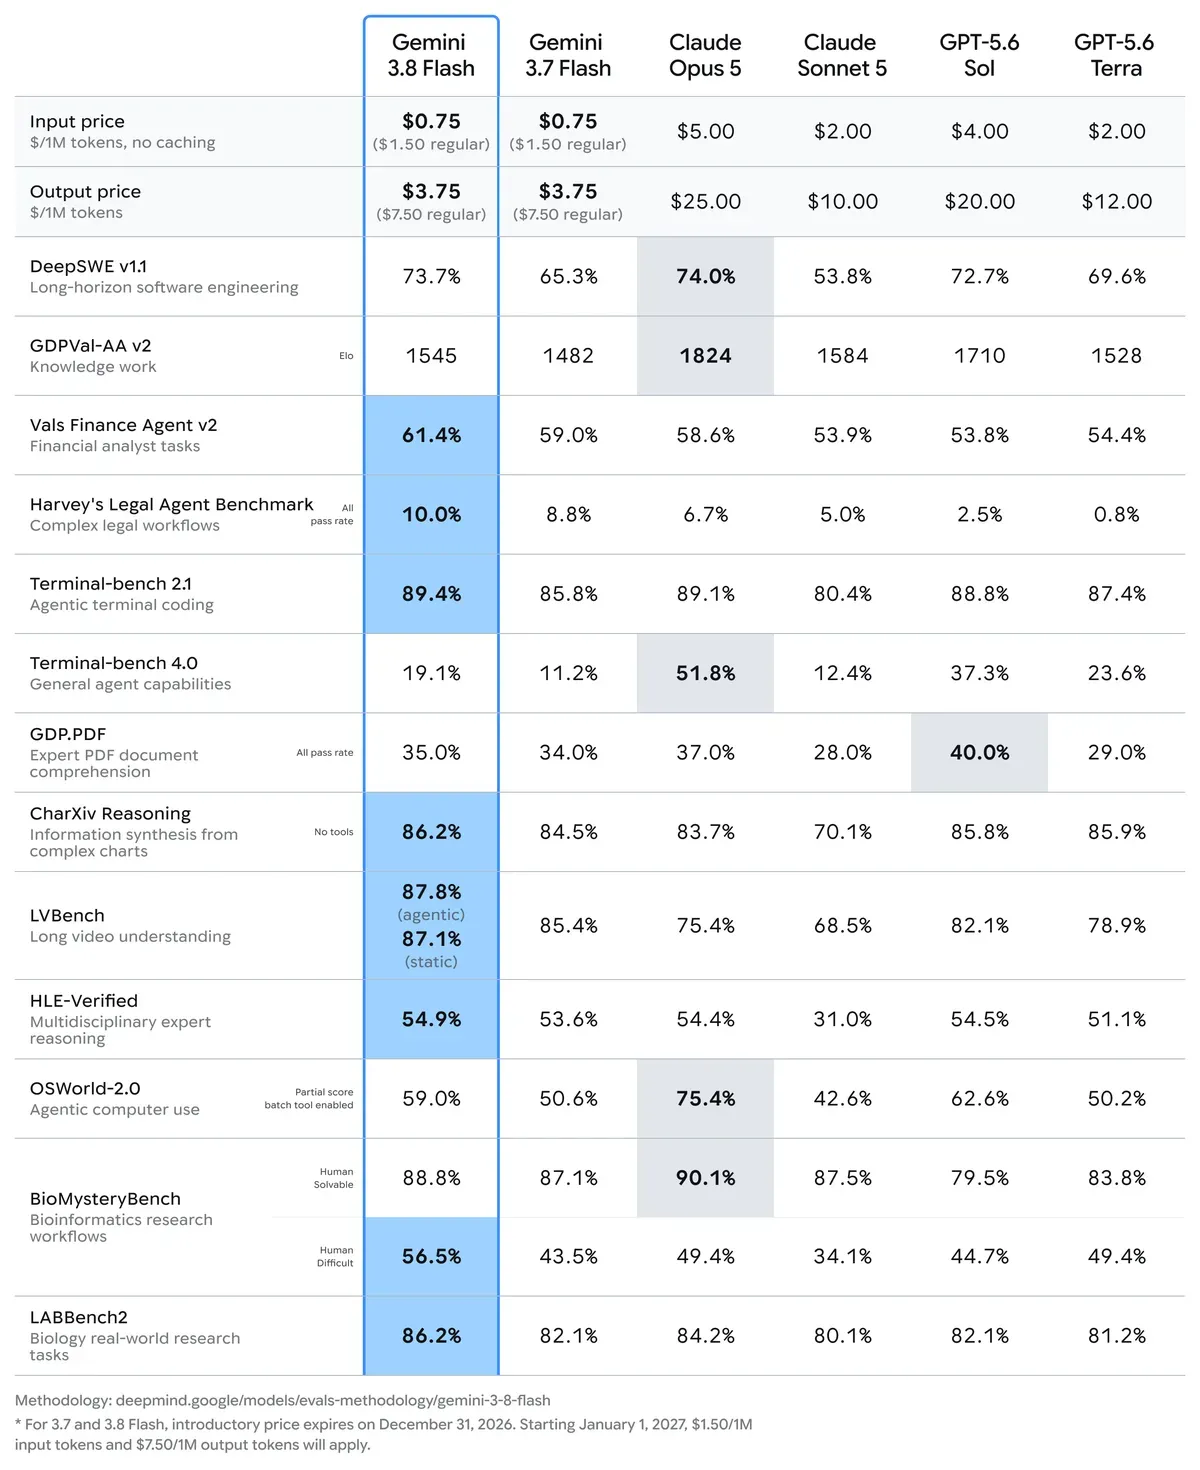
구글은 Gemini 3.8 Flash를 100만 토큰당 입력 0.75달러, 출력 3.75달러에 공개했습니다. 상위 모델에 가까운 성능을 더 낮은 가격에 제공한다는 설명입니다.
함께 발표한 3.8 Flash Cyber는 정부 기관과 기반 시설 운영자 등 신뢰할 수 있는 방어 조직에만 제한적으로 제공됩니다. 취약점 탐지 성공률이 70%를 넘었다는 수치도 구글의 자체 평가 결과입니다.
스위스 정부의 오픈소스 실험은 아직 172명입니다
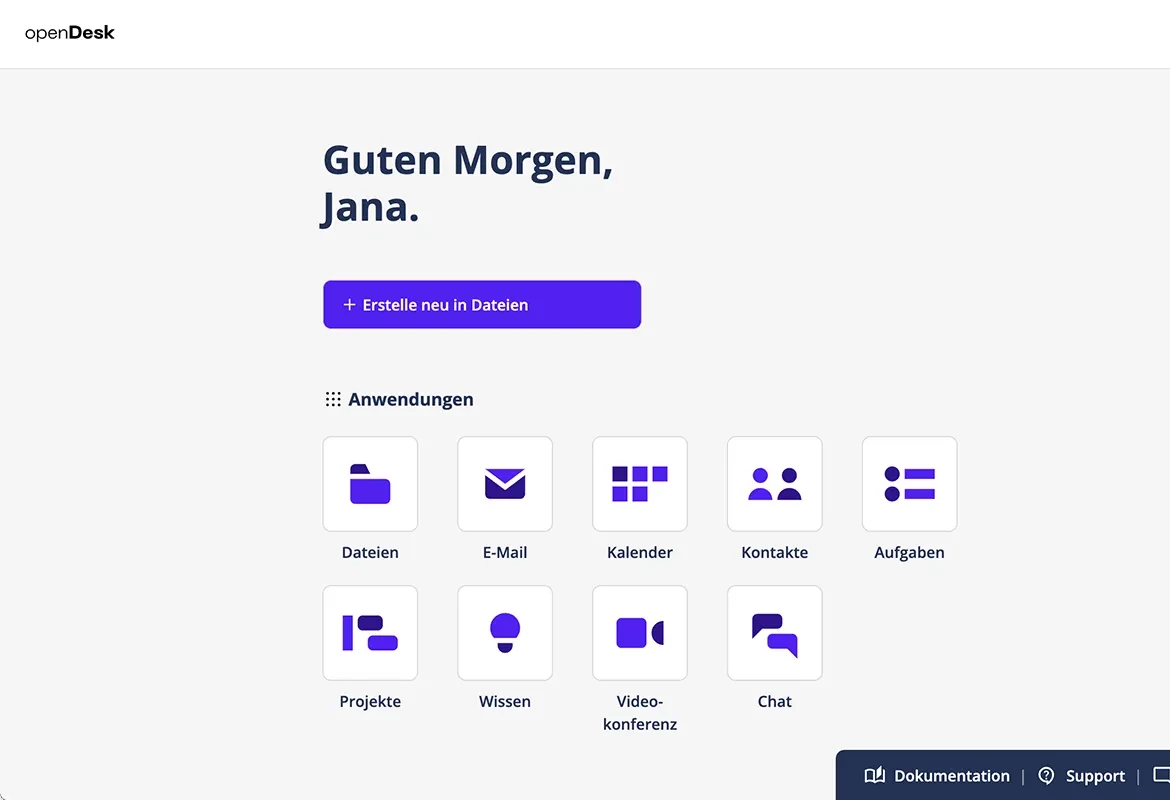
스위스 연방수상실은 오픈소스 업무 도구 openDesk를 시험하고 있습니다. 그렇다고 「스위스 정부가 마이크로소프트를 버렸다」고 말하기에는 이릅니다.
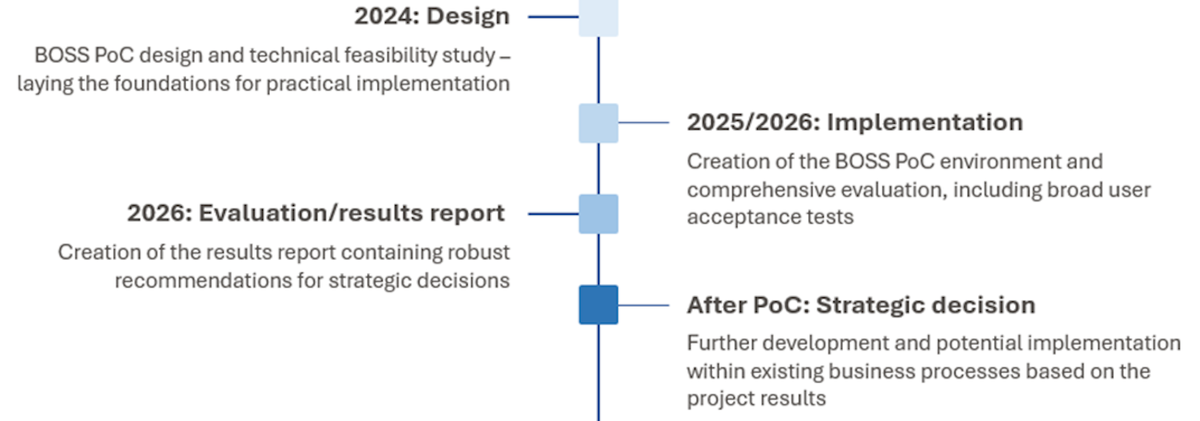
현재 참여자는 172명입니다. 3,000명으로 확대하는 데도 예산과 후속 결정이 남아 있습니다. 교체 대상 역시 운영체제가 아니라 문서·메일·일정·협업 도구입니다.
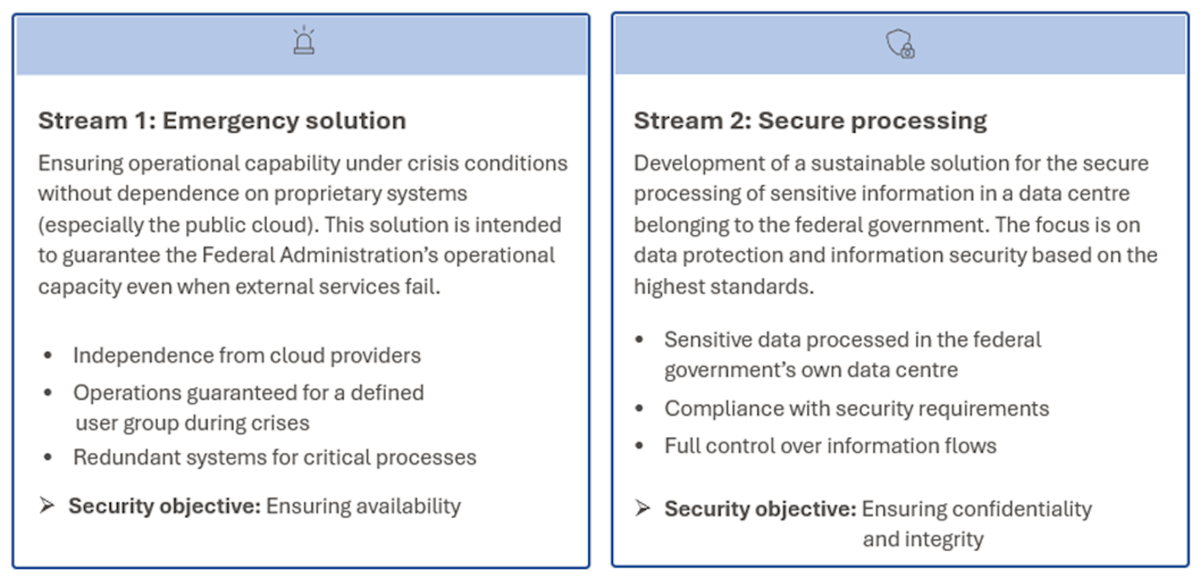
목적은 비용 절감만이 아닙니다. 외부 클라우드가 멈춰도 업무를 이어갈 수 있는지, 민감한 정보를 자체 데이터센터에서 처리할 수 있는지를 확인하는 데이터 주권 실험에 가깝습니다.
읽고 나서 해 볼 것
AI가 무언가를 「해냈다」는 기사를 볼 때는 세 가지를 먼저 확인해야 합니다. 누가 시험했는가, 원자료가 공개됐는가, 다른 사람이 다시 확인할 수 있는가. 기계가 논리를 단계별로 검사한 증명과 개발사가 자체 시험 뒤 발표한 점수는 같은 무게로 읽을 수 없습니다.
출처
각주 8개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 2026-09-06 보도 시점 기준으로 GPT-6 Astra 는 2026 수능 총점 450점 만점에 450점으로 1위였고, 2위 GPT-5.6 Sol (max) 는 448.5점이었다 (차이 1.5점)Total Score (450 points max)https://hehee9.github.io/CSAT-benchmark/확인 2026-09-08현재 순위는 GPT 6-아스트라(450점 만점)에 이어 ▲GPT-5.6 솔(max, 448.5점)https://www.aitimes.com/news/articleView.html?idxno=214896확인 2026-09-08↩
- 이 시험은 웹 검색 등 외부 도구 없이 모델 자체 지식만으로 풀렸고, 450점은 국어·수학·영어·한국사에 탐구 4과목(물리I·화학I·생명과학I·사회문화) 평균의 2배를 더해 구성된다. 저장소는 MIT 라이선스로 코드와 원자료가 공개돼 있다This dataset records and summarizes the results of various LLMs solving Korean CSAT and mock exam questions. / No tool usage: Ordinary user environments may use web search and other tools when needed, but this test answered using only the model's own knowledge. / This project is distributed under the MIT License. See the LICENSE file for details. / The 2026 Korean CSAT problems are copyrighted works of the Korea Institute for Curriculum and Evaluation (KICE). This repository does not include the original problems.https://raw.githubusercontent.com/hehee9/CSAT-benchmark/master/README_en.md확인 2026-09-10↩
- hehee9 CSAT Benchmark 는 2026-09-08 커밋 60c4c225 로 대시보드를 다중 시험·다중 모드 구조로 개편했고, 저장소 README 는 「모델 전반의 성능이 좋아져서 옛 Hard 모드를 Normal 로, 옛 Normal 모드를 Easy 로 이름을 바꿨다」고 적고 있다The former Hard mode has been renamed Normal, and the former Normal mode has been renamed Easy, as LLM performance has improved across models. / Normal Mode: Every question in a section is solved in one request. / Easy Mode: Each question is solved once in its own request. This mode applies only to the 2026 CSAT.https://raw.githubusercontent.com/hehee9/CSAT-benchmark/master/README_en.md확인 2026-09-11feat: publish multi-exam dashboard and September Astra resultshttps://github.com/hehee9/CSAT-benchmark/commit/60c4c225확인 2026-09-10↩
- hehee9 CSAT Benchmark 대시보드의 「일반」 모드(한 과목 문항을 한 번에 제출)에서 GPT-6 Astra (high) 의 2026 수능 총점은 448.5점이고 GPT-5.6 Sol Pro (high) 와 공동 1위다"model_name": "GPT-6 Astra (high)", "subject": "사회문화", "score": "47", "total_points": "50"https://hehee9.github.io/CSAT-benchmark/benchmarks/csat-2026/default/results.json확인 2026-09-11고난도 모드에서는 사회문화 8번 한 문항을 틀려 448.5점으로 GPT-5.6 Sol Pro와 같은 점수를 기록함 / 고난도 모드는 더 어려운 문제를 추가하는 것이 아니라, 같은 과목의 모든 문제를 한 번에 풀게 하는 방식https://news.hada.io/topic?id=33307확인 2026-09-11↩
- 2026 수능 사회문화 8번에서 GPT-6 Astra (high) 는 한 문항씩 제출한 「쉬움」 모드에서는 맞혔고, 한 과목을 한 번에 제출한 「일반」 모드에서는 틀렸다. 두 모드에서 답이 갈린 문항은 이것 하나다{"question_number": 8, "extracted_answer": 4, "correct_answer": 5, "is_correct": False}https://hehee9.github.io/CSAT-benchmark/benchmarks/csat-2026/default/results.json확인 2026-09-11{"question_number": 8, "extracted_answer": 5, "correct_answer": 5, "is_correct": True}https://hehee9.github.io/CSAT-benchmark/benchmarks/csat-2026/easy/results.json확인 2026-09-11기존 모델들이 어려워했던 사회문화 8번도 해결함 / 고난도 모드에서는 사회문화 8번 한 문항을 틀려 448.5점으로 GPT-5.6 Sol Pro와 같은 점수를 기록함 / 고난도 모드는 더 어려운 문제를 추가하는 것이 아니라, 같은 과목의 모든 문제를 한 번에 풀게 하는 방식https://news.hada.io/topic?id=33307확인 2026-09-11↩
- 그 대시보드는 모델의 지식 컷오프가 시험 시행월(2025-11)보다 뒤면 「문제 학습 가능성 있음」(영문판 Possible exposure to exam content) 표시를 붙이며, model_metadata.json 은 GPT-6 Astra (high) 의 knowledgeCutoff 를 2026-04 로 적고 있다export function hasPostExamKnowledgeCutoff(modelName, modelMetadata = {}, examMonth = null) { const knowledgeCutoff = modelMetadata?.[modelName]?.knowledgeCutoff; return typeof knowledgeCutoff === 'string' && typeof examMonth === 'string' && knowledgeCutoff > examMonth }https://raw.githubusercontent.com/hehee9/CSAT-benchmark/master/web/src/utils/modelMeta.js확인 2026-09-11"GPT-6 Astra (high)": { "description": { "ko": "ChatGPT Plus 사용자용 모델 또는 그와 동급", "en": "For ChatGPT Plus users or an equivalent model" }, "knowledgeCutoff": "2026-04" }https://hehee9.github.io/CSAT-benchmark/model_metadata.json확인 2026-09-11"postExamKnowledgeCutoff": "문제 학습 가능성 있음"https://raw.githubusercontent.com/hehee9/CSAT-benchmark/master/web/src/locales/ko.json확인 2026-09-11↩
- OpenAI 공식 개발자 문서는 GPT-6 Astra 의 지식 컷오프를 2026년 4월 30일로 적고 있다. 2026학년도 수능은 2025년 11월에 치러졌으므로, 시험일은 이 모델의 학습 자료 시점 안에 든다Apr 30, 2026 knowledge cutoffhttps://developers.openai.com/api/docs/models/gpt-6-astra확인 2026-09-08↩
- Anthropic 은 2026-09-04 발표에서 클로드가 11일간 대부분 자율적으로 작업해 페르마의 마지막 정리에 대한 최초의 완전한 컴퓨터 검증 증명을 린(Lean) 언어로 작성했다고 밝혔다. 코드 1,300만 줄 · 중간 정리 29,500개이며, 결과는 린이 검사했고 표준 공리 3개만 사용했다In 11 days, working largely autonomously, Claude produced the first end-to-end, computer-checked proof of FLT. / At 13 million lines of Lean code, Claude's proof is over 5x the size of Mathlib, the principal community library of mathematical proofs this theorem builds on. / Claude completed the proof in 11 days, producing computer-verifiable proofs of 30,300 theorems along the way (using 29,500 in the final proof). / The finished proof was checked by Lean; it uses just Lean's three standard axioms, and a comparator confirmed that the theorem's statement matches Mathlib's own statement of FLT.https://www.anthropic.com/research/formalizing-fermats-last-theorem확인 2026-09-08↩