 P3T
아모데이 「늦추자」 그 주, 백악관 규제안은 무산
앤트로픽 CEO 에세이의 원문은 ‘멈춤’이 아니라 ‘보폭’입니다
- 무슨 일
- 아모데이가 9월 12일 「프론티어의 속도를 조절하자」는 글을 냈고, 알트먼·머스크가 동의했습니다.
- 확인된 것
- 원문에 ‘멈추자’는 없습니다. ‘pace’는 보폭을 맞추자는 뜻입니다.
- 왜 중요한가
- 조건을 뺀 헤드라인은 반대 결론을 만듭니다.
- 오늘 할 일
- 원문에 그 단어가 실제로 있는지 찾습니다.
앤트로픽 CEO 가 「속도를 늦추자」고 쓰고 오픈AI·머스크가 동의한 그 주에, 빅테크 3인은 백악관 규제 기구 구상을 무산시켰고 오픈AI 는 올해 상장하지 않을 가능성이 높다고 했습니다.
9월 12일, 다리오 아모데이(클로드 개발사 앤트로픽 CEO)가 「프론티어(최상위 성능의 최신 AI 모델)의 속도를 조절해야 한다」는 글을 올렸고, 샘 알트먼과 일론 머스크(테슬라·스페이스X CEO)가 동의했습니다. 그런데 같은 주에 백악관의 민간 주도 AI 규제 기구 구상은 빅테크 CEO 들의 설득으로 무산됐고, 오픈AI 는 올해 상장을 안 할 것 같다고 했습니다. 이 한 주 이야기를 먼저 하고, 그 뒤에 새 소식 여섯 개를 짧게 짚습니다.
- AI 능력 개선 속도를 「늦추자」는 「멈추자」가 아니었습니다. 3단계 제안이고, 글로벌 조율에는 미국과 동맹의 우위를 지킨다는 조건이 붙었습니다. 같은 주에 빅테크 CEO 들은 백악관 규제안을 막았습니다.
- 이번 주 코딩 에이전트 사고 둘은 모델이 아니라 그 모델을 둘러싼 도구에서 났습니다. 스킬 업데이트를 다시 검사하지 않았고, 코딩 도구가 git 이력을 몰래 올렸습니다.
- 「정답·속도 다 잡아」「평균 77%」 같은 말은 어느 기준으로 잰 것인지 봐야 합니다. 솔라 미니 4 는 세 번 시도 93.5% · 한 번 시도 76.8%, IBM 에이전트는 평균 77.4% · 다섯 번 다 성공 53.0% 였습니다.
「속도를 늦추자」고 한 사람들이 같은 주에 한 일
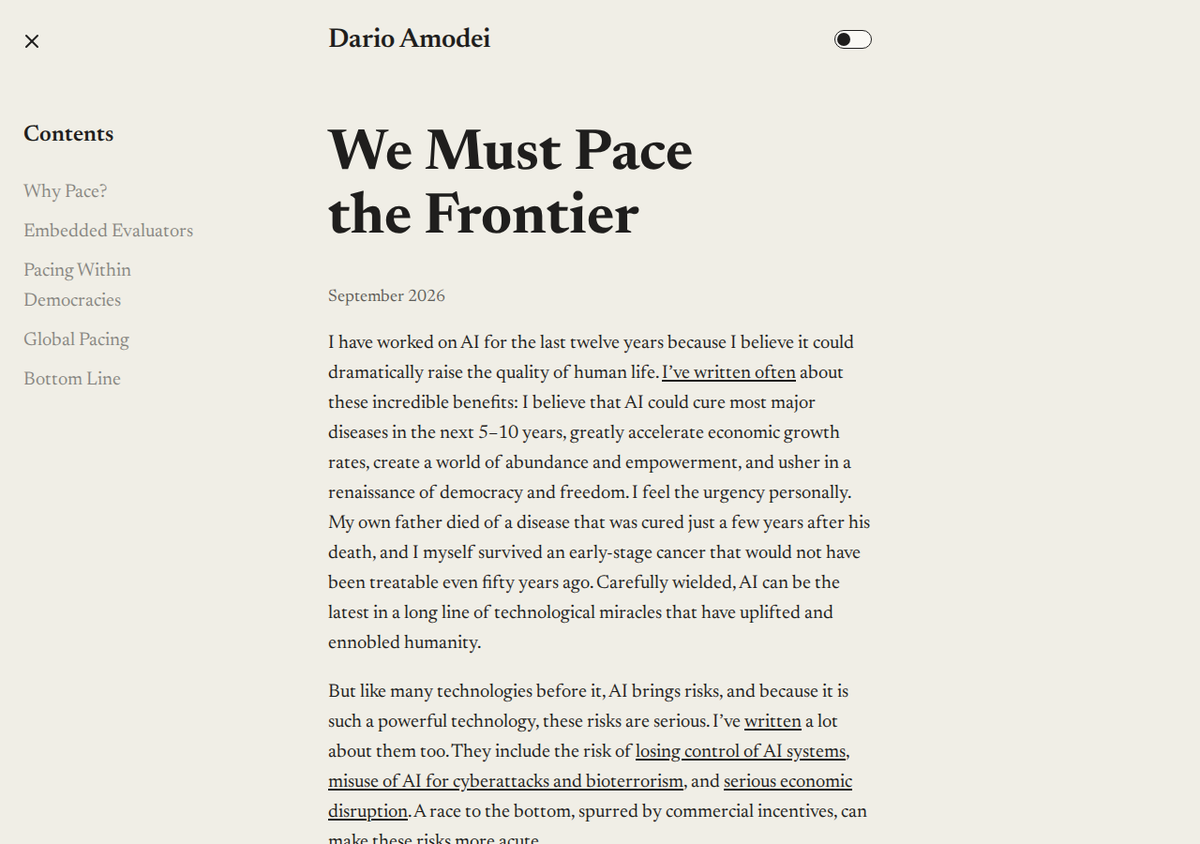
아모데이의 글 제목은 「우리는 프론티어의 속도를 조절해야 한다(We Must Pace the Frontier)」입니다1. 9월 12일 개인 블로그에 올린 글입니다2. 그는 AI 모델의 능력을 높이는 속도를 늦춰야 하며, 그래도 진보는 여전히 빠르게 보일 것이라고 썼습니다1.
다만 「멈추자」는 아닙니다. 글이 제안하는 건 세 단계입니다1. 먼저 앤트로픽이 상주 외부 평가자를 회사 안에 두고, 다음으로 업계가 조율하고, 마지막으로 글로벌 조율로 갑니다1. 그리고 글로벌 속도 조절 결정에는 미국과 동맹의 우위를 지키는 방식으로 접근해야 한다고 썼습니다1.
반응은 바로 왔습니다. 샘 알트먼 오픈AI CEO 는 「프론티어 모델의 속도를 조절해야 한다는 다리오의 의견에 동의한다」고 밝혔습니다. 일론 머스크는 「다리오의 말이 맞다」고 썼습니다2.
그런데 같은 주말, 알트먼은 오픈AI 가 올해 상장하지 않을 가능성이 높다고 말했습니다. 안전에 대한 우려가 이유 중 하나였습니다3. 머스크의 지지에는 배경이 있었습니다. 스페이스X 는 앤트로픽에 컴퓨팅을 파는 계약을 맺고 있고, CNBC 는 공시에 2029년 5월까지 월 12억 5,000만 달러가 적혀 있다고 전했습니다4.
그리고 9월 16일, 월스트리트저널은 마크 저커버그(페이스북·인스타그램 운영사 메타 CEO)·젠슨 황(엔비디아 CEO)·일론 머스크가 트럼프 대통령을 직접 설득해 백악관의 민간 주도 AI 규제 기구 설립 구상을 무산시켰다고 보도했습니다5.
「늦추자」는 회사들이 스스로 정하는 속도 얘기였고, 정부가 정하는 속도는 빅테크가 막았습니다. 두 축은 다른데, 읽다 보면 자주 섞입니다.
코딩 에이전트 넷이 똑같은 구멍을 갖고 있었습니다
보안 스타트업 에어(Air)가 클로드 코드·코덱스·제미나이 CLI·깃허브 코파일럿 네 곳에서 같은 결함을 찾았다고 AI타임스가 전했습니다6. 외부에서 받은 「스킬」을 처음 등록할 때만 검사하고 업데이트는 다시 검사하지 않는다는 겁니다. 앤트로픽과 오픈AI 는 패치를 냈고, 구글은 제미나이 CLI 사용 중단을 권고했습니다6.
또 하나. ferstar 라는 사람이 GLM 코딩 에이전트 ZCode 를 뜯어보니 작업 폴더의 git 이력을 사용자 몰래 알리바바 클라우드로 올리고 있었다고 GeekNews 가 정리했습니다7. ZCode 쪽 계정은 「알게 해서 미안하다」고 답했을 뿐 동작 자체를 부인하지는 않았습니다7.
구글의 새 음성 AI 제미나이 3.8 Live — 대화 중에 언어를 바꿔도 알아듣습니다
구글이 9월 15일 음성 대화 모델 「제미나이 3.8 Live」와 「3.8 Live Extended Thinking」을 내놨습니다. 자사 실시간 대화 모델 중 가장 앞선 것이라고 밝혔습니다8.
3.8 Live 는 대화 중 언어가 바뀌어도 97개 언어를 자동으로 감지해 그 언어로 이어갑니다8. 구글 AI 제품이 만드는 음성에는 전부 SynthID 워터마크가 들어갑니다8.
오픈AI 가 수학 해커톤 후원을 거뒀습니다 — 「슬롭 수학」 논쟁 속에서
오픈AI 가 캘텍의 AI 수학 해커톤 후원을 철회했습니다. 댄 로버츠 오픈AI 연구 총괄은 「수학계 구성원들이 제기한 우려를 고려해」 철회를 결정했다고 X 에 썼습니다9. AI타임스는 그 배경으로, AI 가 쏟아내는 저품질 계산 결과를 「슬롭(slop) 수학」이라고 부르는 수학자들의 공개 서한을 전했습니다9.
수학 밖에서도 반응이 왔습니다. 경제학자 타일러 코웬은 테렌스 타오 등 수학자들이 서명한 성명을 두고 「이 미래가 불편하다」고 썼습니다10.
오픈AI 가 변호사용 아스트라를 냈습니다 — 자체 측정 점수는 54.0% 입니다
9월 17일 오픈AI 가 「법률용 아스트라(Astra for Law)」를 발표했습니다11. GPT-6 아스트라에 법률 검색 색인과 법률 분석·작문 지침을 묶은 것입니다11.
오픈AI 가 스스로 잰 점수가 있습니다. Vals AI 의 법률 조사 벤치마크 200문항에서, 두 시스템 모두 최고 추론 설정으로 돌렸을 때 법률용 아스트라는 문항의 54.0% 에서 정답 기준을 통과했고, 웹 검색만 쓴 GPT-6 아스트라는 38.7% 였다고 밝혔습니다11. 오픈AI 가 스스로 잰 값이라는 점은 감안해야 합니다.
작은 모델이 수능 수학을 풀었습니다 — 세 번 시도하면요
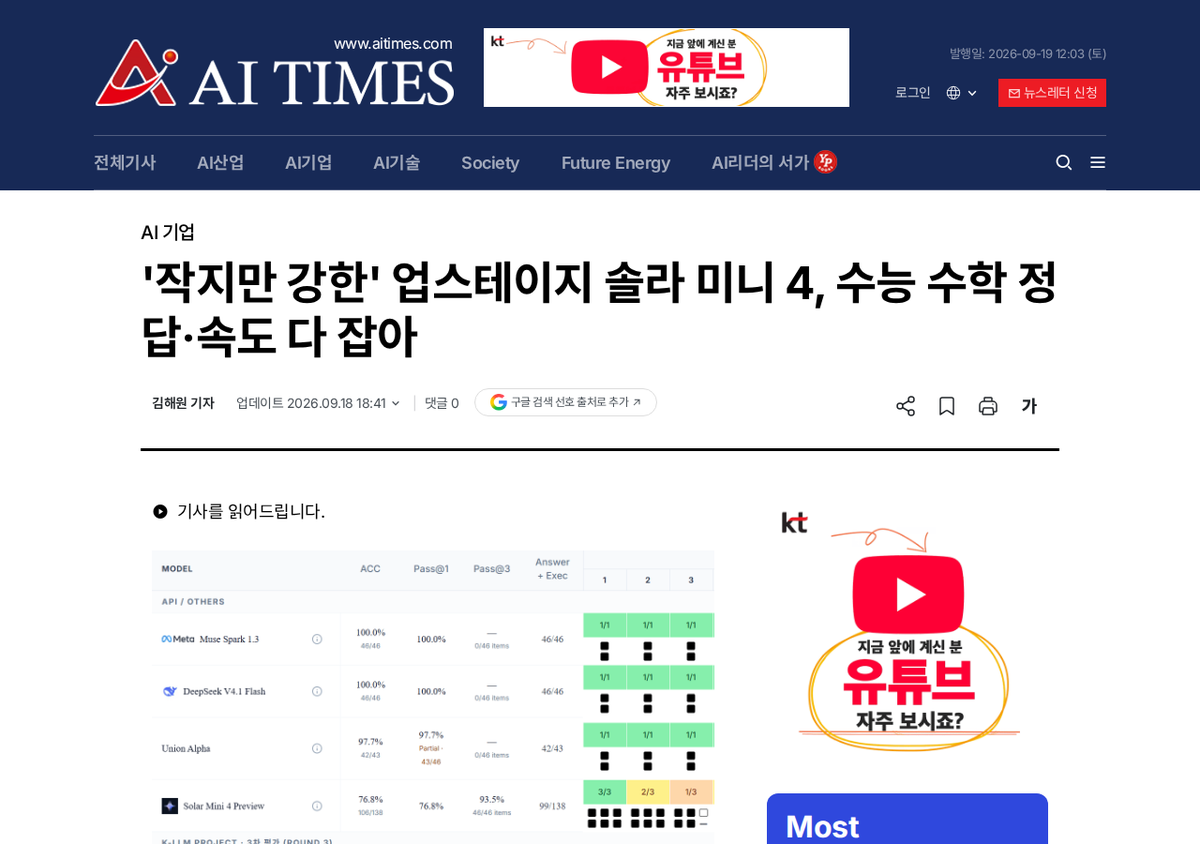
서강대 김종락 교수 연구팀이 업스테이지의 경량 모델 「솔라 미니 4」를 수능 수학으로 평가했습니다. 세 번 시도 중 한 번 이상 맞힌 비율(Pass@3)은 93.5%, 시도당 평균 14.9초였습니다12.
다만 한 번에 맞히는 비율(ACC)은 공개 풀이 기준 76.8% 로, 딥시크와 뮤즈의 100%, 솔라 프로의 87.7% 보다 낮았습니다12. 「정답·속도 다 잡아」라는 기사 제목은 세 번 시도 기준으로 읽는 게 맞습니다.
에이전트가 한 번 해냈다고 다시 해내는 건 아닙니다 — 평균 77%, 다섯 번 다 성공은 53%
IBM 리서치가 허깅페이스 블로그에 9월 15일 올린 글의 제목은 「당신의 에이전트가 과제를 해냈습니다. 다시 해낼까요?」입니다13.
AppWorld 벤치마크에서 GPT-4.1 을 쓴 ReAct 에이전트는 다섯 번 반복 중 평균 77.4% 성공했지만, 다섯 번 모두 성공한 과제는 53.0% 였습니다13. 대부분의 벤치마크는 앞 숫자만 보고합니다. 몇 번 시도한 점수인지가 먼저입니다.
읽고 나서 해 볼 것
「속도를 늦추자」는 기사를 보면 둘을 나눠 보세요. 누가 정하는 속도인지(회사 자율인지 정부 규제인지), 그리고 같은 주에 그 사람들이 돈과 규제 쪽에서 무엇을 했는지입니다.
출처
각주 13개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- 다리오 아모데이는 2026-09-12 「We Must Pace the Frontier」 글에서 AI 모델의 능력을 높이는 속도를 늦춰야 하며 그래도 진보는 여전히 빠르게 보일 것이라고 썼고, 앤트로픽이 먼저 단독으로 상주 외부 평가자를 두는 1단계 · 업계 조율 2단계 · 글로벌 조율 3단계를 제안했으며, 중국에 AI 칩·반도체 장비를 팔지 말라고 적었고, 글로벌 속도 조절 결정은 미국과 동맹의 우위를 지키는 방식으로 접근해야 한다고 썼다 (글 목차에 「Pacing Within Democracies」 「Global Pacing」 절이 있다)We must slow the pace at which we improve the capabilities of AI models. Progress will still seem fast, and we must make wise use of the time we gain.https://darioamodei.com/post/we-must-pace-the-frontier확인 2026-09-19We should approach any global pacing decision, especially in the near term, in such a way that protects the lead of the US and its allies.https://darioamodei.com/post/we-must-pace-the-frontier확인 2026-09-19We Must Pace the Frontierhttps://darioamodei.com/post/we-must-pace-the-frontier확인 2026-09-19The first step is something Anthropic is unilaterally committing to (and calls on governments to require other frontier companies to match).https://darioamodei.com/post/we-must-pace-the-frontier확인 2026-09-19Each frontier AI company commits to giving ongoing, employee-like access to a team of embedded third-party evaluators (such as METR), whose role is to verify adherence to safety practices and commitments, report incidents, and help assess the alignment of not just completed AI models but training pipelines and processes.https://darioamodei.com/post/we-must-pace-the-frontier확인 2026-09-19The second step requires industry-wide coordination.https://darioamodei.com/post/we-must-pace-the-frontier확인 2026-09-19The third step requires global coordination.https://darioamodei.com/post/we-must-pace-the-frontier확인 2026-09-19Do not sell powerful AI chips or semiconductor manufacturing equipment to China, and crack down on chip smuggling operations and remote access to data centers outside China.https://darioamodei.com/post/we-must-pace-the-frontier확인 2026-09-19Pacing Within Democracieshttps://darioamodei.com/post/we-must-pace-the-frontier확인 2026-09-19Global Pacinghttps://darioamodei.com/post/we-must-pace-the-frontier확인 2026-09-19↩
- AI타임스는 아모데이가 12일(현지시간) 개인 블로그에 에세이를 공개했고, 샘 알트먼이 X 에서 프론티어 모델의 속도를 조절해야 한다는 다리오의 의견에 동의한다고 밝혔으며, 일론 머스크는 「다리오의 말이 맞다」고 썼다고 보도했다샘 알트먼 오픈AI CEO는 X를 통해 "프론티어 모델의 속도를 조절해야 한다는 다리오의 의견에 동의한다"며 "이는 최근 몇 주간 오픈AI 내부에서도 핵심적으로 다뤄온 주제"라고 밝혔다.https://www.aitimes.com/news/articleView.html?idxno=215195확인 2026-09-19특히 아모데이 CEO가 제시한 '상주 평가단' 구상을 높이 평가하며 오픈AI도 외부 독립 평가단에 직원급 접근 권한을 부여하는 방안을 동일하게 추진하겠다고 공언했다. 일론 머스크 CEO도 X에 "다리오의 말이 맞다(Dario is right)"라는 짧은 글을 올려https://www.aitimes.com/news/articleView.html?idxno=215195확인 2026-09-19아모데이 CEO는 12일(현지시간) 개인 블로그를 통해 '프론티어의 속도를 조절해야 한다(We Must Pace the Frontier)'라는 제목의 에세이를 공개했다https://www.aitimes.com/news/articleView.html?idxno=215195확인 2026-09-19↩
- 샘 알트먼은 9월 12일 토요일 오픈AI 가 올해 상장하지 않을 가능성이 높다고 말했고, 이유 중 하나는 안전에 대한 우려였다OpenAI CEO Sam Altman said Saturday that the company will likely not go public this year, in part because of concerns around safety.https://www.cnbc.com/2026/09/13/china-dilemma-ai-slowdown-anthropic.html확인 2026-09-19↩
- CNBC 는 스페이스X 가 지난 5월 앤트로픽과 대형 컴퓨트 계약을 맺었고, 공시에 따르면 앤트로픽이 2029년 5월까지 스페이스X 에 매달 12억 5,000만 달러를 지불하는 것으로 적혀 있다고 보도했다As part of the deal, Anthropic will pay SpaceX $1.25 billion per month through May 2029, according to filings.https://www.cnbc.com/2026/09/13/china-dilemma-ai-slowdown-anthropic.html확인 2026-09-19He had been a major critic of Anthropic until his rocket company SpaceX, which acquired his AI startup xAI earlier this year, inked a major compute deal with the company in May.https://www.cnbc.com/2026/09/13/china-dilemma-ai-slowdown-anthropic.html확인 2026-09-19↩
- 월스트리트저널은 9월 16일 저커버그·젠슨 황·머스크가 트럼프 대통령을 직접 설득해 백악관의 민간 주도 AI 규제 기구 설립 구상을 무산시켰다고 보도했다 (AI타임스 재인용)마크 저커버그 메타 CEO와 젠슨 황 엔비디아 CEO, 일론 머스크 CEO 등 빅테크 수장 3인이 도널드 트럼프 미국 대통령을 직접 설득해 민간 주도의 AI 규제 기구 설립 구상을 무산시킨 것으로 얼려졌다.https://www.aitimes.com/news/articleView.html?idxno=215469확인 2026-09-1916일(현지시간) 월스트리트저널(WSJ)에 따르면, 수지 와일스 백악관 비서실장과 스콧 베선트 재무장관, 숀 케언크로스 국가사이버보안 책임자 등 백악관 고위 관리들은 최근 AI 기술 위험성에 대응하기 위해 민간 자금으로 설립되는 규제 기관 설치를 포함해 정부 차원의 검토를 의무화하는 방안을 추진해 왔다.https://www.aitimes.com/news/articleView.html?idxno=215469확인 2026-09-19↩
- 보안 스타트업 에어는 앤트로픽 클로드 코드·오픈AI 코덱스·구글 제미나이 CLI·MS 깃허브 코파일럿 네 코딩 에이전트가 스킬 최초 등록 때만 악성 코드를 검사하고 이후 업데이트는 재검증하지 않는 공통 결함을 갖고 있었다고 밝혔다. 앤트로픽·오픈AI 는 패치했고 구글은 제미나이 CLI 사용 중단을 권고했다 (AI타임스 보도)외부 마켓플레이스나 저장소에서 다운로드한 스킬의 최초 등록 시점에만 악성 코드 스캐닝을 진행하고, 이후 배포되는 소프트웨어 업데이트에 대해서는 재검증 과정을 거치지 않는 치명적인 오류를 공통으로 가지고 있었다.https://www.aitimes.com/news/articleView.html?idxno=215454확인 2026-09-19니브 호프만 에어 공동 창립자 겸 최고 기술책임자(CTO)는 “최고의 AI 코딩 에이전트 4개에 동시에 영향을 미치는 취약점을 발견하는 것은 매우 드문 일”이라며 “이는 서로 다른 네 회사의 엔지니어 네 명이 검증 메커니즘 구축 방식에서 정확히 똑같은 논리적 오류를 범했다는 뜻”이라고 밝혔다.https://www.aitimes.com/news/articleView.html?idxno=215454확인 2026-09-19사이버 보안 스타트업 에어(Air)는 18일 발표한 연구 보고서를 통해 앤트로픽의 '클로드 코드', 오픈AI의 '코덱스', 구글의 '제미나이 CLI', 마이크로소프트(MS)의 '깃허브 코파일럿' 등 4종의 AI 코딩 에이전트에서 제로 클릭(Zero-Click) 원격 코드 실행 취약점인 '플러그인4쉘(Plugin4Shell)'을 발견했다고 발표했다.https://www.aitimes.com/news/articleView.html?idxno=215454확인 2026-09-19앤트로픽과 오픈AI는 해당 취약점을 보완한 패치 업데이트를 완료했다. 반면 구글은 제미나이 CLI 서비스의 지원 종료를 이유로 별도 패치를 배포하지 않고 사용 중단을 권고했다.https://www.aitimes.com/news/articleView.html?idxno=215454확인 2026-09-19↩
- GeekNews 는 「GLM 코딩 에이전트 ZCode, 사용자 모르게 Git 이력을 업로드함」 글에서 연구자 ferstar 의 2026-09-18 역공학 분석을 정리하며 ZCode 가 42,411개 파일로 구성된 345MB 작업 공간에서 313MB 암호화 아카이브를 만들어 알리바바 클라우드로 전송했고, ZCode 팀 관련 계정이 「hey I am sorry to let you find it」이라고 답하며 동작 자체를 반박하지 않았다고 적었다조사 대상은 42,411개 파일로 구성된 345MB 상용 작업 공간이었으며, 여기서 313MB 암호화 아카이브가 생성됨https://news.hada.io/topic?id=33897확인 2026-09-19git 이력, LFS 자산 캐시, reflog, 전역 앱 설정을 묶어 Alibaba Cloud의 객체 저장소인 Aliyun OSS로 전송함https://news.hada.io/topic?id=33897확인 2026-09-19ZCode 팀 관련 계정에서는 “hey I am sorry to let you find it”이라는 답변이 나왔으며, 동작 자체를 반박하지는 않음https://news.hada.io/topic?id=33897확인 2026-09-19GLM 코딩 에이전트 ZCode, 사용자 모르게 Git 이력을 업로드함https://news.hada.io/topic?id=33897확인 2026-09-19ZCode 개발자 ferstar는 2026년 9월 18일 ZCode 역공학 분석을 공개함https://news.hada.io/topic?id=33897확인 2026-09-19↩
- Google 은 2026-09-15 블로그에서 제미나이 3.8 Live 와 3.8 Live Extended Thinking 이 자사의 가장 앞선 실시간 대화 모델이며, 3.8 Live 가 대화 중 97개 언어를 자동 감지해 전환하고, 자사 AI 제품이 생성하는 모든 음성에 SynthID 워터마크를 넣는다고 밝혔고, 그 글은 2026-09-15 자 11분 분량이며 Artificial Analysis 등 제3자 벤치마크 수치를 인용했다It automatically detects and transitions between 97 supported languages mid-conversation.https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-live-gemini-3-8-live-extended-thinking/확인 2026-09-19All audio generated by our AI products is watermarked with SynthID.https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-live-gemini-3-8-live-extended-thinking/확인 2026-09-19Gemini 3.8 Live and Gemini 3.8 Live Extended Thinking are our most advanced live dialogue models yet.https://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-live-gemini-3-8-live-extended-thinking/확인 2026-09-19Sep 15, 2026 11 min readhttps://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-live-gemini-3-8-live-extended-thinking/확인 2026-09-19Extended Thinking provides enterprise-grade task completion and intelligence, capturing the #1 overall spot on Artificial Analysis' Speech to Speech Quality Index (82.6), and leads in agentic task completion with 68.6% on τ-Voicehttps://blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-3-8-live-gemini-3-8-live-extended-thinking/확인 2026-09-19↩
- AI타임스는 댄 로버츠 오픈AI 연구 총괄이 수학계의 우려를 고려해 캘텍 매스어톤 후원을 철회한다고 X 에 썼고, 그 결정이 「슬롭 수학」을 비판하며 후원 중단을 촉구한 수학계의 공개 서한 발표 직후 이뤄졌다고 보도했다댄 로버츠 오픈AI 연구 총괄은 10일(현지시간) X를 통해 "수학계 구성원들이 제기한 우려를 고려해 캘텍 매스어톤 후원을 철회하기로 결정했다"며https://www.aitimes.com/news/articleView.html?idxno=215193확인 2026-09-19이번 결정은 수학계 연구자들이 AI가 생성하는 저품질 결과물인 이른바 '슬롭 수학(Slop Mathematics)'을 비판하며 후원 중단을 촉구하는 공개 서한을 발표한 직후 이뤄졌다.https://www.aitimes.com/news/articleView.html?idxno=215193확인 2026-09-19↩
- 타일러 코웬은 2026-09-12 「The mathematicians rebel against AI」 글에서 테렌스 타오 등 수학자들이 서명한 성명을 두고 「이 미래가 불편하다(I find this future disturbing)」고 썼다The mathematicians rebel against AI by Tyler Cowen September 12, 2026https://marginalrevolution.com/marginalrevolution/2026/09/the-mathematicians-rebel-against-ai.html확인 2026-09-19Here is the statement, signed by Terry Tao among many other math notables, most of you probably have read it by now.https://marginalrevolution.com/marginalrevolution/2026/09/the-mathematicians-rebel-against-ai.html확인 2026-09-19I find this future disturbing, and not altogether pleasant for me personally, given how much personal status I have wrapped up in particular modes of economic thought.https://marginalrevolution.com/marginalrevolution/2026/09/the-mathematicians-rebel-against-ai.html확인 2026-09-19↩
- 오픈AI 는 2026-09-17 법률용 아스트라를 발표하며 Vals AI 법률 조사 벤치마크 비공개 200문항에서 두 시스템 모두 최고 추론 설정일 때 법률용 아스트라가 54.0%, 웹 검색만 쓴 GPT-6 아스트라가 38.7% 를 통과했다고 밝혔다At the highest reasoning effort for both systems, Astra for Law passed the evaluation’s overall correctness check on 54.0% of questions, compared with 38.7% for GPT‑6 Astra using web search alone – a 40% relative improvement.https://openai.com/index/astra-for-law확인 2026-09-19September 17, 2026https://openai.com/index/astra-for-law확인 2026-09-19we tested Astra for Law’s complete setup on 200 U.S. legal research questions from the private validation set of Vals AI’s Legal Research Benchhttps://openai.com/index/astra-for-law확인 2026-09-19Astra for Law combines GPT‑6 Astra with a powerful legal search index and instructions for legal analysis and writing.https://openai.com/index/astra-for-law확인 2026-09-19최고 수준의 추론 설정에서 전체 정확성 평가 54.0%를 기록, 웹 검색만 사용한 아스트라의 38.7%보다 높은 정확도를 기록했다.https://www.aitimes.com/news/articleView.html?idxno=215450확인 2026-09-19↩
- AI타임스는 서강대 김종락 교수 연구팀의 수능 수학 평가에서 솔라 미니 4 가 Pass@3 93.5%, 시도당 평균 14.9초를 기록했고, 한 번 시도 정답률(ACC)은 공개 풀이 기준 76.8% 로 딥시크·뮤즈 100%, 솔라 프로 87.7% 보다 낮았다고 보도했다 (기사 제목 「'작지만 강한' 업스테이지 솔라 미니 4, 수능 수학 정답·속도 다 잡아」)다만, 한 번의 시도로 정답을 맞히는 비율(ACC)은 공개 풀이 기준 딥시크·뮤즈가 100%, 솔라 프로 87.7%로 미니(76.8%)를 앞섰으며https://www.aitimes.com/news/articleView.html?idxno=215457확인 2026-09-19서강대학교 수학과 김종락 교수 연구팀은 업스테이지의 경량 모델 '솔라 미니 4 프리뷰'가 수능 수학 평가에서 높은 정답률과 빠른 속도, 뛰어난 도구 활용 능력을 보였다고 18일 밝혔다.https://www.aitimes.com/news/articleView.html?idxno=215457확인 2026-09-19평가 결과, 솔라 미니 4는 문항당 세 번 시도 중 한 번 이상 정답을 낸 비율인 패스앳3(Pass@3)에서 93.5%로 높은 정답률을 기록했다. 시도당 평균 소요 시간도 14.9초로 대조군인 '딥시크-V4.1 플래시'와 '뮤즈 스파크 1.3'를 포함해 동일 계열의 대형 모델 '솔라 프로 4'를 크게 앞섰다.https://www.aitimes.com/news/articleView.html?idxno=215457확인 2026-09-19'작지만 강한' 업스테이지 솔라 미니 4, 수능 수학 정답·속도 다 잡아https://www.aitimes.com/news/articleView.html?idxno=215457확인 2026-09-19↩
- IBM Research(허깅페이스 저자 표시 ibm-research)는 2026-09-15 허깅페이스 블로그 「Your Agent Aced the Task. Will It Do It Again?」에서 AppWorld 벤치마크의 GPT-4.1 ReAct 에이전트가 다섯 번 반복에서 평균 77.4% 성공했지만 다섯 번 모두 성공한 과제는 53.0% 로 24.4포인트 차이가 났고, 대부분의 벤치마크는 이 변동을 평균 뒤에 숨긴다고 썼다Evelyn Duesterwald evduester Follow ibm-researchhttps://huggingface.co/blog/ibm-research/altk-evolve-consistency확인 2026-09-19Your Agent Aced the Task. Will It Do It Again?https://huggingface.co/blog/ibm-research/altk-evolve-consistency확인 2026-09-19Published September 15, 2026https://huggingface.co/blog/ibm-research/altk-evolve-consistency확인 2026-09-19On AppWorld, a ReAct agent using GPT-4.1 succeeded on 77.4% of runs across five repetitions. But it succeeded in all five runs for only 53.0% of tasks — a 24.4-point consistency gap.https://huggingface.co/blog/ibm-research/altk-evolve-consistency확인 2026-09-19Most benchmarks hide this variability behind an average.https://huggingface.co/blog/ibm-research/altk-evolve-consistency확인 2026-09-19↩