 P3T
Jev AI, 새 AI인가요? 원리는 전부터 있었습니다
같은 원리를 구현한 사례가 세 건 확인됐습니다. 회사는 모델 구조·병렬 샘플러·학습법을 새로 내세웁니다
- 무슨 일
- TypeSafe AI 가 9월 15일 글 대신 확률 붙은 결정을 내는 AI 「Jev」를 공개했습니다.
- 확인된 것
- 「최대 200배 빠르다」는 회사 자체 평가 값이고, 회사도 편향 가능성을 밝혔습니다.
- 왜 중요한가
- 같은 원리를 구현한 사례가 세 건 확인됐고, 회사가 새로 내세운 것은 모델 구조·병렬 샘플러·학습법입니다.
- 오늘 할 일
- 「몇 배 빠르다」는 숫자를 보면 누가 쟀는지부터 확인합니다.
Jev 가 쓰는 원리는 전부터 있던 방법이고, 회사가 새로 내세운 것은 모델 구조·병렬 샘플러·학습법입니다.
9월 15일, AI 회사 TypeSafe AI 가 Jev 라는 모델을 공개했습니다1. 챗GPT 는 질문을 받으면 답을 글로 써 내려갑니다. Jev 는 글을 쓰지 않습니다. 상황과 질문을 넣으면 선택지마다 확률을 붙여 돌려줍니다2. 회사는 이런 결정형 질문에서 Jev 가 최신 대형 언어 모델(LLM)보다 최대 200배 빠르다고 밝혔습니다3. 그런데 다른 공개 모델로 같은 원리를 구현했다는 글도 여럿 나왔습니다. 그래서 질문이 생깁니다. Jev 는 새로 나온 AI 일까요, 원래 있던 방법에 새 이름을 붙인 것일까요. 자료를 따라가 보니 둘 중 하나를 고르는 질문이 아니었습니다. 둘 다 맞습니다. 답은 「무엇을 새것으로 치느냐」에 따라 달라집니다. 이 글은 회사 발표문과 구현 사례를 나란히 놓고, 무엇이 새로운지 봅니다.
- Jev 는 실제로 나온 새 제품입니다. TypeSafe AI 가 9월 15일 공개했습니다. 글을 쓰는 대신 선택지마다 확률을 붙여 돌려줍니다. 회사는 새 모델 구조와 RLCD 라는 학습법을 만들었다고 밝혔습니다.
- 핵심 원리는 원래 있던 방법입니다. 언어 모델이 선택지마다 매기는 점수를 읽어 확률로 바꾸는 방식입니다. 같은 원리를 다른 모델로 구현한 사례가 세 건 확인됐습니다. 그중 둘은 검증 실험이라기보다 시연입니다. 다만 그중 한 회사의 실험에서도 비용은 Jev 쪽이 낮았습니다.
- 「최대 200배 빠르다」는 회사가 자기 평가로 잰 숫자입니다. 독립 측정을 모은 한 정리 글에서는 속도 차이가 0.5~12.1배였습니다. 새것인지 묻기 전에 누가 쟀는지부터 보는 편이 정확합니다.
Jev 는 글을 쓰지 않고, 선택지에 확률을 붙입니다
챗GPT 는 다음에 올 글자 조각을 하나씩 골라 문장을 이어 갑니다. 「AI는 어떻게 작동하나」 1편에서 본 방식입니다. Jev 는 이렇게 글을 이어 쓰지 않습니다.
테크 매체 마크테크포스트(MarkTechPost)는 Jev 를 이렇게 설명했습니다. 트랜스포머를 바탕으로 만들었지만 대형 언어 모델은 아닙니다. 글을 생성하지도 않습니다. 상황과 형식이 정해진 질문을 보내면 확률이 붙은 결정을 돌려줍니다. 프로그램은 그 결정을 보고 다음 동작을 정할 수 있습니다2. 가령 선택지가 셋인 질문을 보내면, 문장 대신 선택지마다 확률이 붙은 답이 돌아옵니다.
회사는 새 모델 구조와 병렬 샘플러를 만들었다고 밝혔습니다. 학습법에는 RLCD(보정된 결정을 위한 강화학습)라는 이름을 붙였습니다1. 위키백과에도 TypeSafe AI 가 만든 독점 AI 모델이라고 소개하는 문서가 올라 있습니다1. 그러니 회사 설명대로라면 Jev 는 제품으로서는 새로 나온 AI 입니다.
「200배 빠르다」는 회사가 직접 잰 숫자입니다
숫자부터 보겠습니다. 위키백과는 Jev 가 40~200배 빠르고 40~400배 싸다고 적었습니다. 회사 홈페이지는 「193.6배 빠르고 444.6배 싸다」고 내걸었습니다. 회사 발표문은 40~200배라는 값을 결정형 질문(System One 형태 질문)에 한정해 적었습니다. 응답 시간은 Jev 가 0.07~0.5초, 최신 대형 모델이 3~329초라고 회사는 밝혔습니다3.
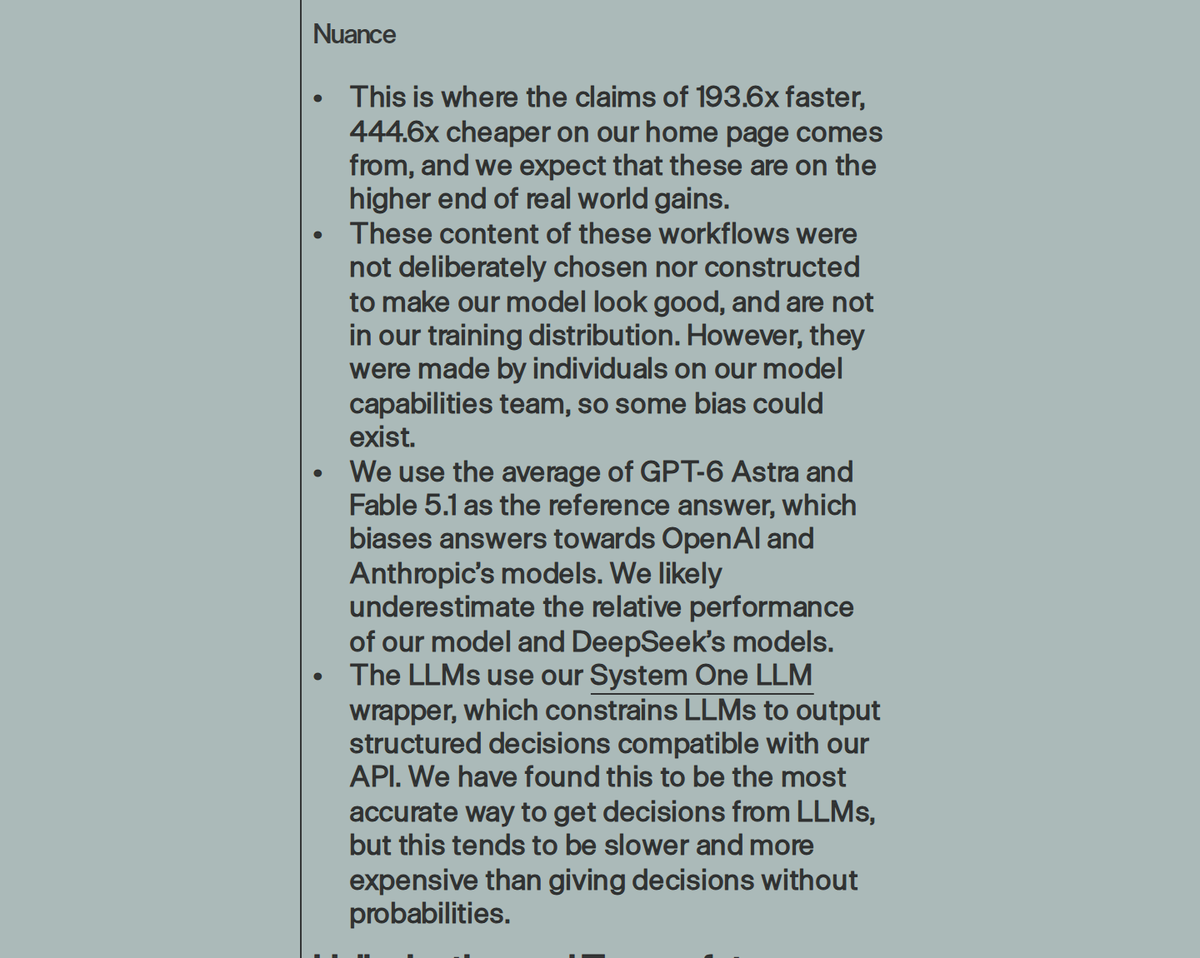
이 숫자는 누가 쟀을까요. 회사 발표문이 직접 답합니다. 발표문은 자사 모델 역량 팀 사람들이 평가를 만들었으니 편향이 있을 수 있다고 적었습니다. 공개한 평가는 대개 미국 서부(West Coast)에서 직원 노트북으로 돌렸다고 합니다. 실제로 얻을 수 있는 이득 가운데 높은 수준의 수치라는 설명도 붙였습니다4.
정답 기준도 스스로 밝혔습니다. GPT-6 Astra 와 Fable 5.1 이 낸 답의 평균이고, 그래서 오픈AI 와 앤트로픽 모델 쪽으로 기운다고 적었습니다. 비교한 LLM 에는 자사가 만든 래퍼(wrapper·감싸는 프로그램)를 씌웠습니다. 이 방식은 확률 없이 결정만 낼 때보다 느리고 비싼 편이라고도 적었습니다4.
마크테크포스트도 이 숫자를 「TypeSafe 팀의 주장」이라고 적었습니다. 회사 자체 워크플로 평가에서 나온 값이라는 점도 짚었습니다3. 회사와 같은 조건으로 다시 잰 기록은 이번 조사에서 찾지 못했습니다. 다만 여러 사람이 각자 다른 조건으로 잰 결과를 모은 개발자 커뮤니티 글(dev.to)은 있습니다. 비교 모델, 네트워크 경로, 시간을 잰 위치에 따라 속도는 0.5배(오히려 느림)에서 12.1배, 비용은 0.6배(오히려 비쌈)에서 478배까지 벌어졌다고 정리했습니다5.
「할루시네이션(환각) 0%」라는 표기도 같은 결입니다. 회사는 이 0%가 실측값이 아니라고 적었습니다. 정해진 형식대로만 답이 나오도록 보장했기 때문에 0%라고 적었다는 설명입니다6. 그러니 이 0%는 형식을 벗어난 답이 안 나온다는 뜻으로 읽어야 합니다.
같은 원리를 다른 모델로 구현한 사례가 셋 나왔습니다
원리 자체는 어렵지 않습니다. 언어 모델은 다음 조각을 고르기 전에 후보마다 점수를 매깁니다. 이 시리즈 5편에서 본 대로입니다. 설계하는 쪽은 선택지를 「A·B·C」처럼 조각 하나로 답하게 만듭니다. 그다음 글을 이어 쓰게 하지 않고, 그 점수만 읽어 확률로 바꾸면 됩니다.
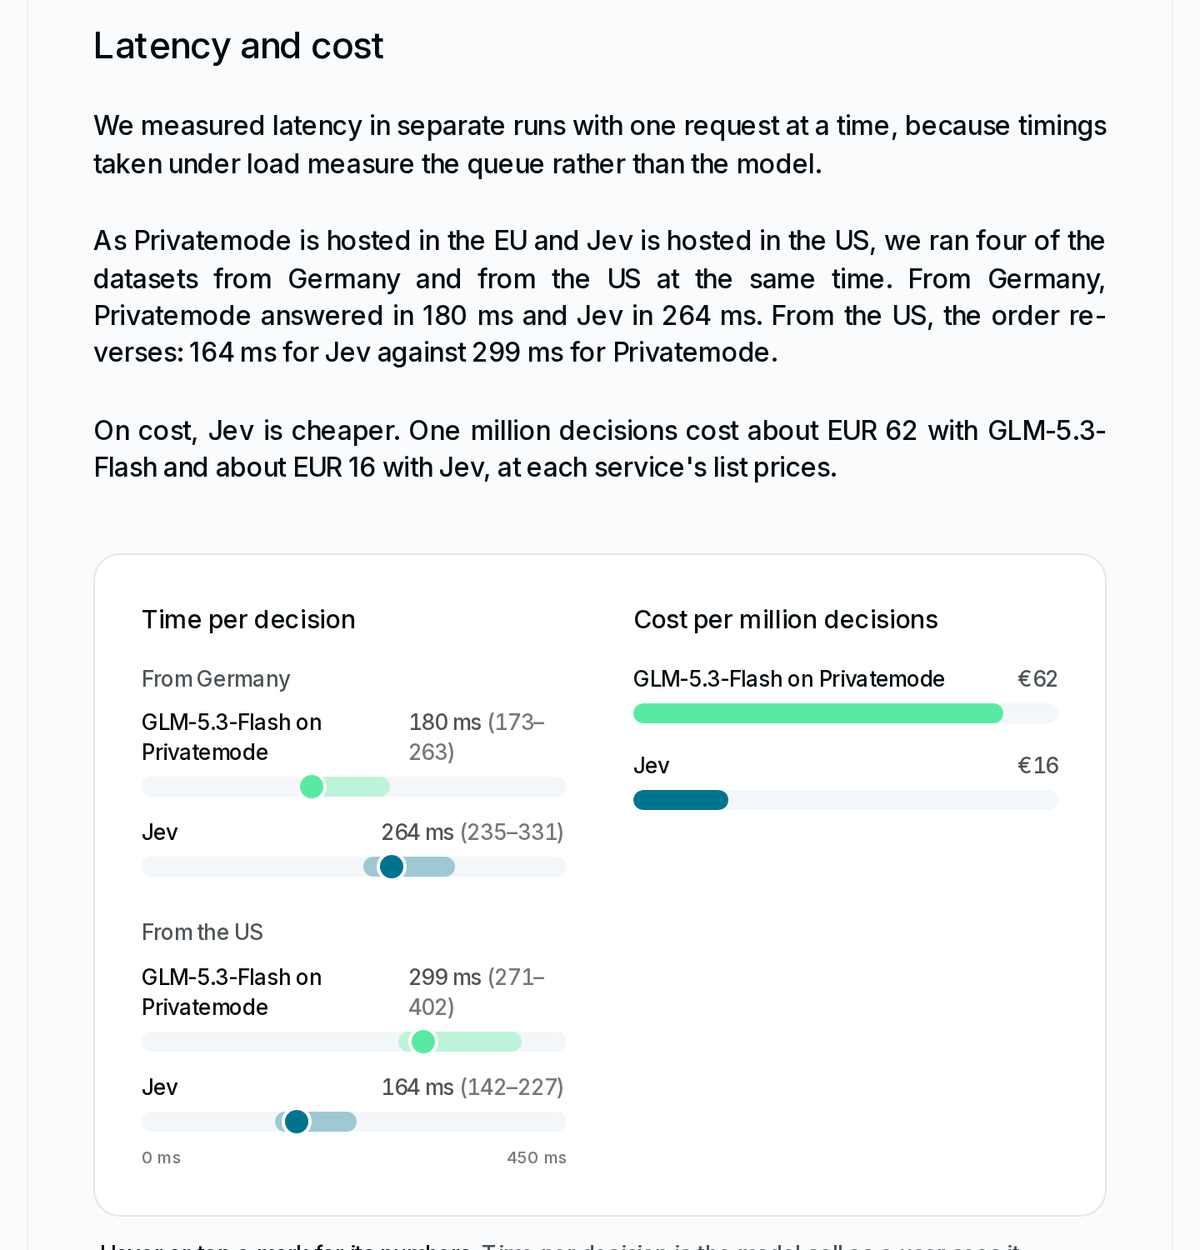
첫 번째는 Privatemode(에지리스 시스템즈)가 블로그에 올린 기록입니다. 공개 모델 GLM-5.3-Flash 로 Jev 의 원리를 따라 했습니다. 프롬프트 끝에 「choice_index:」라는 머리말을 붙입니다. 그리고 한 번의 계산에서 다음 조각의 점수만 읽습니다. 구현 코드도 공개했습니다7.
결과는 한쪽으로만 기울지 않았습니다. 공개 데이터셋 28개로 시험한 결과는 Jev 와 대등했다고 적었습니다. 독일에서 잰 응답 시간은 GLM 방식이 0.18초, Jev 가 0.264초였습니다. 반면 판단 백만 번에 드는 비용은 Jev 가 GLM 방식의 4분의 1 정도였습니다7. 원리는 따라 했지만 비용에서는 Jev 가 앞섰습니다.
두 번째는 개인 블로그 nobodywho.ai 의 「25줄 파이썬으로 만든 Jev」입니다. 글쓴이는 스스로 패러디라고 밝혔습니다. 작은 공개 모델 Qwen3-0.6B 로 피싱 메일 예시 한 통을 분류했습니다. 결과는 피싱 88.5%, 스팸 8.4%, 정상 3.1%처럼 선택지별 확률로 나왔습니다. RLCD 학습도, API 호출도, 합성 데이터도 쓰지 않았다고 적었습니다8. 이 글이 보여 주는 것은 선택지 점수를 읽는 원리가 짧은 코드로도 돌아간다는 점입니다. 예시 한 통의 결과라, RLCD 로 다듬었다는 확률의 품질까지 같은지는 알 수 없습니다.
세 번째는 이 방식을 이미지까지 넓힌 사례입니다. 개발자 뉴스 사이트 news.hada.io 가 한 개인 개발자의 글을 요약했습니다. 이 개발자는 질문과 A·B·C 같은 글자 선택지를 주고, 답에 해당하는 글자만 생성하게 한 뒤 확률을 읽는 래퍼를 만들었습니다. 이미지를 읽는 비전 모델에도 같은 방식을 썼습니다. 화면 한 장마다 질문 세 개를 처리했을 때, RTX 3090 그래픽카드에서 돌린 Gemma 4 12B 모델은 약 1FPS(초당 한 장꼴)였다고 합니다9.
그래서 새로운 AI 일까요 — 어디를 보느냐에 달렸습니다
비판하는 쪽의 논지는 이렇습니다. 한국어 AI 정보 매체 promppy 는 레딧 r/LocalLLaMA 커뮤니티에서 나온 지적을 정리했습니다. Jev 는 새로운 종류의 의사결정 모델이 아니라 기존 분류기 기술을 재포장한 것이라는 지적입니다. 제로샷 분류기(예시 없이 분류하는 모델), 임베딩 모델(문장을 숫자로 바꿔 비교하는 모델), 크로스 인코더(두 문장을 함께 넣어 관계를 판단하는 모델)가 수년 전부터 해 온 일이라는 것입니다10.
반대쪽에서 보면 TypeSafe 는 기법 하나만 내세운 것이 아닙니다. 회사는 새 모델 구조와 병렬 샘플러, 학습법을 만들었다고 밝혔습니다1. 원리를 따라 한 실험에서도 비용은 Jev 쪽이 낮았습니다7.
그래서 답은 어디를 보느냐에 따라 달라집니다. 언어 모델의 점수를 읽어 확률로 쓰는 방법은 전부터 있었고, 공개 모델로 구현한 사례도 나왔습니다. 달라진 것은 전용 모델 구조·병렬 샘플러·학습법을 내세워 이 일을 제품으로 파는 회사가 나왔다는 점입니다. 두 답은 서로를 부정하지 않습니다.
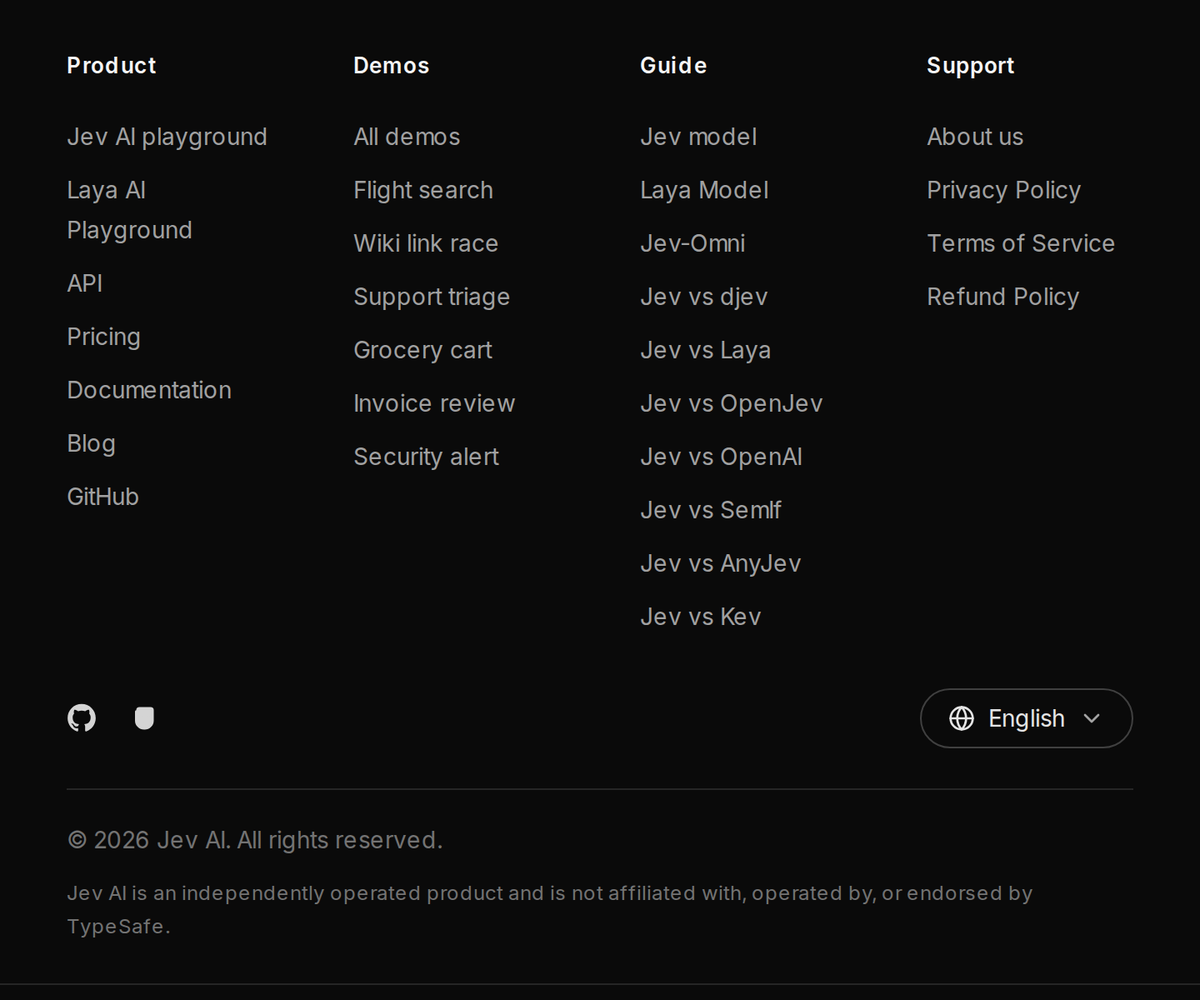
Jev 를 찾아볼 때는 출처도 확인해야 합니다. 이름이 비슷한 thejevai.com 은 사이트 하단에 이렇게 적어 두었습니다. 이 사이트는 스스로를 독립 운영 제품이라고 소개하며, TypeSafe 와 제휴·운영·보증 관계가 없다고 밝혔습니다11. 허깅페이스 커뮤니티 게시판의 한 해설 글(작성자 sora-2)도 이 사이트를 주요 출처로 적었습니다12. Jev 를 만든 회사가 발표문을 올린 곳은 typesafe.ai 입니다1.
읽고 나서 해 볼 것
다음에 「몇 배 빠르다」는 AI 소식을 보면 셋을 확인해 보세요. 누가 쟀는지, 무엇과 비교했는지, 그리고 그 링크가 만든 회사의 공식 사이트인지입니다. Jev 라면 측정 조건은 typesafe.ai 의 발표문에 회사가 직접 적어 두었습니다.
출처
각주 12개
본문의 각주 번호는 아래 항목과 1:1 로 대응합니다. 정량 주장은 가능한 경우 둘 이상의 출처로 대조했고, 인용문은 원문에서 직접 확인한 것만 실었습니다.
- TypeSafe AI 는 2026년 9월 15일 Jev 를 공개했고, 새 모델 구조·병렬 샘플러·RLCD(보정된 결정을 위한 강화학습)라는 학습법을 만들었다고 밝혔다"new model architecture, parallel sampler for maximum efficiency, and training method we call Reinforcement Learning for Calibrated Decisions (RLCD)"https://typesafe.ai/blog/introducing-system-one-models-and-jev확인 2026-09-28"proprietary artificial intelligence model developed by TypeSafe AI" / 출시일 "September 15, 2026"https://en.wikipedia.org/wiki/Jev_(AI_model)확인 2026-09-28↩
- Jev 는 트랜스포머 기반이지만 대형 언어 모델이 아니고 글을 생성하지 않으며, 상태와 형식이 정해진 질문을 받아 코드가 분기할 수 있는 확률이 붙은 결정을 돌려준다"Jev as a frontier-intelligence function call: unstructured state in, typed probabilistic decisions out."https://typesafe.ai/blog/introducing-system-one-models-and-jev확인 2026-09-28"Jev is transformer-based, but it is not a large language model. It does not generate text. You send a state and typed questions. It returns typed decisions with probabilities that code can branch on."https://www.marktechpost.com/2026/09/19/typesafe-ai-releases-jev/확인 2026-09-28↩
- TypeSafe 는 Jev 가 최신 LLM 보다 40~200배 빠르고 40~400배 싸다고 밝혔고, 홈페이지에는 193.6배 빠르고 444.6배 싸다고 적었으며, 응답 시간은 Jev 0.07~0.5초 대 최신 모델 3~329초라고 밝혔다 — 이 값은 TypeSafe 자체 워크플로 평가에서 나왔다"End-to-end response time is 70ms-500ms" (Jev) vs "3 to 329 seconds for frontier models" (LLM) / "40x-200x faster for the same levels of frontier intelligence for System One shaped queries" / 홈페이지 수치로 "193.6x faster, 444.6x cheaper"https://typesafe.ai/blog/introducing-system-one-models-and-jev확인 2026-09-28"40 to 200 times faster and 40 to 400 times cheaper"https://en.wikipedia.org/wiki/Jev_(AI_model)확인 2026-09-28"The TypeSafe team claims it to be 193.6x faster and 444.6x cheaper. Those figures come from TypeSafe's own workflow evals."https://www.marktechpost.com/2026/09/19/typesafe-ai-releases-jev/확인 2026-09-28↩
- TypeSafe 는 발표문에서 평가를 자사 모델 역량 팀이 만들어 편향이 있을 수 있고, 대개 서부의 노트북에서 돌렸으며, 실제 이득의 높은 쪽이고, 정답 기준이 GPT-6 Astra 와 Fable 5.1 의 평균이라 오픈AI·앤트로픽 모델 쪽으로 기울며, 비교한 LLM 에 씌운 자사 래퍼가 더 느리고 비싸다고 밝혔다"our published evals are generally run from our laptops on the West Coast" / "they were made by individuals on our model capabilities team, so some bias could exist" · "the higher end of real world gains" / "We use the average of GPT-6 Astra and Fable 5.1 as the reference answer, which biases answers towards OpenAI and Anthropic's models" / "The LLMs use our System One LLM wrapper, which constrains LLMs to output structured decisions compatible with our API... this tends to be slower and more expensive than giving decisions without probabilities"https://typesafe.ai/blog/introducing-system-one-models-and-jev확인 2026-09-28"But hold on here are some things to keep in mind:" — "The reference answer is the average of GPT-6 Astra and Fable 5.1." / "TypeSafe's capabilities team wrote the workflows." / "TypeSafe says it cannot prove the price is unsubsidized."https://www.marktechpost.com/2026/09/19/typesafe-ai-releases-jev/확인 2026-09-28↩
- dev.to 의 개발자 커뮤니티 글(xbill · AWS Community Builders)은 여러 독립 측정을 모아, Jev 의 속도 이득은 0.5배~12.1배, 비용 이득은 0.6배~478배로 비교 모델·네트워크 경로·측정 위치에 따라 달랐다고 정리했다"Speed runs from 0.5x, slower than a local Gemma, to 12.1x faster; cost runs from 0.6x, dearer, to 478x cheaper, depending on the comparison model, the network path and where the clock runs."https://dev.to/aws-builders/jev-after-eight-days-of-independent-tests-level-with-mid-price-llms-behind-the-frontier-1c60확인 2026-09-28↩
- TypeSafe 는 할루시네이션 0% 표기가 실측이 아니라 답이 스키마에 맞는 것이 보장된다는 뜻이라고 밝혔다"Our number is not empirical. Schema matching is guaranteed, thus we can confidently add 0% into the plots"https://typesafe.ai/blog/introducing-system-one-models-and-jev확인 2026-09-28"'Zero hallucinations' means schema matching is guaranteed. The 0% figure is not empirical."https://www.marktechpost.com/2026/09/19/typesafe-ai-releases-jev/확인 2026-09-28↩
- Privatemode(Edgeless Systems)는 공개 모델 GLM-5.3-Flash 로 프롬프트 끝에 choice_index: 를 붙여 한 번의 계산에서 다음 토큰 점수만 읽는 방식으로 Jev 를 재현하고 코드를 공개했으며, 공개 데이터셋 28개에서 Jev 와 대등한 정확도, 독일 기준 응답 시간 GLM 180ms 대 Jev 264ms, 백만 결정당 비용 GLM 방식 약 62유로 대 Jev 약 16유로라고 적었다저장소 "edgelesssys/privatemode-decisions" (재현 코드 공개) / 핵심 기법 — 프롬프트 끝에 `choice_index:` 접두사를 붙여 단일 forward pass에서 다음 토큰의 로짓만 읽는 방식 / 지연시간 — 독일 기준 GLM-5.3-Flash 180ms vs Jev 264ms (미국 기준 GLM 299ms — 위치에 따라 다름) / 비용 — 백만 결정당 GLM-5.3-Flash 방식 약 62유로 vs Jev 약 16유로 / 28개 공개 데이터셋 테스트에서 Jev와 대등한 정확도, 스캔 문서 분류 70.2% 정확도(이미지 입력 지원)https://privatemode.ai/blog/system-one-from-glm-flash확인 2026-09-28↩
- nobodywho.ai 의 「Jev in 25 lines of Python」은 스스로 패러디라고 밝힌 글로, RLCD 학습·API 호출·합성 데이터 없이 Qwen3-0.6B 의 선택지 토큰 점수를 읽어 피싱 메일을 피싱 88.5%·스팸 8.4%·정상 3.1% 로 분류했다"(note: this is a parody blog post...)" / "logits = model.scores[model.n_tokens - 1]... logprobs = choice_logits - numpy.logaddexp.reduce(choice_logits)" / "We didn't call it a System One decision model... We didn't call an API... We didn't create synthetic data... We didn't train with RLCD" / 사용 모델 — Qwen/Qwen3-0.6B-GGUF(경량 양자화 모델), 피싱 이메일 분류 예시(피싱 88.5%·스팸 8.4%·정상 3.1%)https://www.nobodywho.ai/posts/jev-in-25-lines/확인 2026-09-28↩
- news.hada.io 의 요약에 따르면 한 개인 개발자는 질문과 A/B/C 선택지를 주고 답에 해당하는 문자만 생성하게 한 뒤 토큰별 확률을 읽는 래퍼를 만들었고, 비전 모델에도 같은 방식을 적용했으며 프레임마다 질문 3개를 처리한 실험에서 RTX 3090 의 Gemma 4 12B 는 약 1FPS 였다"질문과 A/B/C 선택지를 주고 답에 해당하는 문자만 생성하게 한 뒤, 토큰별 확률을 읽어 분류 결과, 참일 확률, 단계별 점수를 계산함" / "비전 모델에도 같은 방식을 적용해 웹캠 영상에서 사람이 보이는지, 실내인지 실외인지, 얼마나 밝은지를 자연어 질문으로 판별함" / "프레임마다 질문 3개를 처리한 실험에서 RTX 3090의 Gemma 4 12B는 약 1FPS를 기록했으며"https://news.hada.io/topic?id=34327확인 2026-09-28↩
- promppy 는 레딧 r/LocalLLaMA 커뮤니티의 지적을 정리하며 Jev 가 새로운 종류의 의사결정 모델이 아니라 기존 분류기 기술을 재포장한 것이고, 제로샷 분류기·임베딩 모델·크로스 인코더가 수년 전부터 해 온 일이라는 지적을 전했다"Reddit의 r/LocalLLaMA 커뮤니티에서 최근 주목받는 'Jev'가 새로운 종류의 의사결정 모델이 아닌, 기존의 분류기(classifier) 기술을 재포장한 것이라는 지적이 제기되었습니다" / "이는 제로샷(zero-shot) 분류기, 임베딩 모델, 크로스 인코더 등이 이미 수년 전부터 수행해 온 기능입니다"https://www.promppy.com/item/1887141확인 2026-09-28↩
- thejevai.com 은 하단에 자신이 독립 운영 제품이며 TypeSafe 와 제휴·운영·보증 관계가 없다고 적었다"Jev AI is an independently operated product and is not affiliated with, operated by, or endorsed by TypeSafe."https://thejevai.com확인 2026-09-28↩
- 허깅페이스 커뮤니티 글 「What Is Jev AI?」는 thejevai.com 을 주요 출처로 인용했다"Primary sources: thejevai.com, Jev AI documentation, Jev AI pricing" / "The current website documentation uses POST https://thejevai.com/v1/systemone."https://huggingface.co/blog/sora-2/what-is-jev-ai-a-practical-guide-to-system-one-and확인 2026-09-28↩